模型与数据
选择模型、准备数据,并明确应用所需的上下文与响应。
TENSORBAY TOKEN FACTORY
从模型训练到生产推理,TensorBay AIFactory 将 GPU 系统、网络、存储、供电、制冷与运维整合起来,帮助团队规划 AI tokens 的生成与使用。
从模型到生产
模型处理输入并生成输出时会产生 AI tokens。每项工作负载都依赖相互连接的系统,而不是单一组件。
选择模型、准备数据,并明确应用所需的上下文与响应。
GPU 显存、架构和集群规模影响训练与推理可用的算力。
在需要模型权重、提示词和数据的系统之间传输信息。
应用发送输入并接收模型输出。上下文长度、响应规模和需求都会改变工作负载。
GPU 服务器居于核心
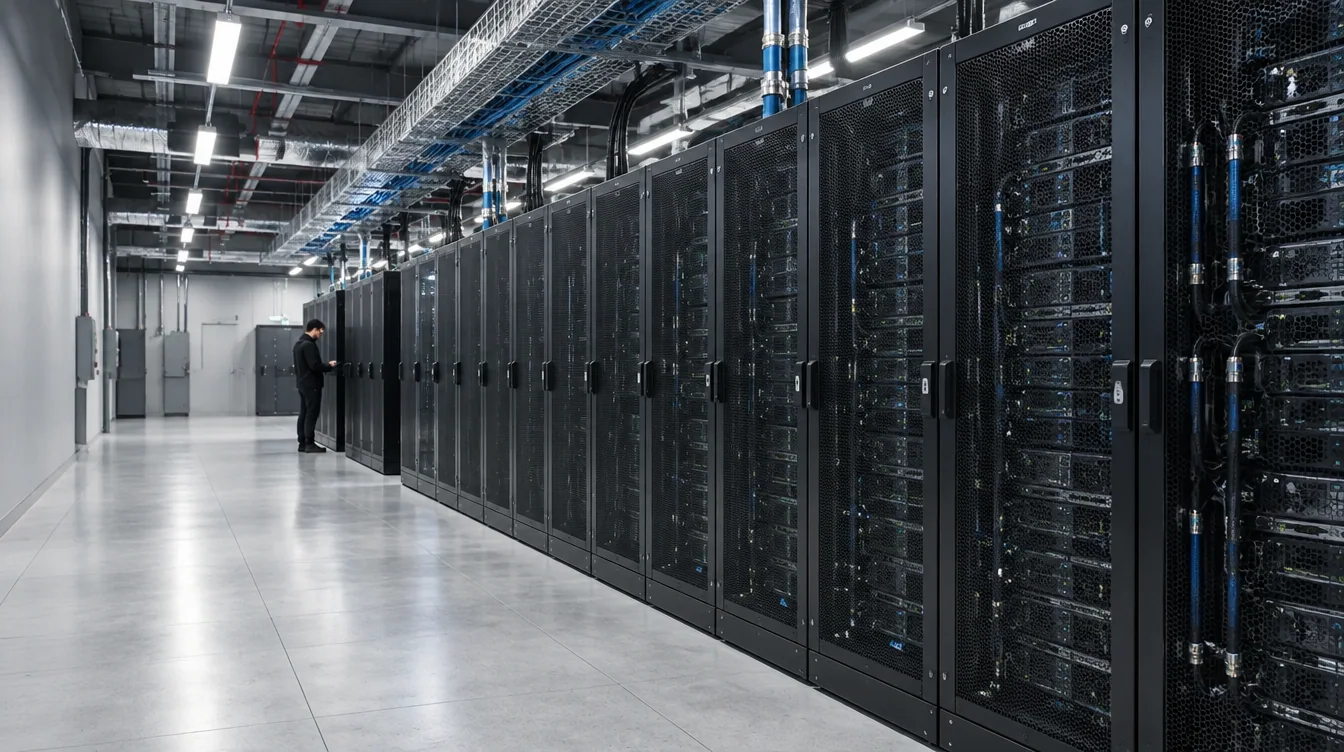
GPU 执行训练与推理工作负载。供电与制冷保障机柜运行,网络与存储则让模型和数据保持可用。您的团队在自己选择的软件栈中运行模型与应用。
GPU 算力TOKENOMICS
Token 的产出和工作负载成本取决于模型表现、基础设施、利用率与应用需求。综合规划这些因素,有助于理解生产环境中的经济关系。
没有一个适用于所有模型、提示词和部署方式的单一 token 成本。应评估完整工作负载,再根据预期使用方式匹配容量和预订期限。
模型架构、输入规模、上下文长度和输出都会影响算力需求。
GPU 显存和算力决定系统能够支持的模型与工作负载规模。
系统的持续使用情况会影响预留容量和部署周期的规划。
流量模式、响应目标和使用高峰有助于确定所需容量。
Tokenomics 指 AI tokens 生成与使用的经济关系。它综合考虑模型表现、算力、利用率和应用需求,而不是把 token 当作孤立的基础设施指标。
TensorBay 提供用于 AI 工作负载的 GPU 基础设施。您的团队可在自己选择的软件栈中运行模型和应用。
模型选择、上下文长度、GPU 架构与显存、利用率、网络和存储路径以及应用需求都会影响工作负载。
专属 GPU 系统可用于规划模型训练、微调、研究和生产推理。合适的配置取决于工作负载与交付计划。
请说明团队所在地区、数据存放地、目标部署地区和启动日期。具体数据中心、可交付 GPU 配置、网络访问方式和交付时间在项目方案中确认。部署前可按工作负载约定验收标准。
请提供具体模型版本、训练或推理目标与数据规模。结合显存、计算精度、上下文长度、并发和软件兼容性评估容量,再用实际工作负载验证延迟与吞吐。团队会根据项目需求核对可用配置。
GPU 预留费率与存储、数据传输和额外网络服务分项列出。请提供数据量、预计入站与出站流量,以及所需连接方式,并在方案中确认总费用、计费单位与税费。页面标价为美元,不是人民币。
08让创意拥有成长空间
告诉我们您的模型、token 工作负载、容量需求与时间安排,我们可以一起规划切实可行的下一步。