为你的下一次突破提供 GPU 云算力

你的雄心。我们的算力。让 AI 走向规模化。

训练更具突破性的模型,让 AI 真正投入生产。专属 NVIDIA GPU、高速网络,以及围绕业务需求打造的集群,助力你的下一步。

8 GPU 节点每小时 $19.50 起 · 年度预留合约
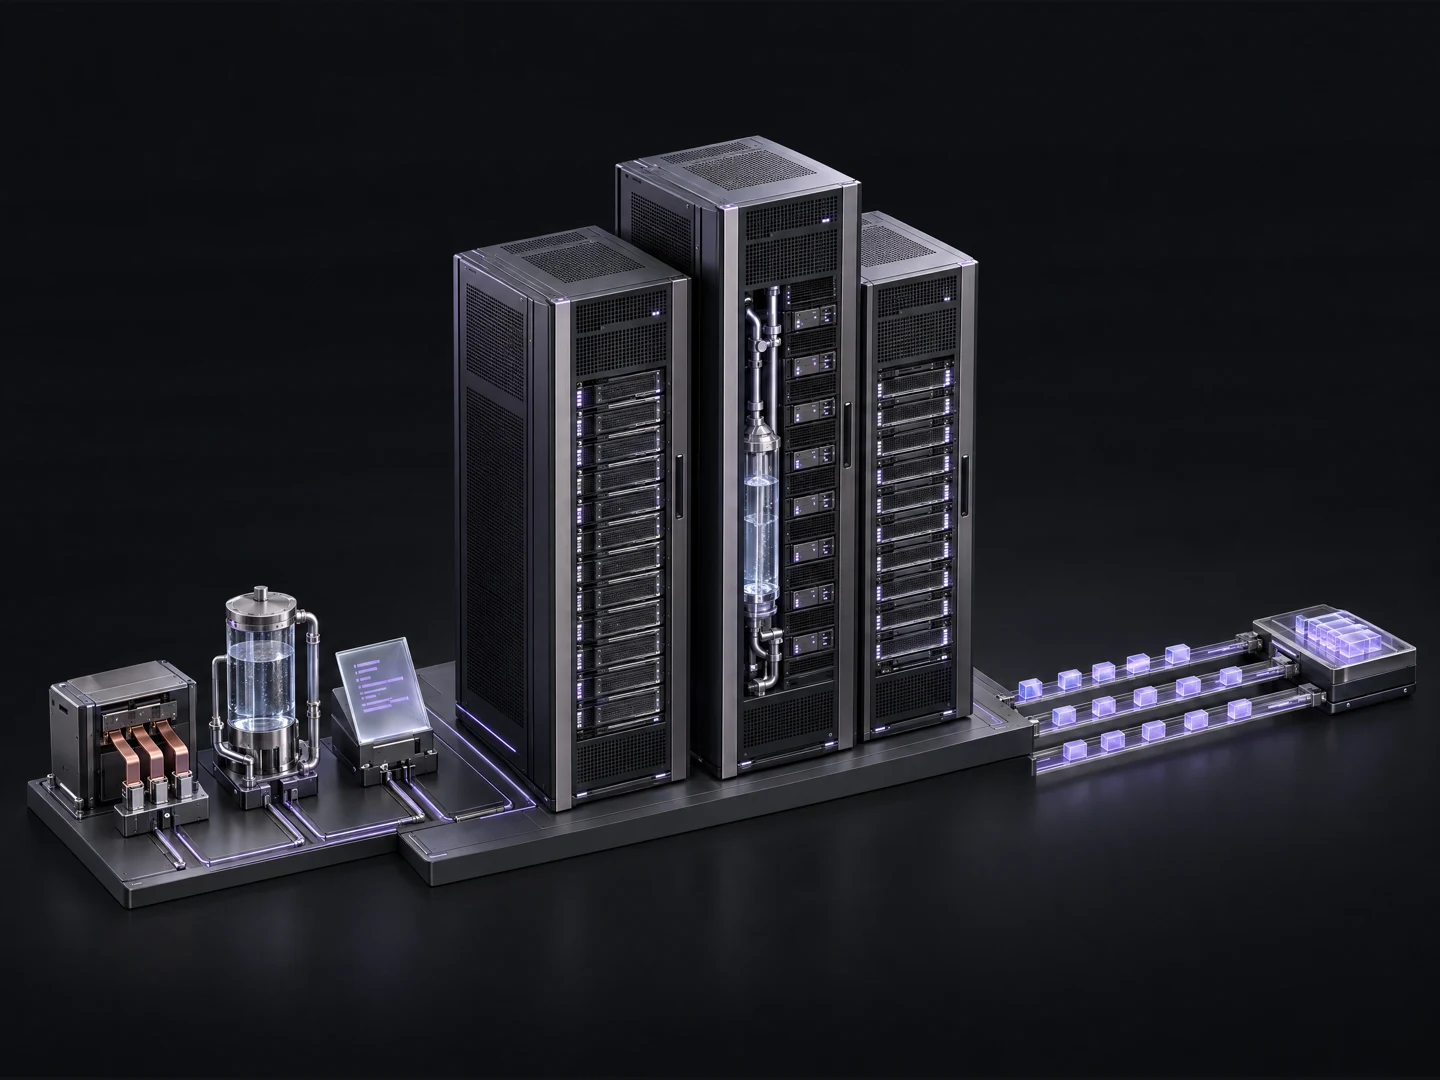
电力、人类创意与冷却系统汇入 NVIDIA GPU 集群,通过计算生成 AI tokens。
  • Qwen
  • DeepSeek
  • Llama
  • Kimi K3
为你的 AI 提供专属算力NVIDIA DGX VR200
虚拟机监控程序开销
0%
每节点 InfiniBand 带宽
3.2 Tbps
集群有效利用率,近 90 天
97.4%
五个站点的供电能力
1 GW

助力团队将 AI 转化为业务价值。

  • Bank of America
  • Halliburton
  • BRF
  • PicPay
  • BMG Bank
  • City of Rio de Janeiro
  • CNSesi
  • AICUBE
  • AirCloud

01找到适合你的算力

下一次 AI 突破,从选对 GPU 开始。

训练、微调与推理,各有不同的算力需求。根据团队、模型和预算,选择合适的配置。

查看全部价格
NVIDIA HGX

B300

为大型模型与推理提供大显存算力

288 GB HBM3e每 GPU 显存
节点配置
8 GPU · 30 TB NVMe · 2 TB RAM
节点互连
Quantum-X800 XDR 800G
查看详细配置

GPU 互连NVLink 5 · 1.8 TB/s 每 GPU

Blackwell Ultra

查看 HGX B300 详情

年度 · 预留算力

起价$58.50/节点小时

获取报价
NVIDIA HGX

H200

为长上下文模型服务提供更大显存

141 GB HBM3e每 GPU 显存
节点配置
8 GPU · 30 TB NVMe · 2 TB RAM
节点互连
8×400G IB NDR · 3.2 Tbps
查看详细配置

GPU 互连NVLink 4 · 900 GB/s

查看 HGX H200 详情

年度 · 预留算力

起价$31.20/节点小时

获取报价
NVIDIA HGX

H100

兼顾预算的训练与微调算力

80 GB HBM3每 GPU 显存
节点配置
8 GPU · 15 TB NVMe · 2 TB RAM
节点互连
8×400G IB NDR · 3.2 Tbps
查看详细配置

GPU 互连NVLink 4 · 900 GB/s

主力配置

查看 HGX H100 详情

年度 · 预留算力

起价$19.50/节点小时

获取报价

价格以美元计,按完整的 8 GPU 节点每小时收费。整机架系统单独报价,实际配置以可用容量和合约条款为准。

06从研究走向成果

下一项发现,下一款产品,下一次规模跃升。

  • 训练下一代模型

    为基础模型提供所需算力。预留集群、专属网络与备用节点,为雄心勃勃的训练任务提供基础设施支持。

    了解 GB300、GB200 与 B200
  • 让知识成为竞争优势

    让模型适应你的数据与业务挑战。专属 8 GPU 节点和持久存储,为测试、微调与持续优化提供空间。

    选择 H200 或 H100
  • 让 AI 真正投入生产

    使用大显存 GPU,将大型模型投入生产。在可规划的专属基础设施上部署长上下文应用。

    了解 B300 与 H200

02TensorBay 的优势

你带来创意与才华,我们提供坚实底座。

集群的每一层都为你的团队而设计,让算力更可控、运行更可预测,创新拥有更大空间。

  • F-01

    每一块 GPU,都服务于你的模型

    直接运行在专属硬件上,将机器算力集中用于你的工作负载。在项目的每个阶段,掌握性能主动权。

  • F-02

    真正属于你的集群

    专属节点、网络和存储,为团队提供独享的基础设施,支持训练、实验和 AI 生产部署。

  • F-03

    首次运行前,就有据可依

    集群交付前经过 72 小时的负载、显存、网络和热测试。先查看测试结果,再确认验收。

  • F-04

    按照你的方式构建

    使用自己的驱动、内核与工具。通过 Slurm、Kubernetes 或 SSH,构建适合模型需求的软件环境。

  • F-05

    把连续运行纳入规划

    同机架备用节点与 15 分钟节点更换 SLA,有助于降低硬件故障对项目的影响。

  • F-06

    让下一步决策更清晰

    公开价格,预留合约内按分钟计量,每节点每月包含 20 TB 出站流量。提前看清成本,规划业务。

03支撑雄心的基础设施

每一次突破,都需要相匹配的基础。

电力、冷却、GPU 与网络,由我们统一设计和运营,为 AI 提供可持续扩展的基础设施。

  1. 01电力

    1 GW

    已签约的电力容量覆盖五个国家,为基础设施扩展提供支持。

  2. 02冷却

    PUE 1.12

    130 kW 机架采用芯片直冷液冷技术,面向高强度 AI 工作负载设计。

  3. 03GPU 容量

    24,000+ GPUs

    以六周为周期扩展容量,每次交付前进行 72 小时测试。

  4. 04有效计算

    97.4%

    过去 90 天的集群有效利用率,即实际转化为有效计算工作的容量占比。

04网络与存储

让你的 GPU 协同发力。

从第一个训练批次到最后一个检查点,让计算、数据与存储在专属基础设施上协同运行。

规划我的集群

专属网络

为你的 GPU 打造的网络。

专属 InfiniBand 将集群连接起来,为分布式训练和 GPU 间数据交换提供带宽。

800Gb/s

每条 InfiniBand XDR 链路,Blackwell 配备 Quantum-X800

网络规格
Hopper 训练网络
每节点 8×400 Gb/s InfiniBand NDR(3.2 Tbps),采用轨道优化的无阻塞胖树拓扑,支持 SHARP 网内归约。
Blackwell 训练网络
Quantum-X800 InfiniBand XDR,每链路 800G;GB200 机架采用 72 GPU 一致性 NVLink 5 互连域,每 GPU 带宽 1.8 TB/s。
收敛比
各层均为 1:1,不与其他租户共享东西向网络或脊交换机。
前端网络
每节点双 100 GbE,提供 DDoS 防护,支持自带 IP 地址。

存储

让数据跟上计算节奏。

本地 NVMe、WEKA 和 S3 兼容存储,支持按项目规模加载数据集与保存检查点。

最高

720GB/s

采用专属 WEKA 时,每计算单元的聚合读取吞吐量

存储规格
本地临时存储
每节点 30 TB NVMe Gen5,读取速度约 55 GB/s,无需占用网络即可暂存检查点。
并行文件系统
托管 WEKA,每集群独享;每计算单元聚合读取吞吐量最高 720 GB/s,支持 POSIX 与 GPUDirect Storage。
对象存储
兼容 S3,采用 NVMe 缓存,与计算资源同站点部署;热存储每 GB 每月 $0.055。

数据传输

让数据流动更自由。

入站和节点间流量免费,并包含出站流量额度,便于提前规划运营成本。

20TB

每节点每月包含的出站流量

数据传输条款
数据传输
入站 $0,每节点每月包含 20 TB 出站流量,超额 $1.25/TB;节点间传输 $0。年度预留合约免费提供 100G Direct Connect。

网络与存储根据集群架构配置。查看价格与条款

05为下一步投入算力

算力助力增长,价格让决策更清晰。

选择预留期限,比较算力配置,规划投入。从公开透明的价格开始沟通。

美元/小时,完整的 8 GPU 节点

GPU 节点, 美元/小时,完整的 8 GPU 节点
GPU 与显存月度合约按月度合约预留算力年度合约更低的小时费率
NVIDIAHGX B300288 GB HBM3e 每 GPU
月度
起价
US$ 83.20/小时
获取月度报价
年度
起价
US$ 58.50/小时
获取年度报价
NVIDIAHGX B200180 GB HBM3e 每 GPU
月度
起价
US$ 72.80/小时
获取月度报价
年度
起价
US$ 50.70/小时
获取年度报价
NVIDIAHGX H200141 GB HBM3e 每 GPU
月度
起价
US$ 44.20/小时
获取月度报价
年度
起价
US$ 31.20/小时
获取年度报价
NVIDIAHGX H10080 GB HBM3 每 GPU
月度
起价
US$ 28.60/小时
获取月度报价
年度
起价
US$ 19.50/小时
获取年度报价

小时费率涵盖完整的 8 GPU 节点。选择预留期限,获取专属报价。

SLA
月度可用性 99.9%,15 分钟节点更换,并提供有效利用率补偿额度
规模
128–10,000+ GPU · 每租户专属网络
计费
预留合约内按分钟计量 · 入站流量 $0

每一项成本,都有据可查

看清基础设施的每一个细节。

了解包含的服务,并查看存储、数据传输与网络的收费标准。

联系算力专家
存储
  • 本地 NVMe 临时存储,每节点 30 TB已包含
  • 并行文件系统,托管 WEKA每集群独享$0.09/GB·月
  • 对象存储,S3 兼容热存储NVMe 缓存,同站点部署$0.055/GB·月
  • 对象存储,归档$0.015/GB·月
  • 快照$0.021/GB·月
数据传输
  • 入站流量始终免费$0
  • 包含的出站流量20 TB/节点·月
  • 超额出站流量所有站点$1.25/TB
  • 节点间与东西向流量InfiniBand 网络$0
网络
  • 东西向 InfiniBand 网络每集群独享已包含
  • 私有 VLAN / VPC已包含
  • 额外公网 IPv4IPv6 免费$4/IP·月
  • 自带 IP,IPv4 /24 或 IPv6 /48设置费 $200免费
  • 托管防火墙$4/节点·月
  • DDoS 防护已包含
  • Direct Connect 10G / 100G年度合约免费提供 100G$450 / $1,800/月

价格以美元计,按完整的 8 GPU HGX 节点每小时收费;机架级系统按机架报价。价格不含税,包含托管 Slurm 与 Kubernetes 控制平面。存储和 Direct Connect 按上述价格计费,可咨询长期合约方案。

获取我的方案

AI 算力采购指南

为你的模型,选对每一份算力。

从 GPU 云服务器租赁到大模型训练与推理,先明确工作负载,再比较配置与合约成本。

GPU 云服务器租赁

需要专属算力时,比较 B300、B200、H200 和 H100 的显存、节点互连与预留期限。HGX 价格按完整的 8 GPU 节点计算,月度和年度合约对应不同的小时费率。

比较 GPU 租赁价格

大模型训练与微调

提供模型参数量、训练精度、数据集规模和目标完成时间。全量训练与 LoRA 微调的资源需求不同,多节点训练还需要一起评估 GPU 间通信和存储吞吐。

了解 B300 集群配置

大模型推理部署

推理算力应结合模型权重、上下文长度、KV 缓存和并发请求规划。用自己的模型测试首 token 延迟、输出速度与吞吐,再决定 GPU 数量和服务容量。

了解 H200 推理配置
提交项目需求,获取算力方案

07安心向前

你的创新,值得可靠的安全保障。

专属硬件、物理隔离与访问控制,支持项目走向生产。从第一个节点开始,安全就是基础设施的一部分。

  • SOC 2 Type II

    范围:裸金属计算、网络与托管存储

  • ISO 27001:2022

    所有数据中心站点均已认证

  • HIPAA

    专属集群可提供业务伙伴协议(BAA)

  • GDPR

    欧盟区域提供所在国数据驻留

  • 硬件、网络与存储在物理层面专属于你的业务
  • 静态数据加密,硬件释放时安全擦除数据
  • 退役存储介质按认证流程销毁
  • 企业身份登录、硬件密钥认证与不可变审计日志
  • 通过 trust.tensorbay.com 查看认证范围与报告

常见问题

清晰规划你的下一个集群。

联系算力专家
GPU 价格按单块 GPU 还是按节点收费?

公布的 HGX 价格以美元计,按月度或年度预留合约中的完整 8 GPU 节点每小时收费。NVL72 系统按机架报价,价格不含税。

AI 项目应该选择哪款 NVIDIA GPU?

请比较显存容量、网络需求,以及训练或推理工作负载。硬件页面提供 B300、B200、H200、H100 与整机架系统。团队可根据模型、数据集与算力需求协助规划配置。

专属集群能用于训练、微调和推理吗?

可以。TensorBay 提供用于模型训练、微调和推理的专属 NVIDIA GPU 基础设施。你可以使用 Slurm、Kubernetes 或 SSH,并根据工作负载配置软件环境。

申请报价之后会发生什么?

提供所需 GPU、容量与预留期限,或介绍项目需求。团队将在评估后于 48 小时内准备方案,包括配置与交付时间,最终容量和条款在方案中确认。

询价时需要确认哪些部署与交付信息?

请说明团队所在地区、数据存放地、目标部署地区和启动日期。具体数据中心、可交付 GPU 配置、网络访问方式和交付时间在项目方案中确认。部署前可按工作负载约定验收标准。

如何规划 Qwen、DeepSeek 或 Kimi 等模型的算力?

请提供具体模型版本、训练或推理目标与数据规模。结合显存、计算精度、上下文长度、并发和软件兼容性评估容量,再用实际工作负载验证延迟与吞吐。团队会根据项目需求核对可用配置。

GPU 租赁报价是否包含数据传输与存储?

GPU 预留费率与存储、数据传输和额外网络服务分项列出。请提供数据量、预计入站与出站流量,以及所需连接方式,并在方案中确认总费用、计费单位与税费。页面标价为美元,不是人民币。

08让创意拥有成长空间

下一次 AI 突破,从一次沟通开始。

告诉我们你的挑战。团队将协助确定 GPU、容量和时间安排,并在 48 小时内提供方案,支持项目启动或进一步扩展。

  • 围绕项目定制的配置
  • 包含交付时间的方案
  • 启用前的验收测试
tensorbay@tensorbay.io