TensorBay

AI 模型训练

以专属算力,大规模训练 AI 模型。

围绕模型、数据路径和项目周期规划训练算力。专属 NVIDIA GPU、高速网络与清晰的预留价格,为团队从首次训练到生产部署提供基础。

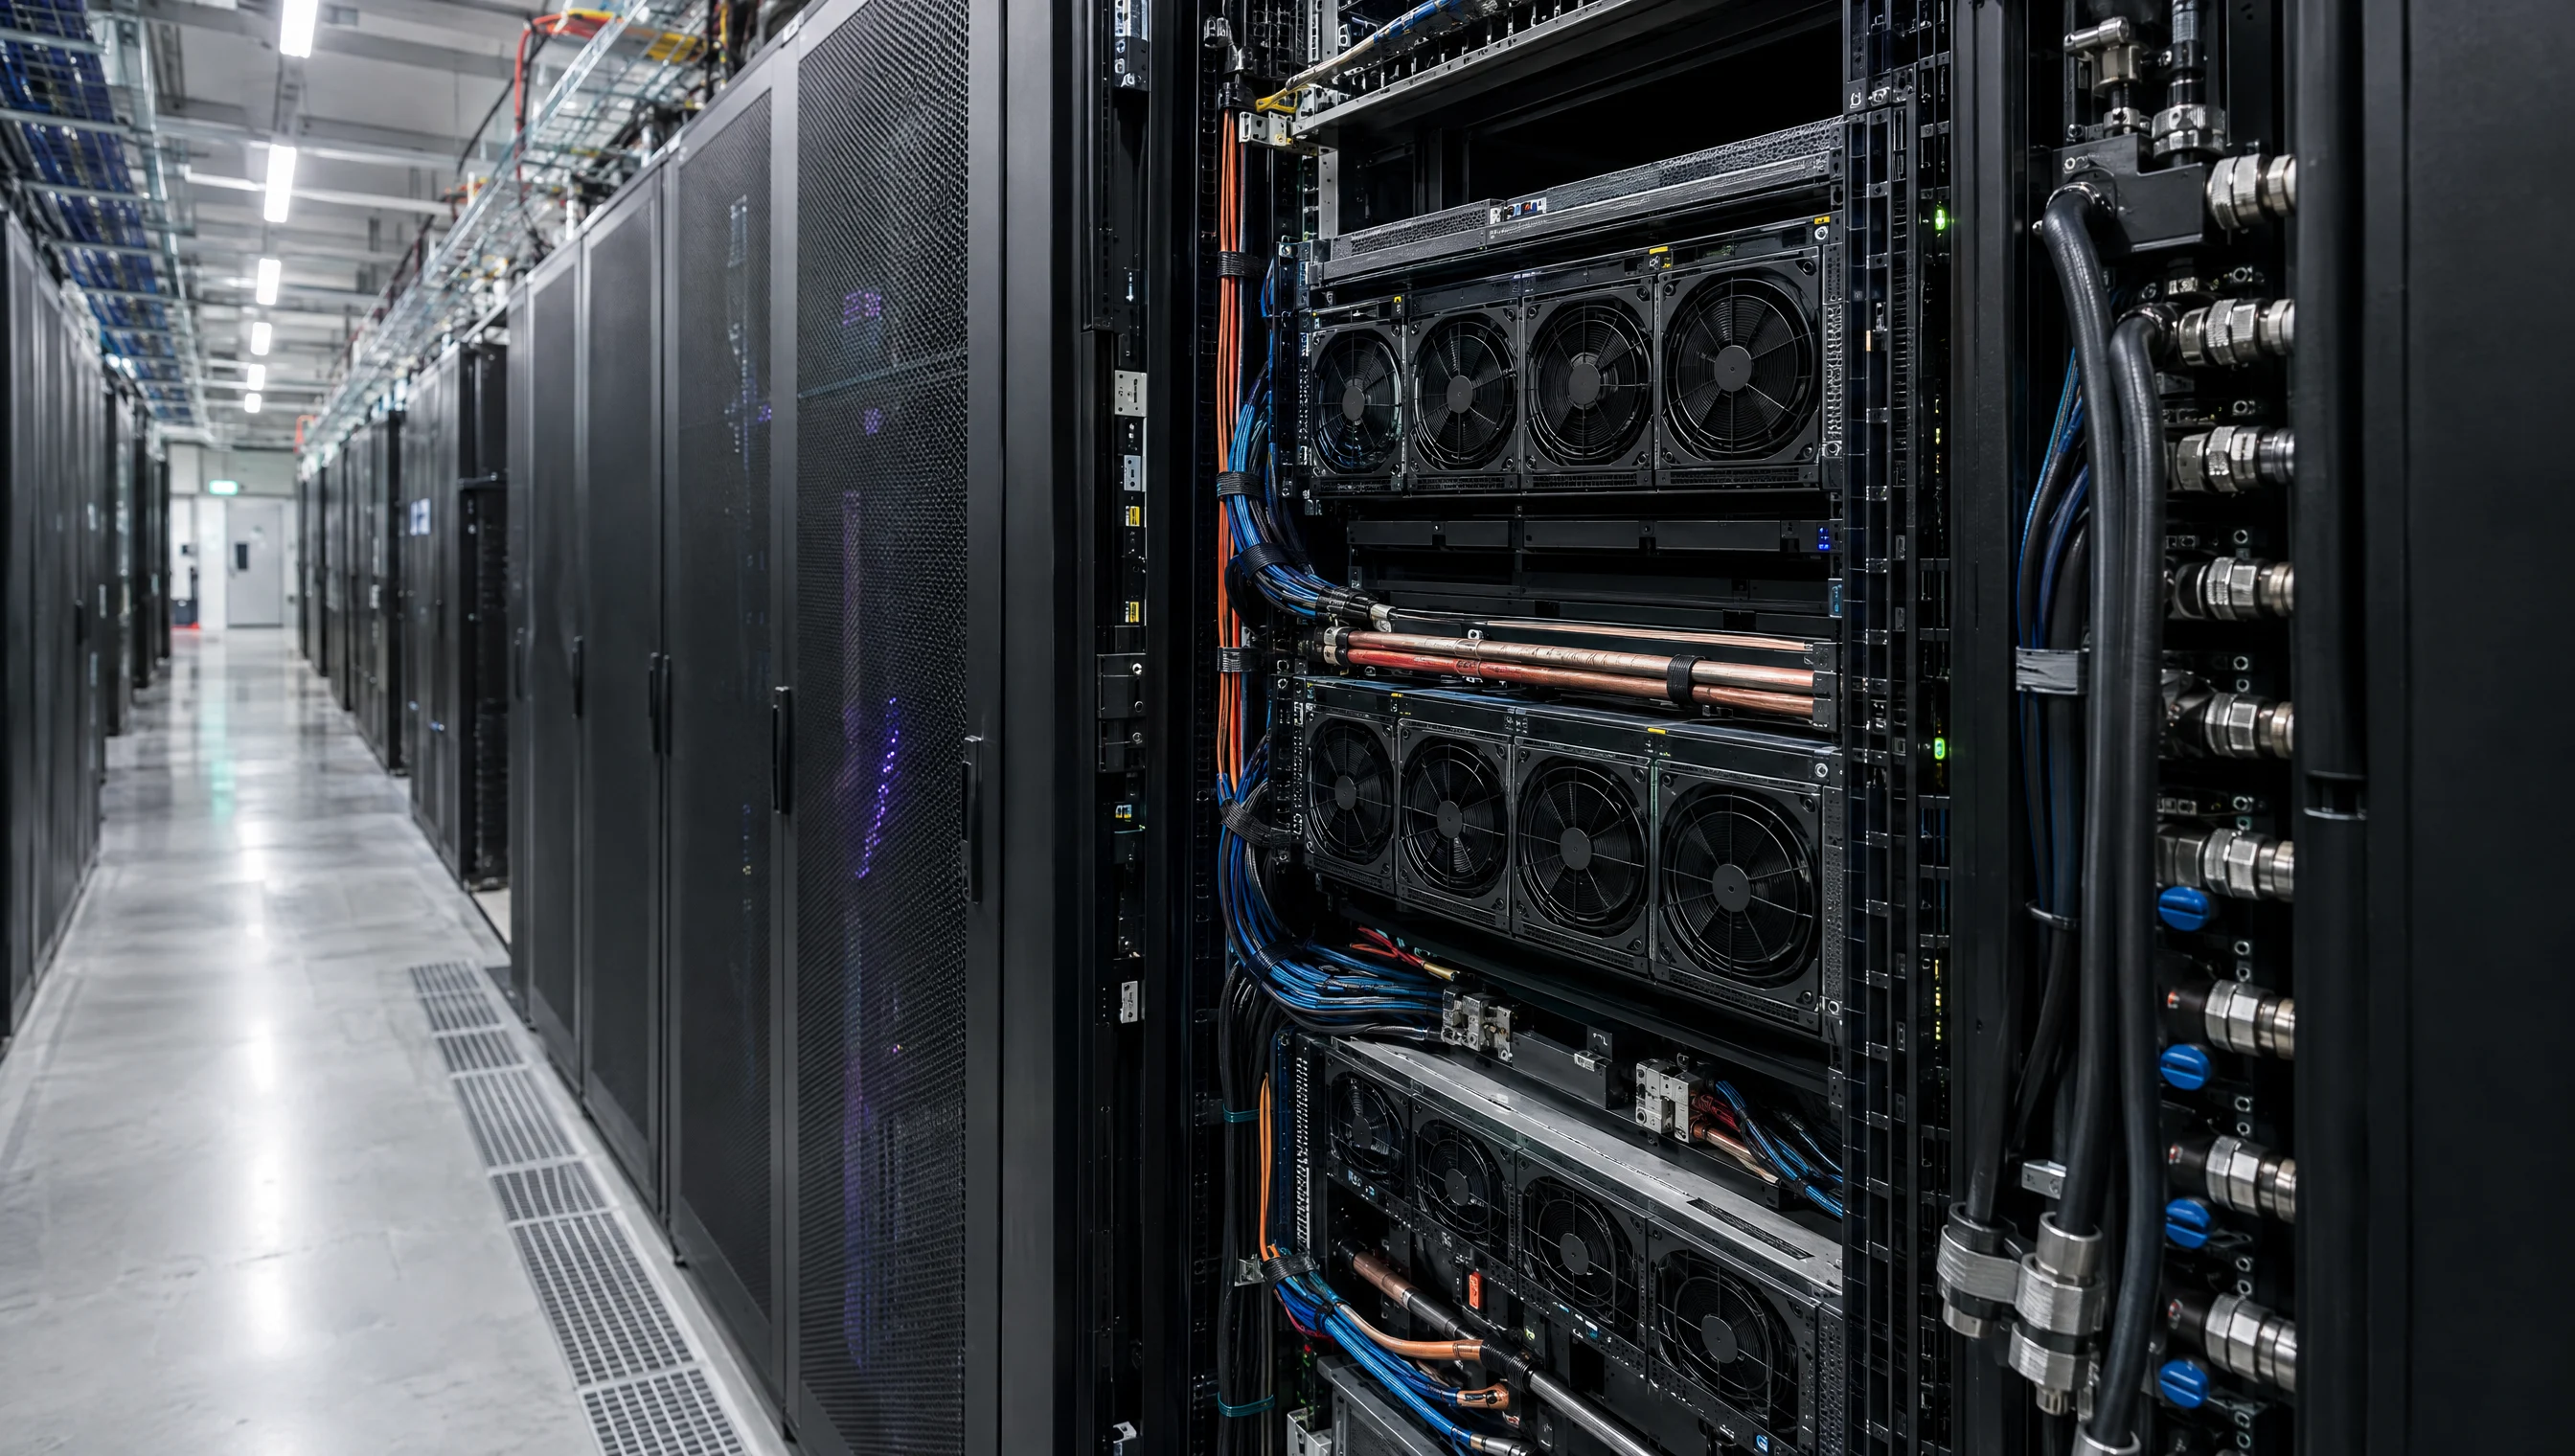
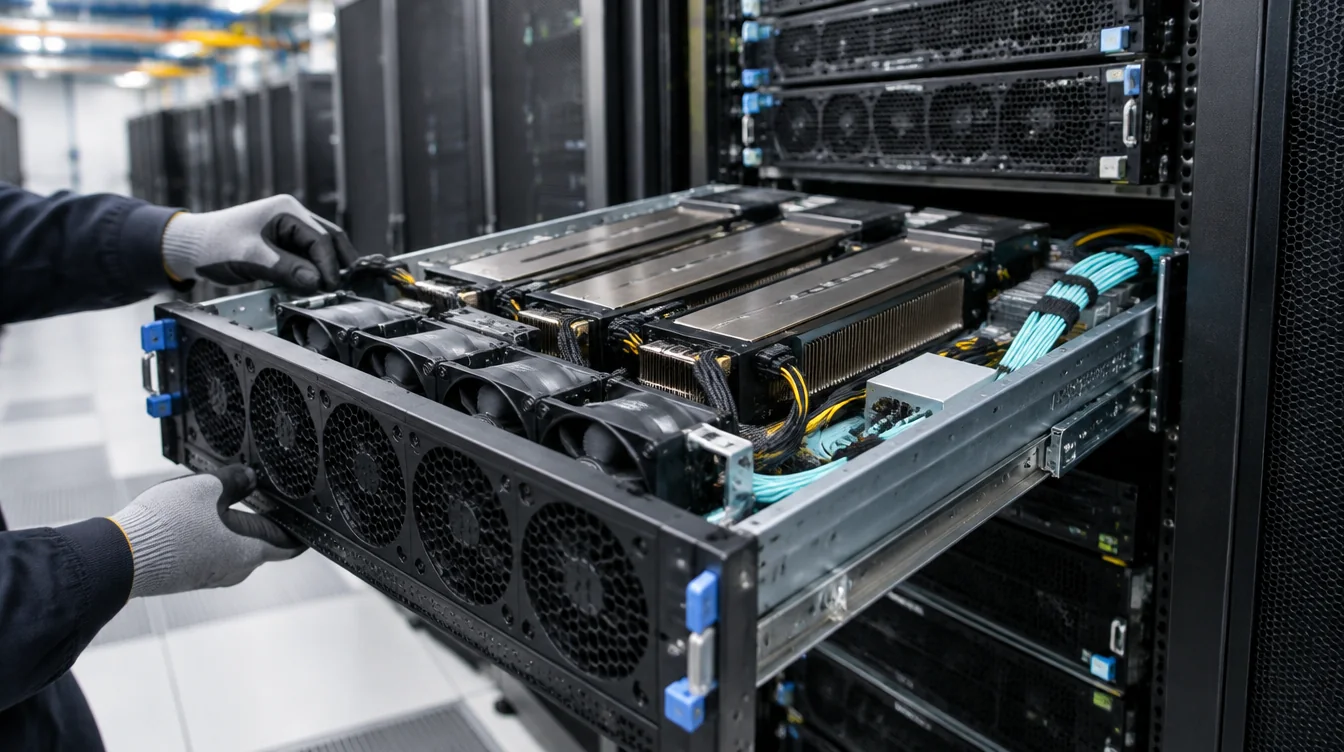
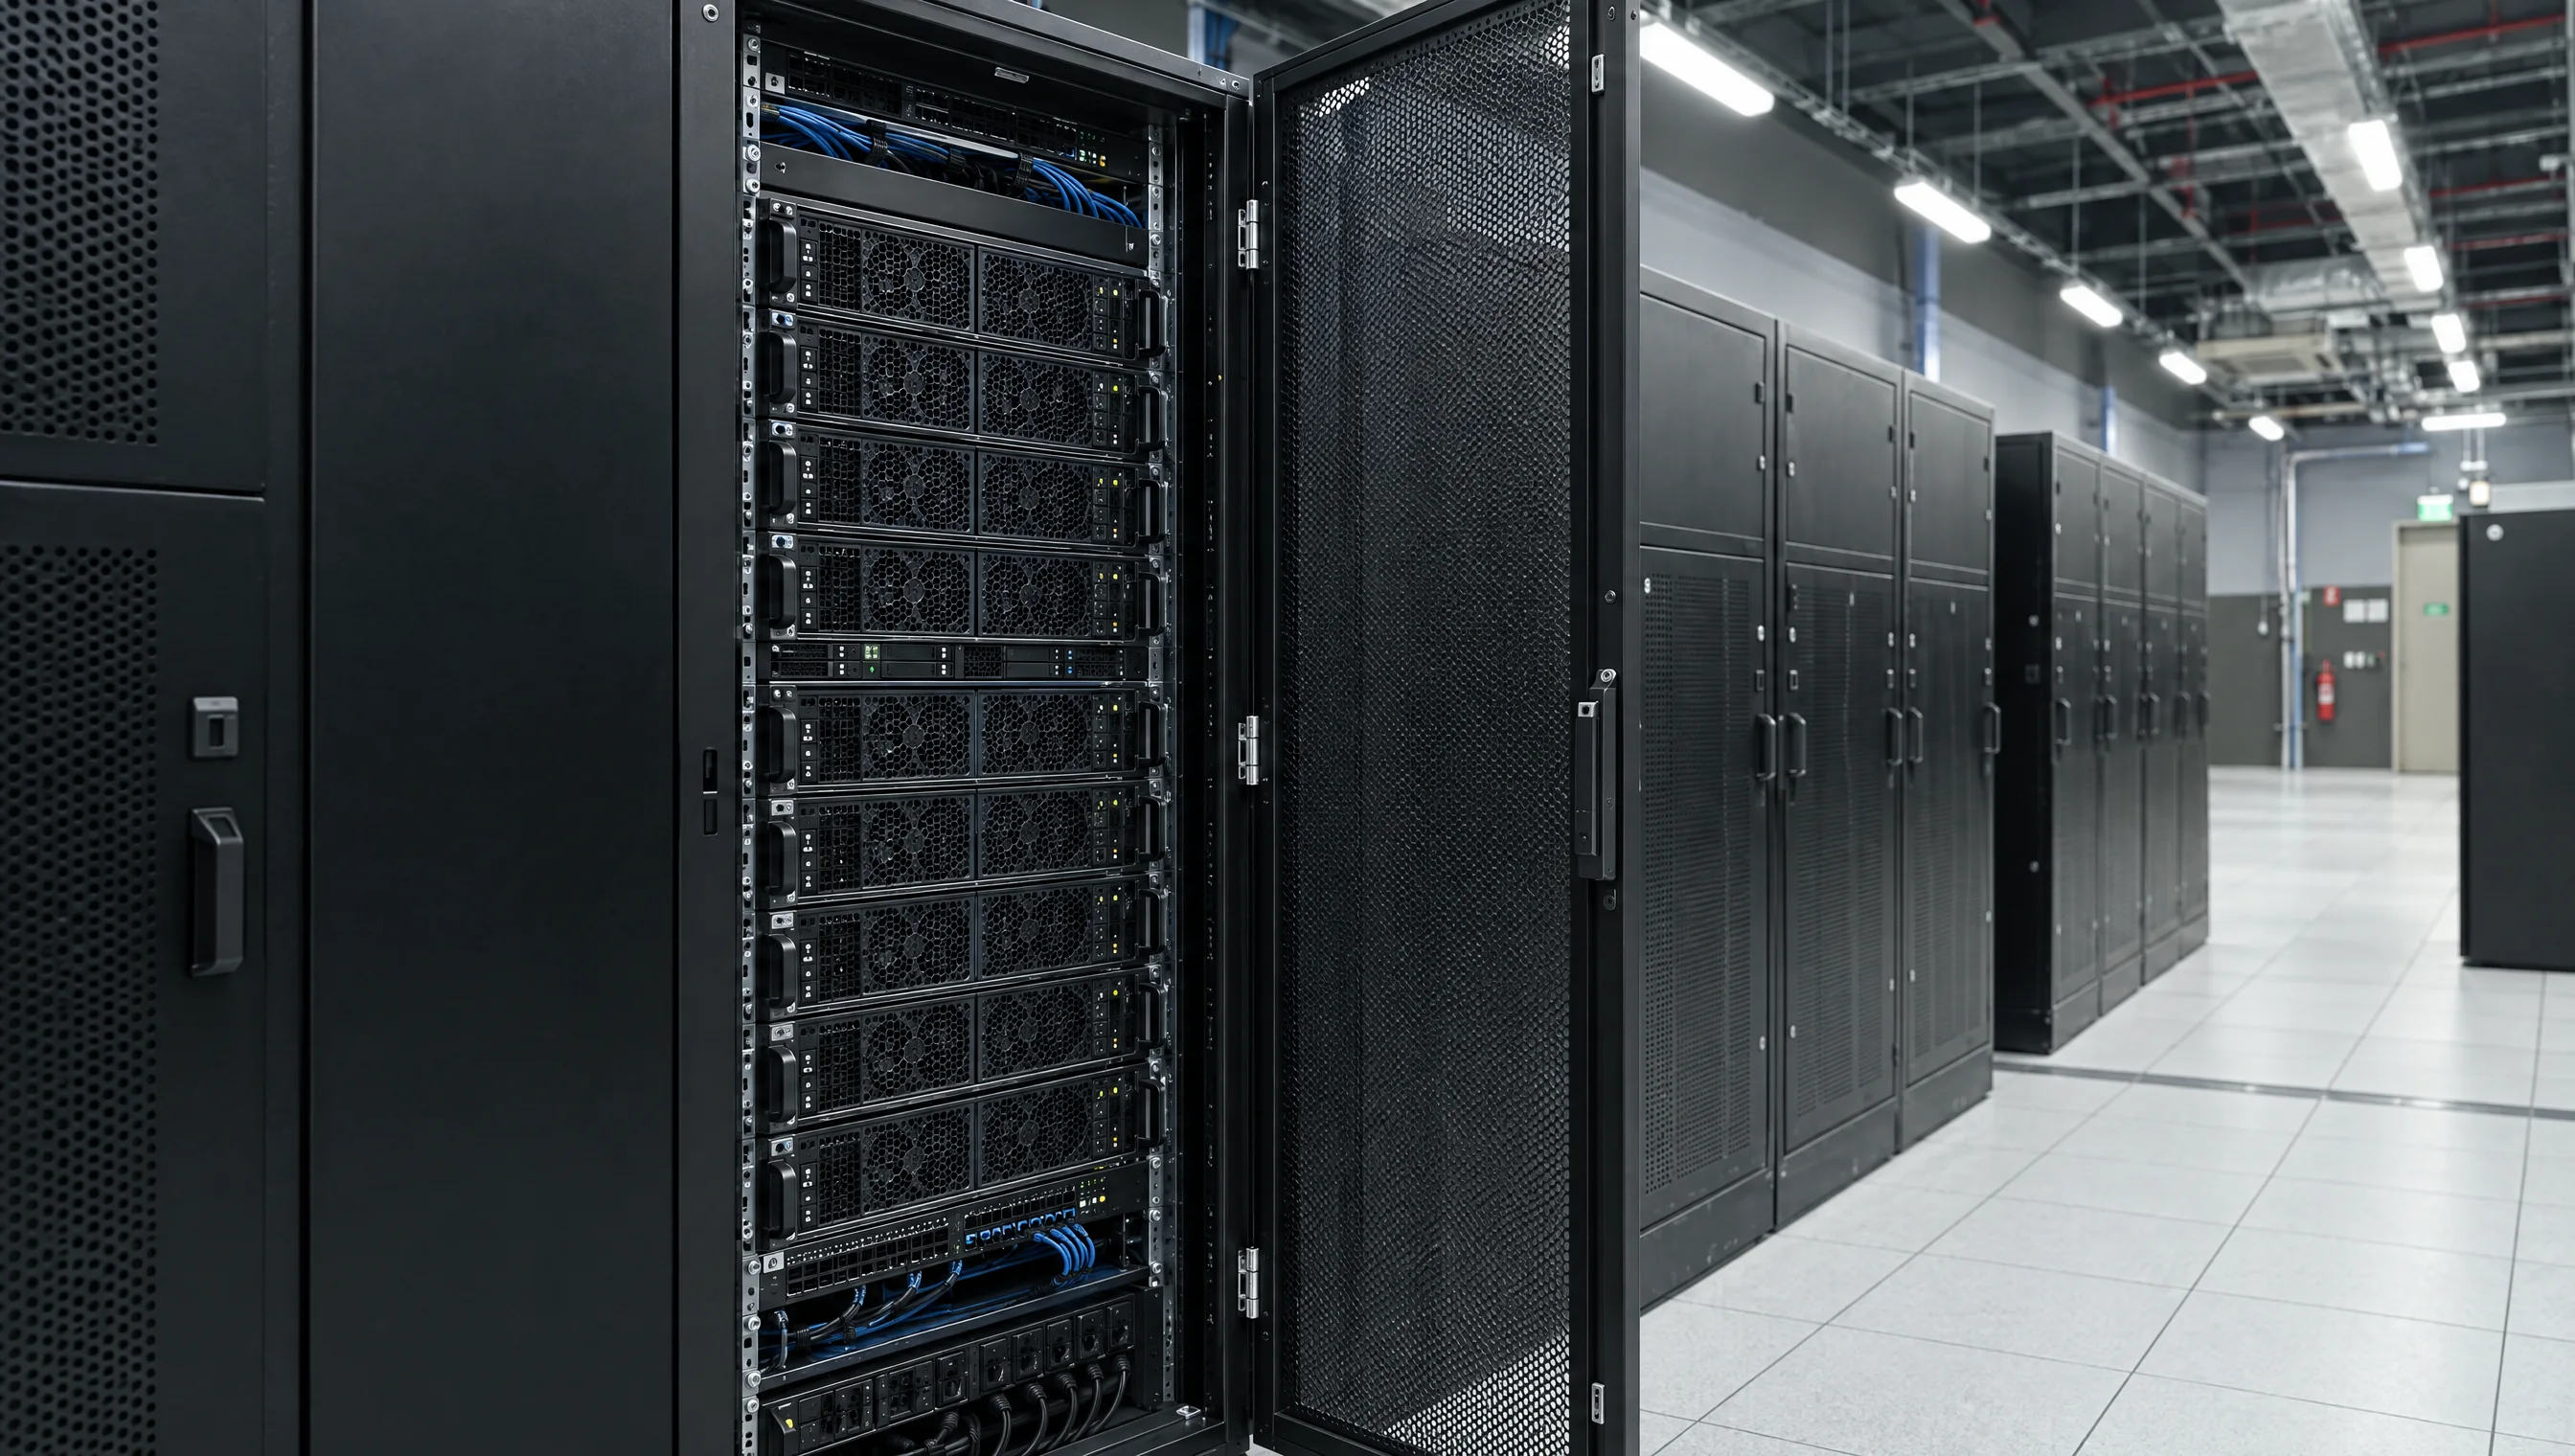
数据中心通道内开放式 GPU 服务器机柜
AI 模型训练 · GPU 集群

训练中的常见瓶颈

训练一旦变慢,进展也会停滞。

长时间训练不仅取决于 GPU 数量。数据传输、系统配置和故障恢复计划,都会影响团队测试想法并获得结果的速度。

  1. GPU 需要稳定的数据路径

    如果网络与存储分开规划,数据集和检查点可能让宝贵的 GPU 算力处于等待状态。
  2. 通用集群未必适合每个模型

    显存、互连和节点数量需要结合模型及团队的训练方式进行配置。

  3. 故障恢复也应纳入训练计划

    运行中断可能影响长时间实验。交付验收和清晰的恢复方案有助于团队规划连续性。

TensorBay 如何提供支持

让训练流程的每个环节保持连接。

  • 数据流01

    让数据靠近算力

    将网络与存储路径和 GPU 容量一起规划,让数据集和检查点符合团队的工作流程。

    了解网络与存储
  • GPU 算力02

    为模型选择合适系统

    根据显存、互连与工作负载,对比专属 8-GPU 节点和机架级配置。

    了解 GPU 系统
  • 交付验收03

    先查看测试结果

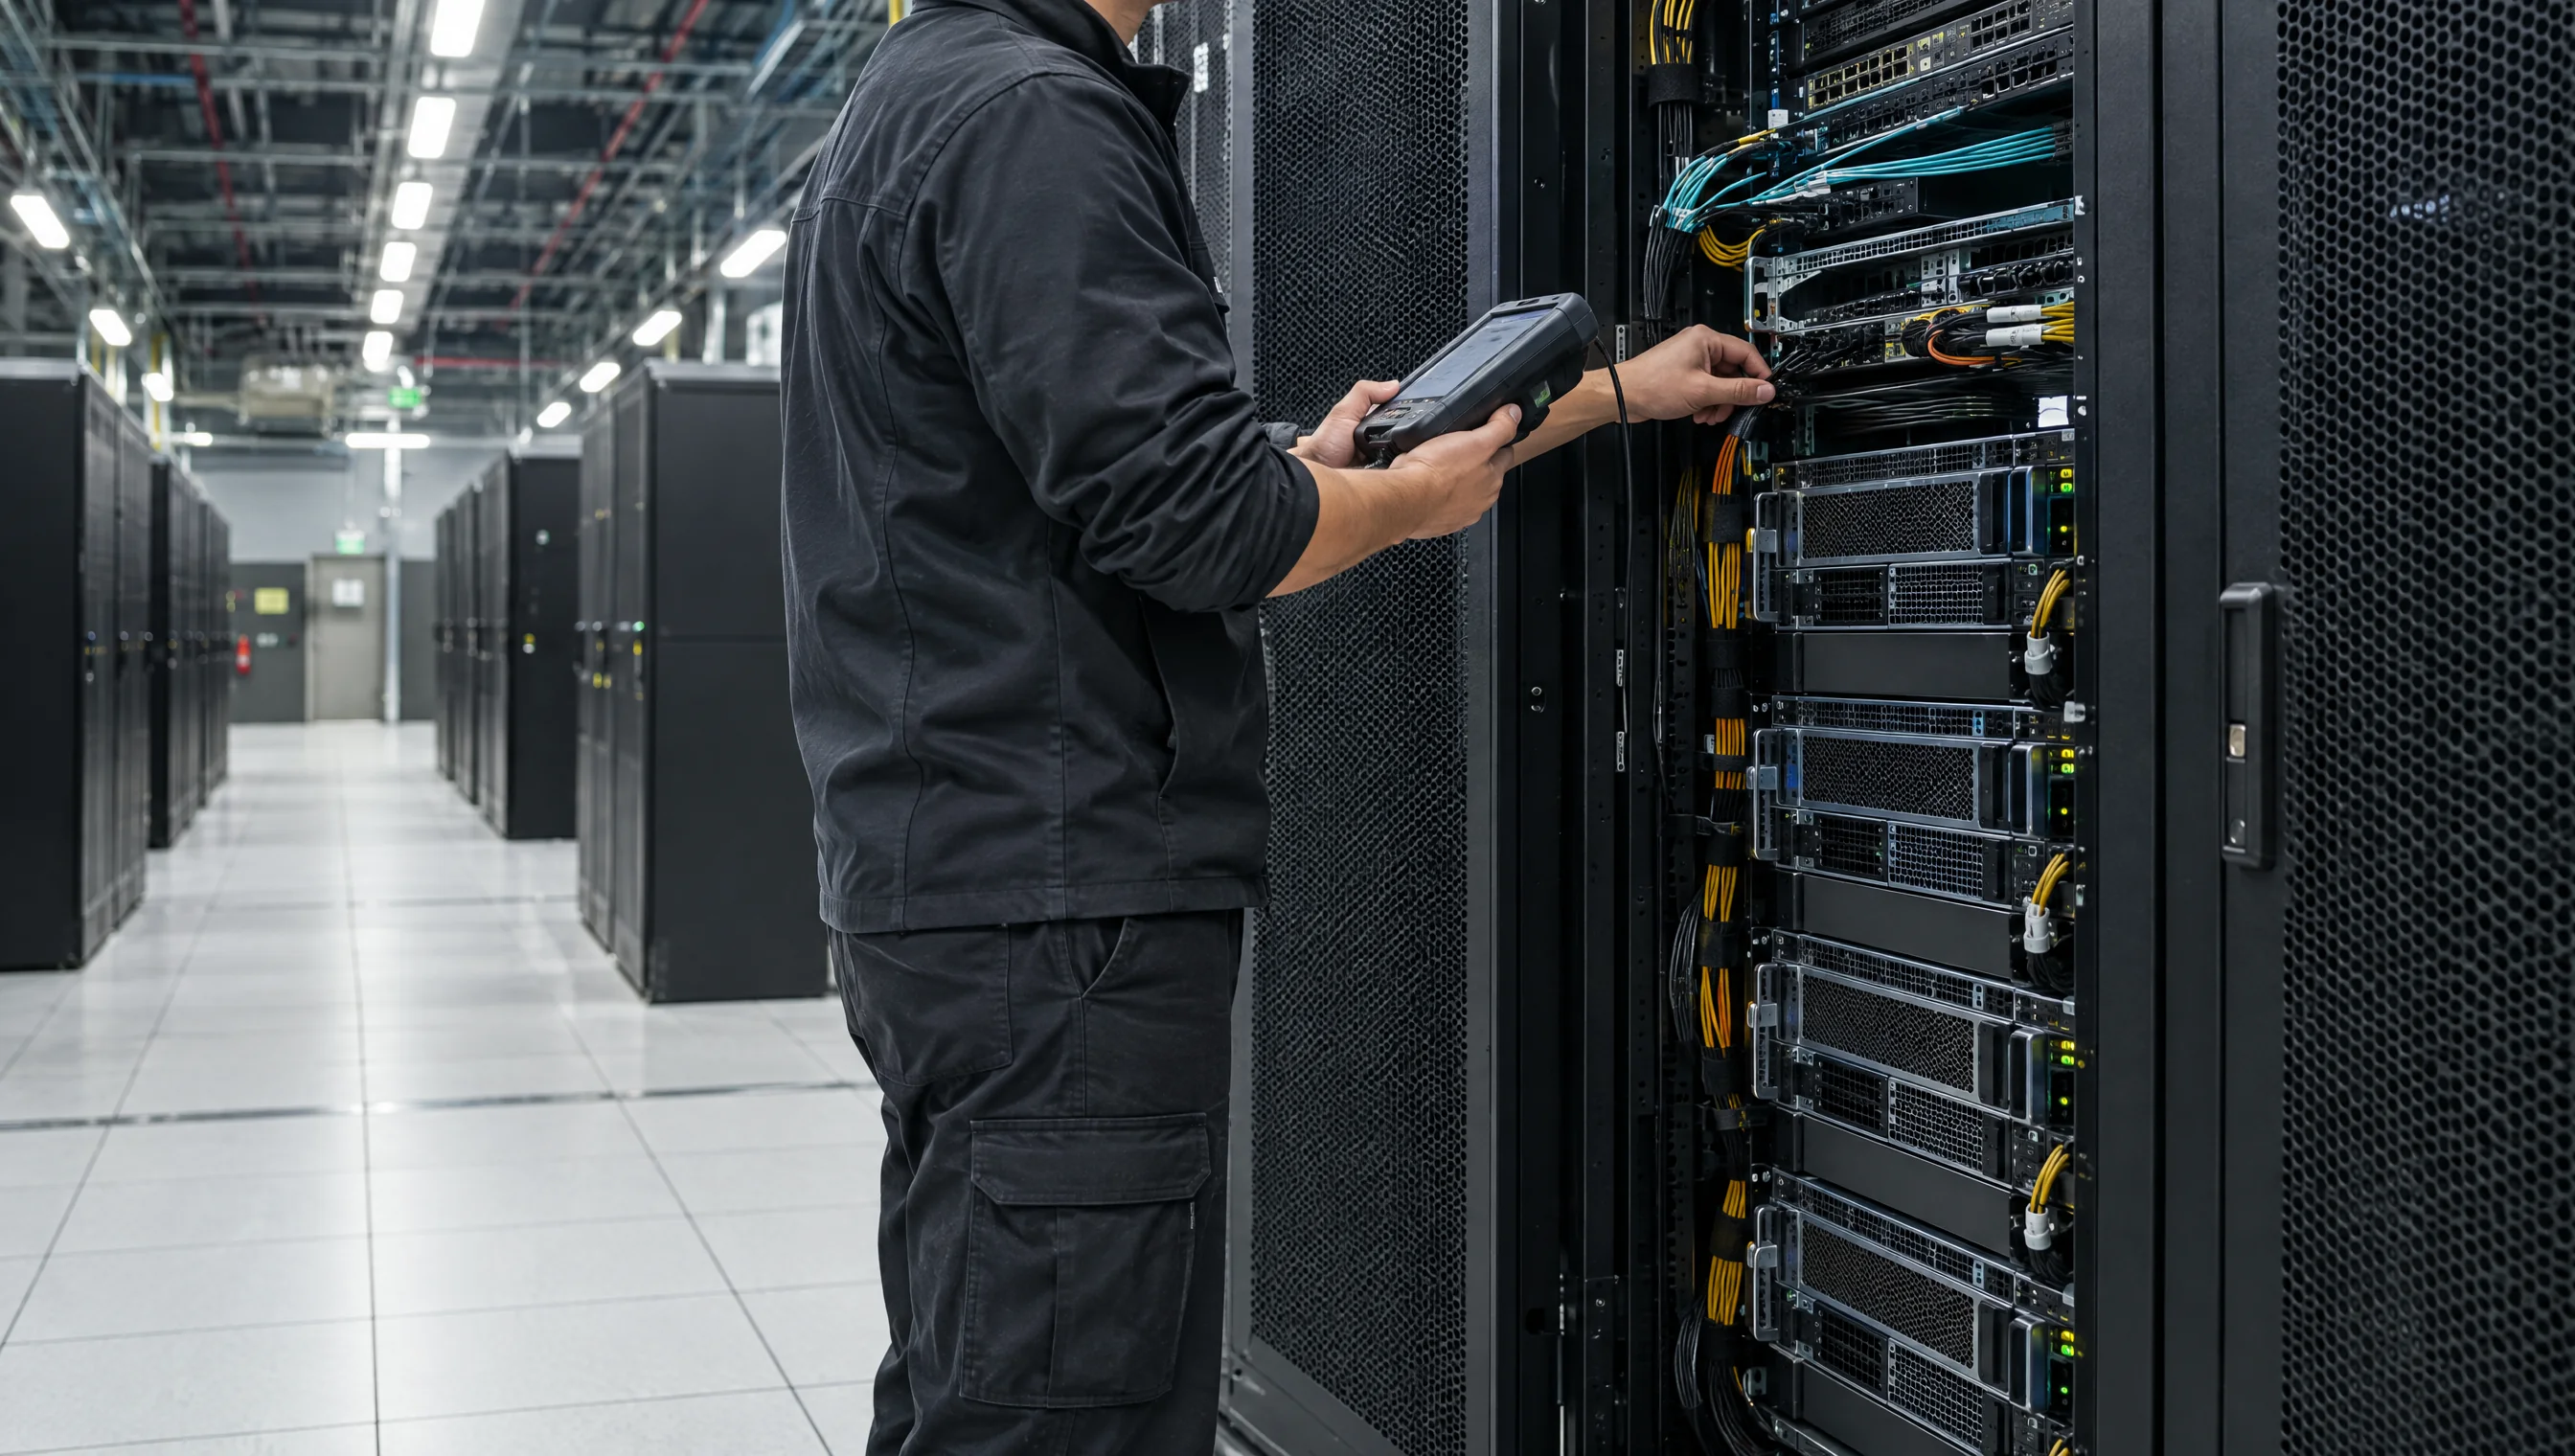
    集群交付前,查看负载、内存、网络和温度测试结果。

    查看交付验收测试

使用 TensorBay 的团队

助力团队将 AI 转化为业务价值。

  • Bank of America
  • Halliburton
  • BRF
  • PicPay
  • BMG Bank
  • City of Rio de Janeiro
  • CNSesi
  • AICUBE
  • AirCloud

交付前完成测试

从一套值得信赖的集群开始。

每套集群都会经过 72 小时的负载、内存、网络和温度测试。团队可在确认交付前查看测试结果。

72h
交付验收测试

负载 · 内存 · 网络 · 温度检查

联系 TensorBay 团队

AI 工作负载

  • TENSORBAY AIFACTORY
    模型训练专属 GPU 算力与高速网络,支持长时间训练任务。
  • TENSORBAY AIFACTORY
    微调与研究8-GPU 节点支持模型适配与实验迭代。
  • TENSORBAY AIFACTORY
    生产推理高显存系统为专属基础设施上的模型服务提供算力。

05为下一步投入算力

算力助力增长,价格让决策更清晰。

选择预留期限,比较算力配置,规划投入。从公开透明的价格开始沟通。

美元/小时,完整的 8 GPU 节点

GPU 节点, 美元/小时,完整的 8 GPU 节点
GPU 与显存月度合约按月度合约预留算力年度合约更低的小时费率
NVIDIAHGX B300288 GB HBM3e 每 GPU
月度
起价
US$ 83.20/小时
获取月度报价
年度
起价
US$ 58.50/小时
获取年度报价
NVIDIAHGX B200180 GB HBM3e 每 GPU
月度
起价
US$ 72.80/小时
获取月度报价
年度
起价
US$ 50.70/小时
获取年度报价
NVIDIAHGX H200141 GB HBM3e 每 GPU
月度
起价
US$ 44.20/小时
获取月度报价
年度
起价
US$ 31.20/小时
获取年度报价
NVIDIAHGX H10080 GB HBM3 每 GPU
月度
起价
US$ 28.60/小时
获取月度报价
年度
起价
US$ 19.50/小时
获取年度报价

小时费率涵盖完整的 8 GPU 节点。选择预留期限,获取专属报价。

SLA
月度可用性 99.9%,15 分钟节点更换,并提供有效利用率补偿额度
规模
128–10,000+ GPU · 每租户专属网络
计费
预留合约内按分钟计量 · 入站流量 $0

每一项成本,都有据可查

看清基础设施的每一个细节。

了解包含的服务,并查看存储、数据传输与网络的收费标准。

联系算力专家
存储
  • 本地 NVMe 临时存储,每节点 30 TB已包含
  • 并行文件系统,托管 WEKA每集群独享$0.09/GB·月
  • 对象存储,S3 兼容热存储NVMe 缓存,同站点部署$0.055/GB·月
  • 对象存储,归档$0.015/GB·月
  • 快照$0.021/GB·月
数据传输
  • 入站流量始终免费$0
  • 包含的出站流量20 TB/节点·月
  • 超额出站流量所有站点$1.25/TB
  • 节点间与东西向流量InfiniBand 网络$0
网络
  • 东西向 InfiniBand 网络每集群独享已包含
  • 私有 VLAN / VPC已包含
  • 额外公网 IPv4IPv6 免费$4/IP·月
  • 自带 IP,IPv4 /24 或 IPv6 /48设置费 $200免费
  • 托管防火墙$4/节点·月
  • DDoS 防护已包含
  • Direct Connect 10G / 100G年度合约免费提供 100G$450 / $1,800/月

价格以美元计,按完整的 8 GPU HGX 节点每小时收费;机架级系统按机架报价。价格不含税,包含托管 Slurm 与 Kubernetes 控制平面。存储和 Direct Connect 按上述价格计费,可咨询长期合约方案。

获取我的方案

常见问题

清晰规划你的下一个集群。

联系算力专家
GPU 价格按单块 GPU 还是按节点收费?

公布的 HGX 价格以美元计,按月度或年度预留合约中的完整 8 GPU 节点每小时收费。NVL72 系统按机架报价,价格不含税。

AI 项目应该选择哪款 NVIDIA GPU?

请比较显存容量、网络需求,以及训练或推理工作负载。硬件页面提供 B300、B200、H200、H100 与整机架系统。团队可根据模型、数据集与算力需求协助规划配置。

专属集群能用于训练、微调和推理吗?

可以。TensorBay 提供用于模型训练、微调和推理的专属 NVIDIA GPU 基础设施。你可以使用 Slurm、Kubernetes 或 SSH,并根据工作负载配置软件环境。

申请报价之后会发生什么?

提供所需 GPU、容量与预留期限,或介绍项目需求。团队将在评估后于 48 小时内准备方案,包括配置与交付时间,最终容量和条款在方案中确认。

询价时需要确认哪些部署与交付信息?

请说明团队所在地区、数据存放地、目标部署地区和启动日期。具体数据中心、可交付 GPU 配置、网络访问方式和交付时间在项目方案中确认。部署前可按工作负载约定验收标准。

如何规划 Qwen、DeepSeek 或 Kimi 等模型的算力?

请提供具体模型版本、训练或推理目标与数据规模。结合显存、计算精度、上下文长度、并发和软件兼容性评估容量,再用实际工作负载验证延迟与吞吐。团队会根据项目需求核对可用配置。

GPU 租赁报价是否包含数据传输与存储?

GPU 预留费率与存储、数据传输和额外网络服务分项列出。请提供数据量、预计入站与出站流量,以及所需连接方式,并在方案中确认总费用、计费单位与税费。页面标价为美元,不是人民币。

探索 TensorBay

为 AI 的下一步找到合适的算力基础。

了解可用 GPU、基础设施与价格,为 AI 项目规划下一步。

数据中心通道内排列着深色 GPU 服务器机柜,顶部设有线缆桥架

提前预订

NVIDIA VR200 NVL72

查看 Vera Rubin 机架级配置与提前预订时间安排。

NVIDIA VR200 NVL72
宽阔的 AI 数据中心,黑色 GPU 服务器机柜沿明亮的运维通道排列

价格

依据公开价格规划

比较 GPU 节点与机架级系统的月度和年度预订方案。

依据公开价格规划

08让创意拥有成长空间

下一次 AI 突破,从一次沟通开始。

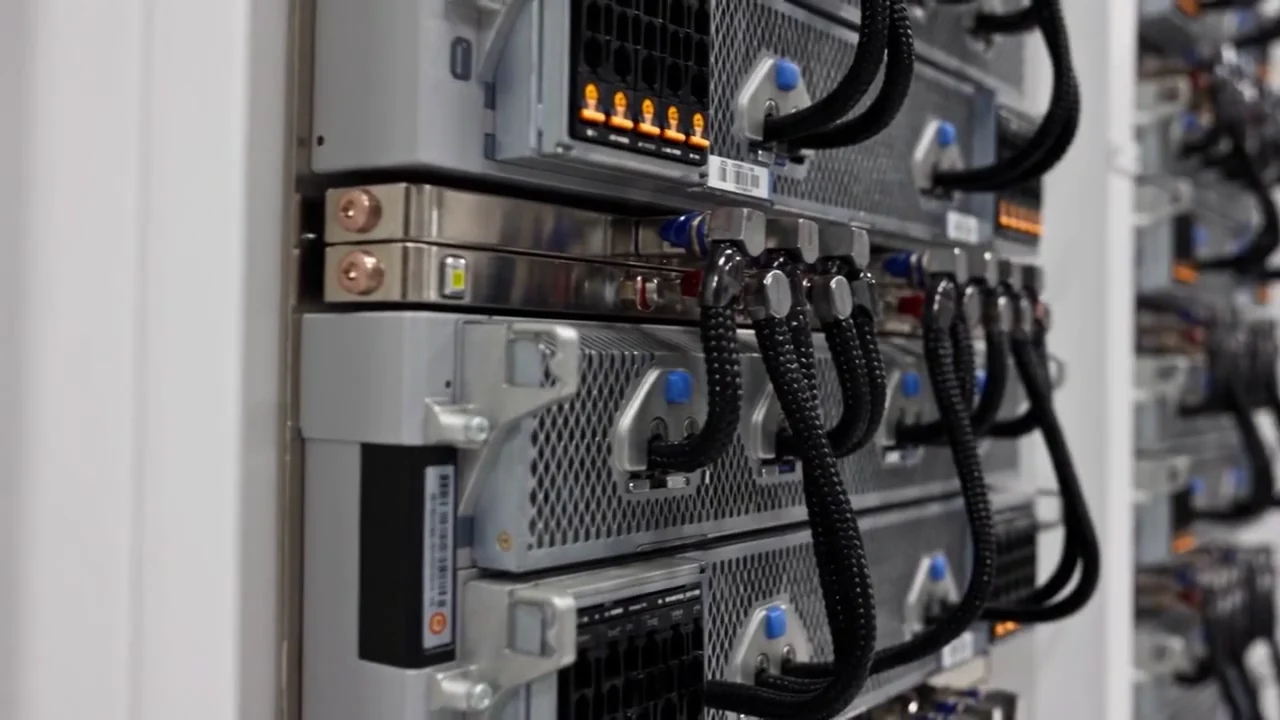
告诉我们你的挑战。团队将协助确定 GPU、容量和时间安排,并在 48 小时内提供方案,支持项目启动或进一步扩展。
  • 围绕项目定制的配置
  • 包含交付时间的方案
  • 启用前的验收测试
tensorbay@tensorbay.io