Las GPU necesitan un flujo de datos constante
Los conjuntos de datos y los checkpoints pueden dejar capacidad GPU esperando cuando la red y el almacenamiento se planifican por separado.
ENTRENAMIENTO DE MODELOS DE IA
Planifica la capacidad de entrenamiento según tu modelo, flujo de datos y cronograma. Sistemas NVIDIA dedicados, red de alta velocidad y precios claros de reserva dan a tu equipo una base desde la primera ejecución hasta producción.
LOS CUELLOS DE BOTELLA DEL ENTRENAMIENTO
Las ejecuciones largas dependen de más que la cantidad de GPU. El movimiento de datos, el ajuste del sistema y el plan de recuperación influyen en la rapidez con que un equipo prueba una idea y aprende de ella.
Los conjuntos de datos y los checkpoints pueden dejar capacidad GPU esperando cuando la red y el almacenamiento se planifican por separado.
La memoria, la interconexión y la cantidad de nodos deben funcionar en conjunto con el modelo y su método de entrenamiento.
Una interrupción puede afectar un experimento largo. Las pruebas de aceptación y una ruta clara de recuperación ayudan a planificar la continuidad.
CÓMO AYUDA TENSORBAY
FLUJO DE DATOS01
Planifica la red y el almacenamiento junto con la capacidad GPU para que los datos y checkpoints sigan el flujo del equipo.
Explorar red y almacenamientoCAPACIDAD GPU02
Compara nodos dedicados de 8 GPU y configuraciones a escala de rack por memoria, interconexión y carga de trabajo.
Explorar sistemas GPUACEPTACIÓN03
Revisa las pruebas de carga, memoria, red y temperatura antes de recibir el clúster.
Ver pruebas de aceptaciónEQUIPOS QUE USAN TENSORBAY
PROBADO ANTES DE LA ENTREGA
Cada clúster pasa por 72 horas de pruebas de carga, memoria, red y temperatura. Tu equipo revisa los resultados antes de aprobar la entrega.
Pruebas de carga · memoria · red · temperatura
CARGAS DE TRABAJO DE IA
05Invierte en tu próximo paso
Elige el plazo de reserva, compara la capacidad y planifica tu inversión. Aquí, la conversación empieza con los precios a la vista.
| GPU y memoria | Plazo mensualReserva con contrato mensual | Plazo anualMenor precio por hora |
|---|---|---|
NVIDIAHGX B300288 GB HBM3e por GPU | Mensual desde Cotizar mensualUS$ 83,20/h | Anual desde Cotizar anualUS$ 58,50/h |
NVIDIAHGX B200180 GB HBM3e por GPU | Mensual desde Cotizar mensualUS$ 72,80/h | Anual desde Cotizar anualUS$ 50,70/h |
NVIDIAHGX H200141 GB HBM3e por GPU | Mensual desde Cotizar mensualUS$ 44,20/h | Anual desde Cotizar anualUS$ 31,20/h |
NVIDIAHGX H10080 GB HBM3 por GPU | Mensual desde Cotizar mensualUS$ 28,60/h | Anual desde Cotizar anualUS$ 19,50/h |
El precio por hora corresponde al nodo completo con 8 GPU. Elige el contrato para solicitar tu cotización.
Cada detalle cuenta
Consulta qué está incluido y las tarifas de almacenamiento, transferencia de datos y red.
Hablar con un especialistaPrecios en USD por hora de nodo HGX de 8 GPUs; los sistemas rack-scale se cotizan por rack. Impuestos no incluidos. Gestión de Slurm y Kubernetes incluida. Almacenamiento y Direct Connect según las tarifas anteriores. Consulta las condiciones para contratos a largo plazo.
Recibir mi propuestaLos precios publicados de HGX son en USD por hora de un nodo completo con 8 GPU, dentro de una reserva mensual o anual. Los sistemas NVL72 se cotizan por rack. Los impuestos no están incluidos.
Compara la memoria de la GPU, los requisitos de red y la carga de entrenamiento o inferencia. La sección de hardware presenta H100, H200, B200, B300 y sistemas de rack completo. Nuestro equipo te ayuda a dimensionar la configuración según el modelo, los datos y la capacidad necesaria.
Sí. TensorBay ofrece infraestructura dedicada de GPU NVIDIA para entrenamiento de modelos, fine-tuning e inferencia. Puedes trabajar con Slurm, Kubernetes o SSH y configurar el entorno de software para tu carga de trabajo.
Indica la GPU, la capacidad y el plazo de reserva, o describe tu proyecto. El equipo revisa los requisitos y prepara una propuesta en un plazo de 48 horas, con configuración y fecha de entrega. La capacidad y las condiciones finales se confirman en la propuesta.
EXPLORA TENSORBAY
Conoce las GPU, la infraestructura y los precios para impulsar tu proyecto de IA.
RESERVAS ANTICIPADAS
Consulta la configuración Vera Rubin a escala de rack y el calendario de reserva anticipada.
NVIDIA VR200 NVL72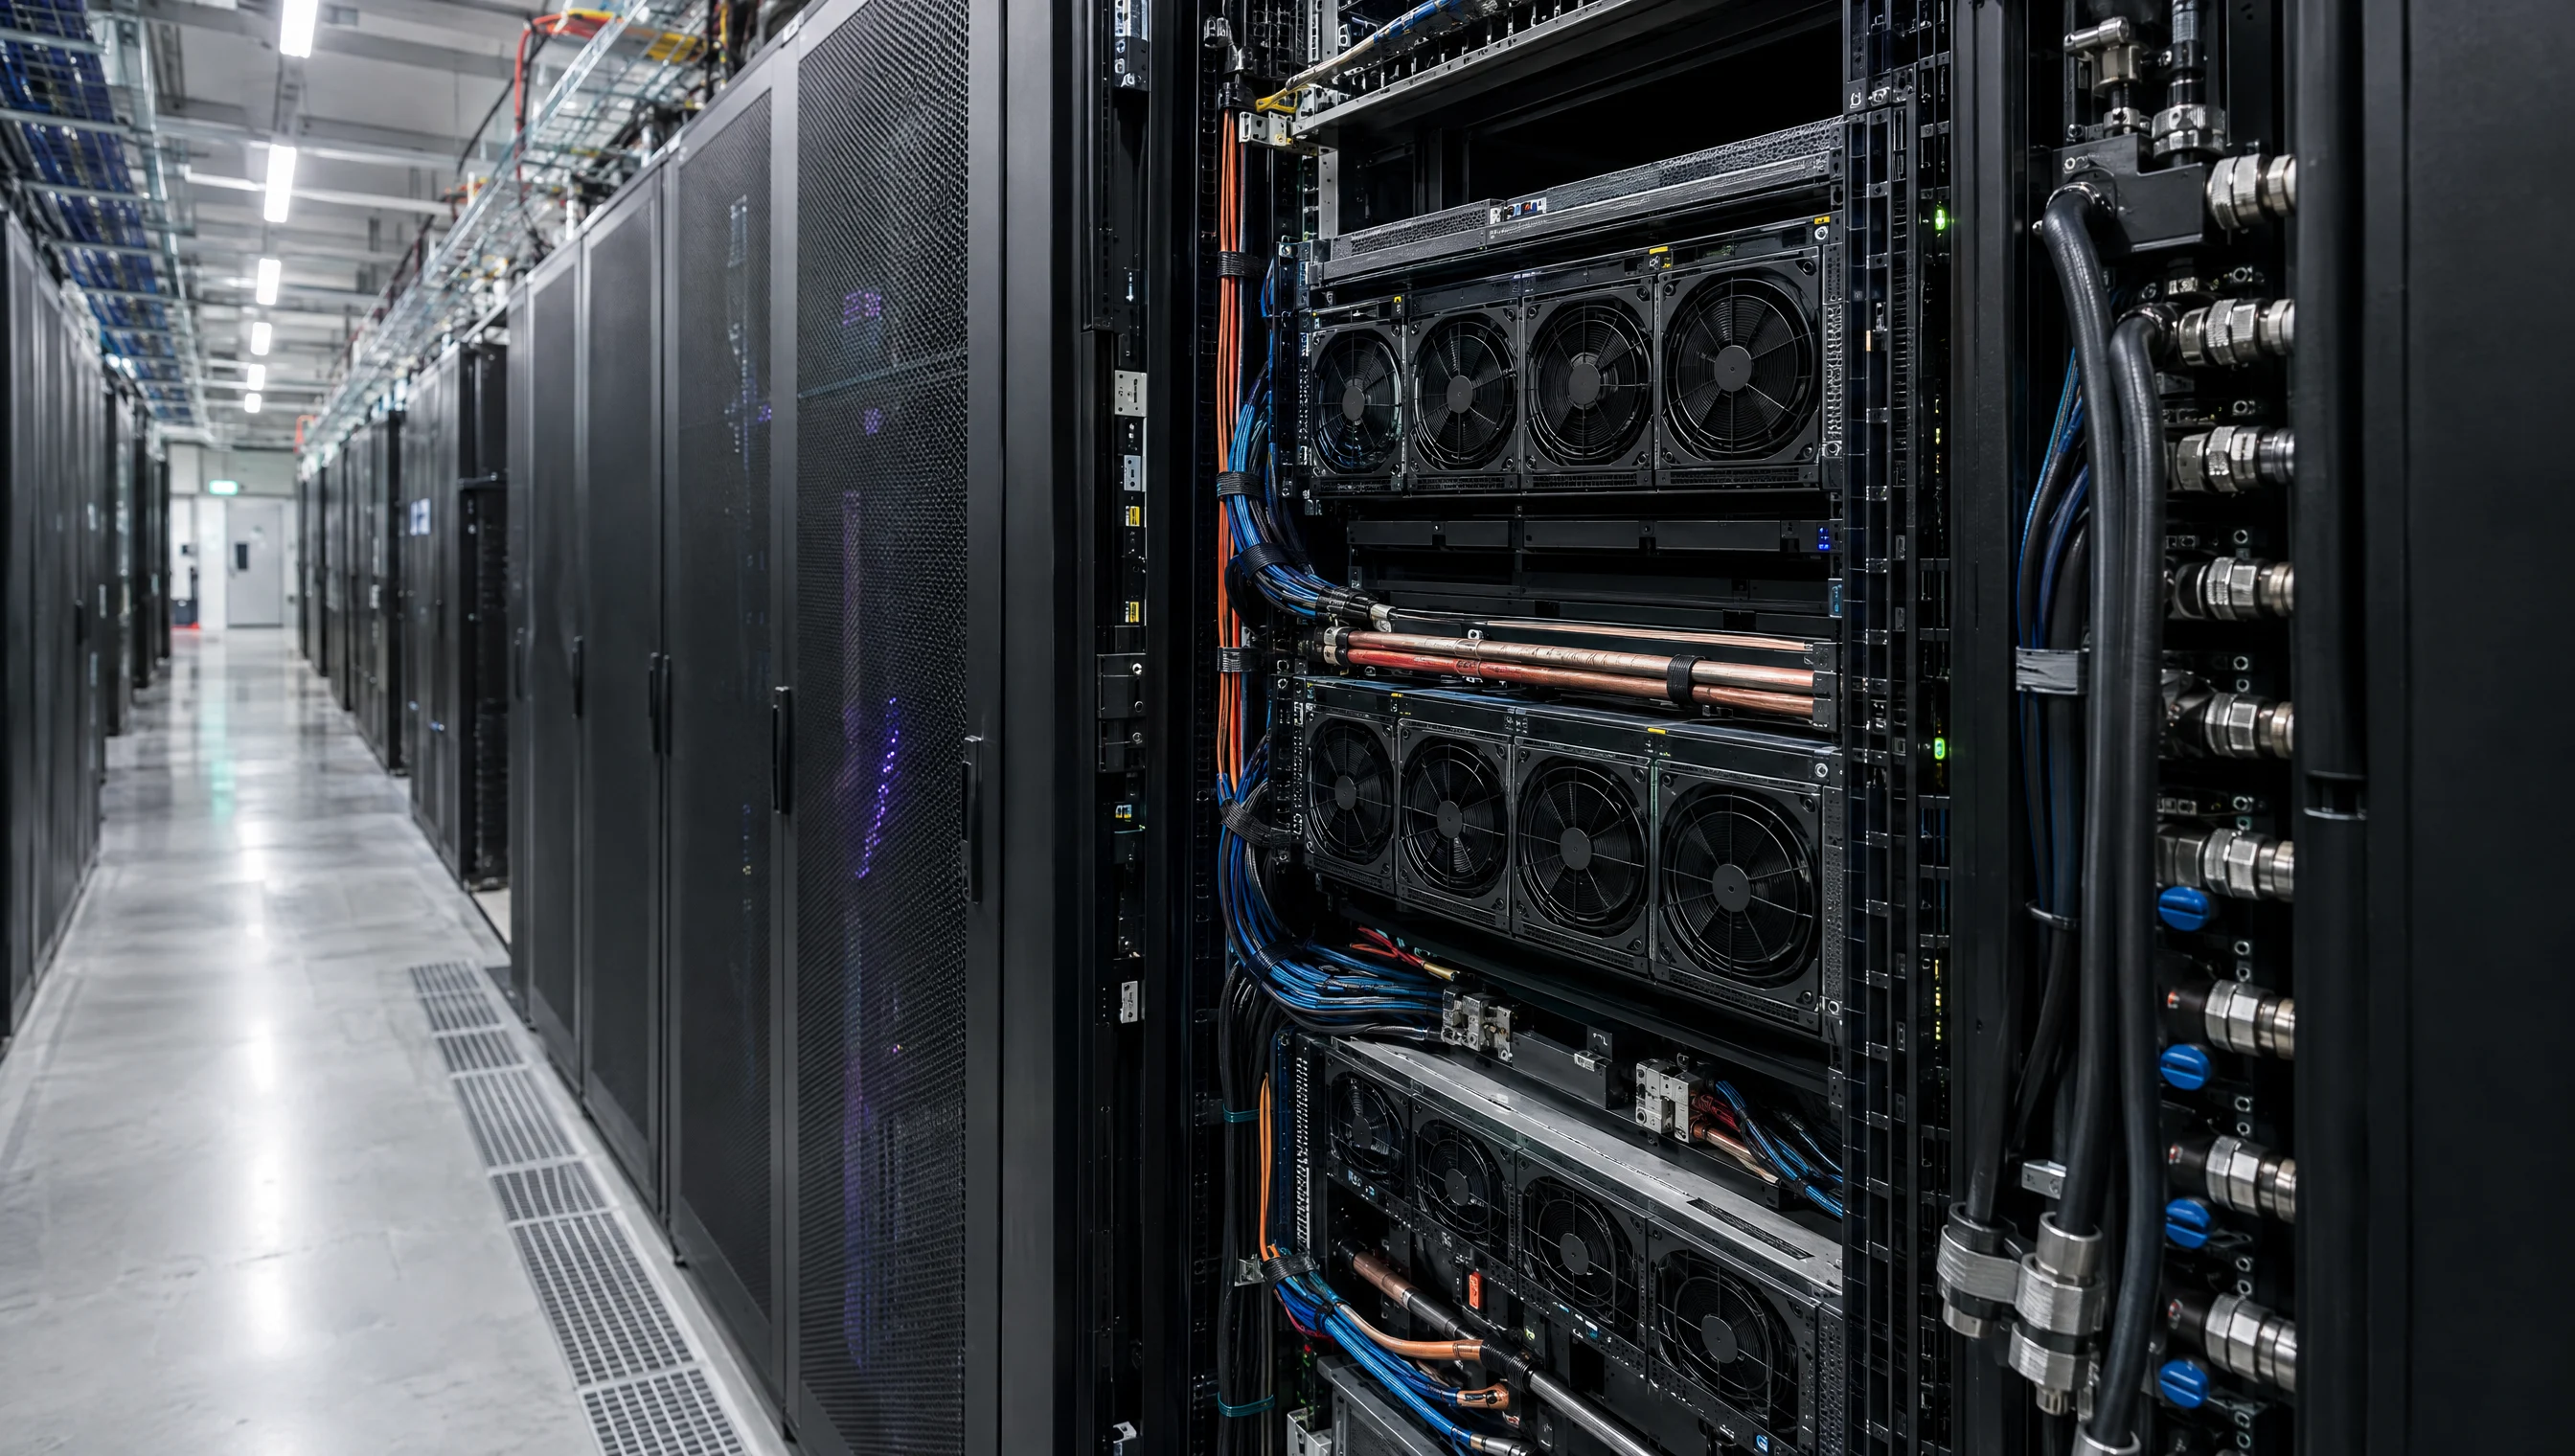
CÓMPUTO GPU
Compara las configuraciones TensorBay, de la generación más reciente a las anteriores.
Encuentra la GPU NVIDIA adecuada
PRECIOS
Compara reservas mensuales y anuales para nodos GPU y sistemas a escala de rack.
Planifica con tarifas publicadas08Demos escala a tu idea
Cuéntanos tu reto. Nuestro equipo te ayuda a definir las GPUs, la capacidad y los plazos. Recibe una propuesta en 48 horas para lanzar tu proyecto o llevarlo más lejos.