
De pruebas del sistema antes de entregar el clúster.
ASESORAMIENTO EXPERTO, DEL PLAN A LA PRIMERA EJECUCIÓN
Especialistas a tu lado, del plan a la operación.
Diseña tu entorno GPU dedicado con especialistas que conocen la computación, la red, el almacenamiento y las comprobaciones operativas necesarias.
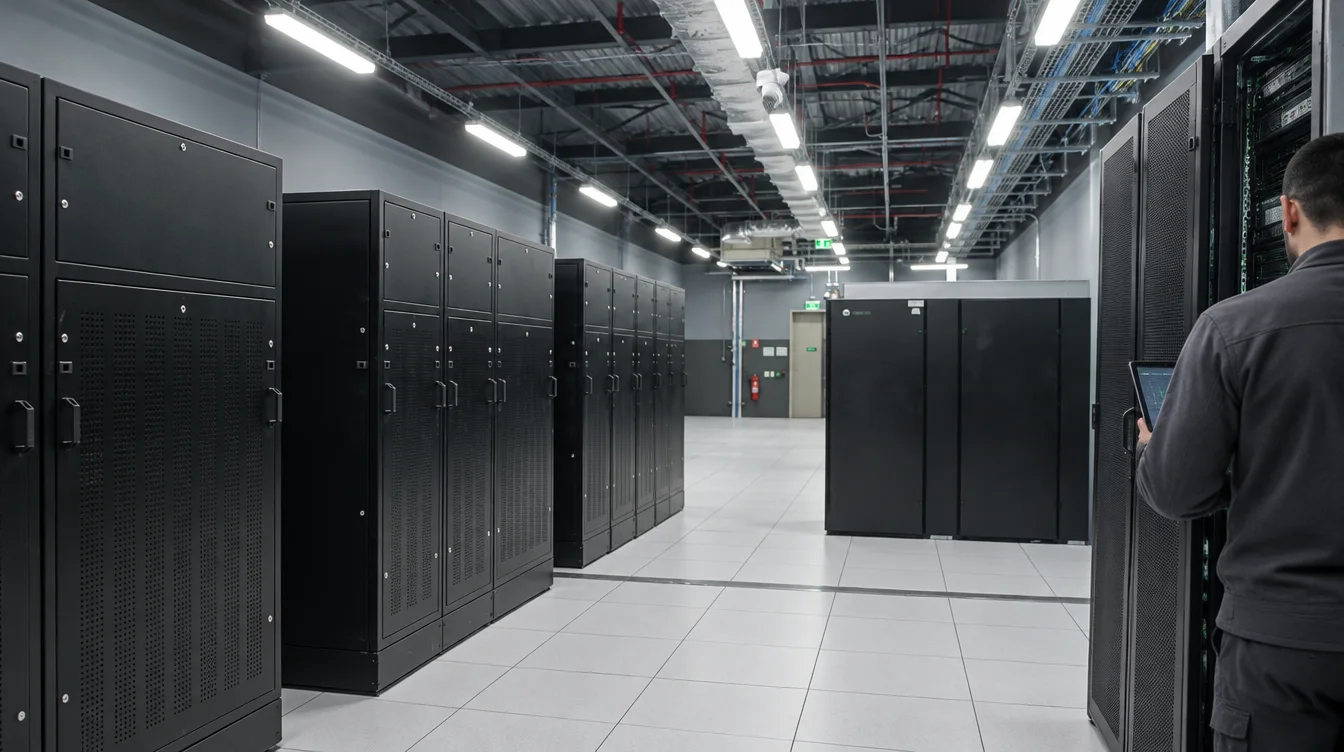
PREPARADO ANTES DE LLEGAR A TU EQUIPO
SLA de sustitución de nodo.
Carga, memoria, red y temperatura.
UN RECORRIDO OPERATIVO CLARO
Conoce tu clúster antes de empezar a usarlo.
Cada decisión técnica queda a la vista, desde la primera conversación sobre la carga de trabajo hasta la última comprobación antes de la entrega.
01 Define la carga de trabajo
Alinea modelo, memoria GPU, cantidad de nodos, datos, red y calendario.
02 Planifica el sistema
Coordina cómputo, ruta de datos, reserva y entrega según el trabajo.
03 Revisa la preparación
Consulta los resultados de carga, memoria, red y temperatura antes de la entrega.
APOYO EN CADA DETALLE
Claridad en cada decisión.
La infraestructura dedicada tiene muchas piezas. Mantén cada decisión conectada con tu carga de trabajo y el siguiente hito del proyecto.
01
PLANIFICACIÓN DE CAPACIDAD
Una configuración para el trabajo
Alinea modelo, memoria GPU, cantidad de nodos y calendario antes de reservar.02
PRUEBAS DE ACEPTACIÓN
Resultados que tu equipo puede revisar
Las pruebas de carga, memoria, red y temperatura se completan antes de la entrega, con resultados disponibles para revisar.03
CONTINUIDAD OPERATIVA
Una ruta para que el trabajo siga avanzando
Las configuraciones elegibles incluyen nodos de repuesto en el mismo rack y un SLA de sustitución de 15 minutos. Confirma el alcance contratado con el equipo.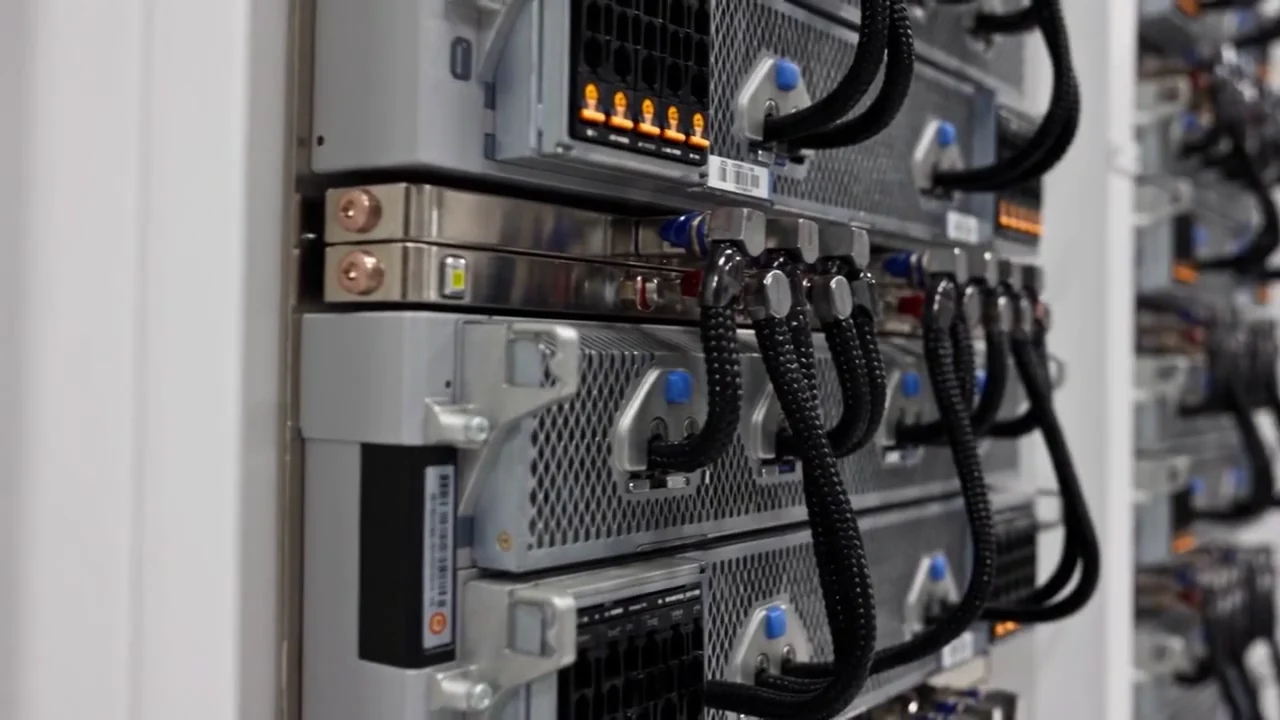
PROBADO ANTES DE LA ENTREGA
Empieza con un clúster en el que tu equipo pueda confiar.
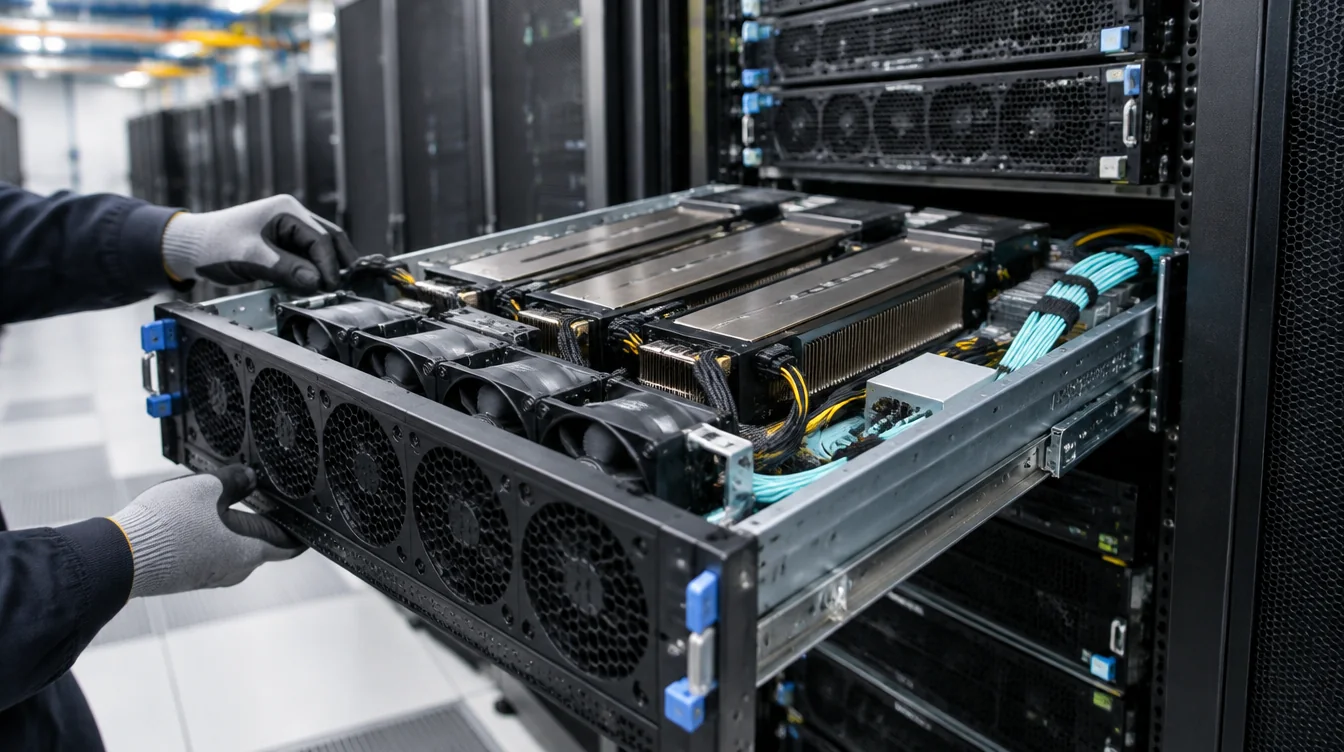
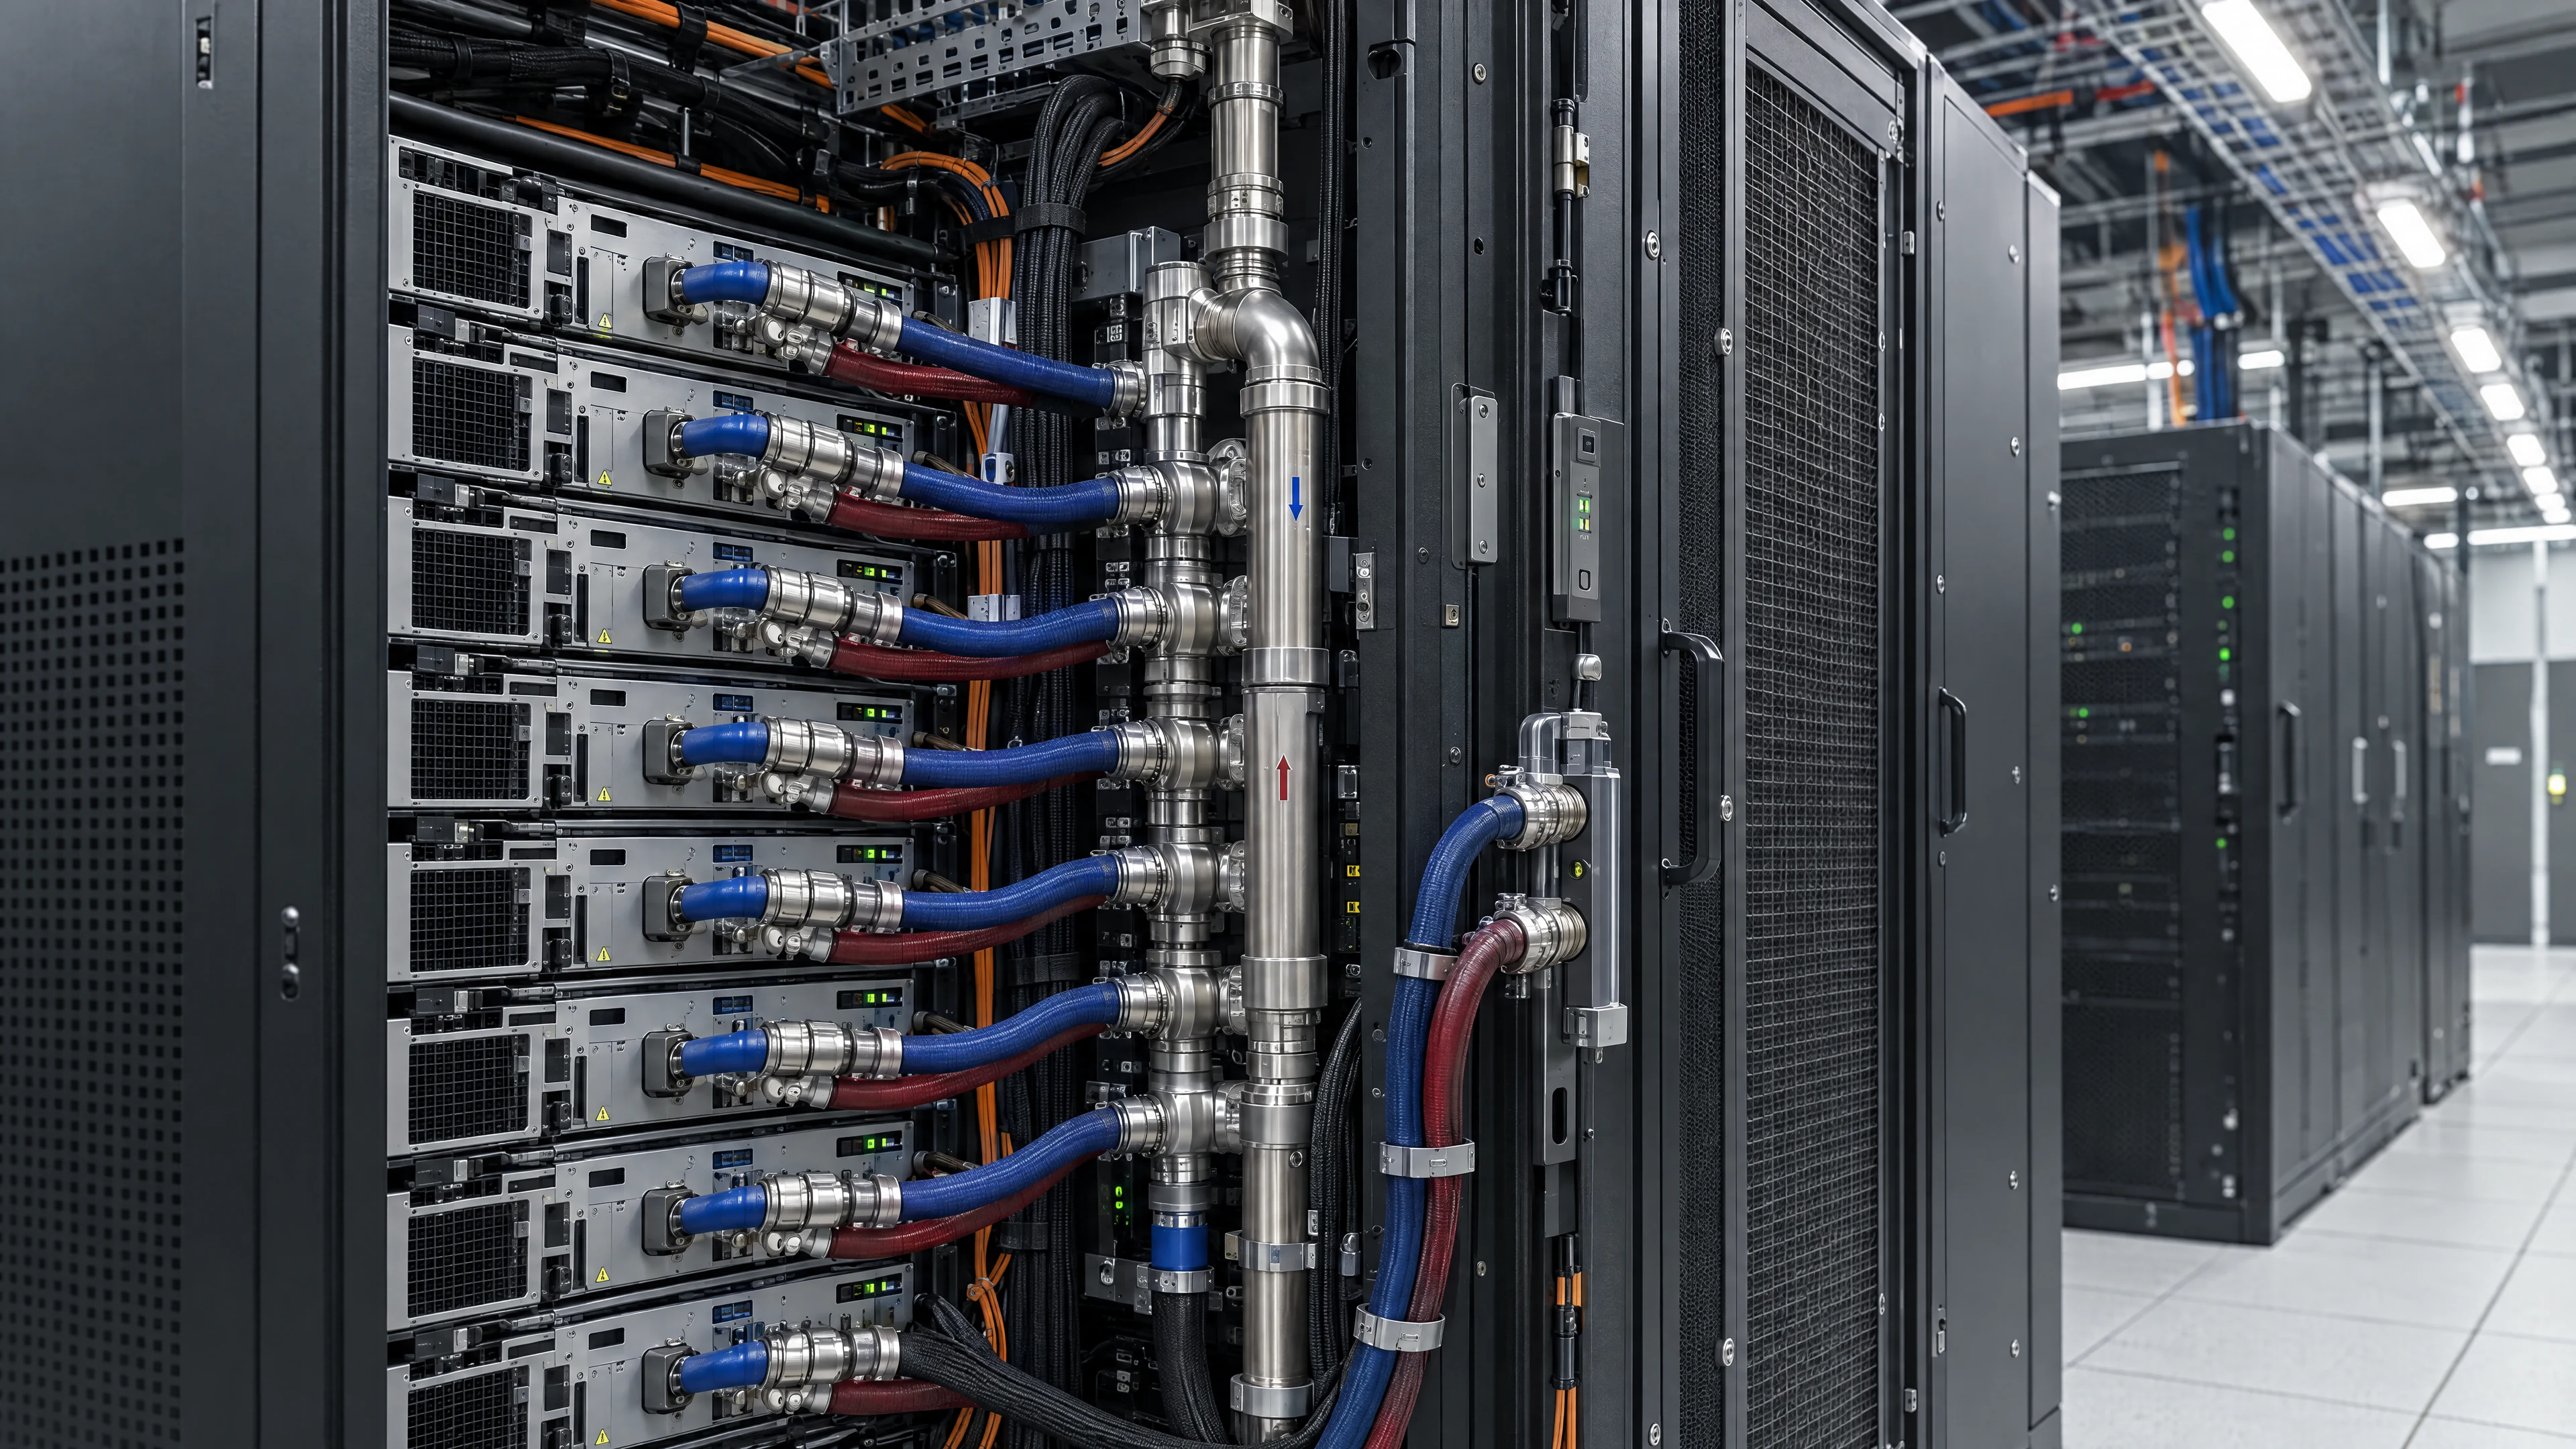
Cada clúster pasa por 72 horas de pruebas de carga, memoria, red y temperatura. Tu equipo revisa los resultados antes de aprobar la entrega.
72h
PRUEBAS DE ACEPTACIÓN
Pruebas de carga · memoria · red · temperatura
CARGAS DE TRABAJO DE IA
- TENSORBAY AIFACTORYEntrenamiento de modelosGPU dedicadas y red de alta velocidad para entrenamientos prolongados.
- TENSORBAY AIFACTORYAjuste fino e investigaciónNodos de 8 GPU para adaptar modelos e iterar en experimentos.
- TENSORBAY AIFACTORYInferencia en producciónSistemas con más memoria para servir modelos en infraestructura dedicada.
¿El precio es por GPU o por nodo?
Los precios publicados de HGX son en USD por hora de un nodo completo con 8 GPU, dentro de una reserva mensual o anual. Los sistemas NVL72 se cotizan por rack. Los impuestos no están incluidos.
¿Qué GPU NVIDIA debo elegir para mi proyecto de IA?
Compara la memoria de la GPU, los requisitos de red y la carga de entrenamiento o inferencia. La sección de hardware presenta H100, H200, B200, B300 y sistemas de rack completo. Nuestro equipo te ayuda a dimensionar la configuración según el modelo, los datos y la capacidad necesaria.
¿Puedo usar el clúster para entrenamiento, fine-tuning e inferencia?
Sí. TensorBay ofrece infraestructura dedicada de GPU NVIDIA para entrenamiento de modelos, fine-tuning e inferencia. Puedes trabajar con Slurm, Kubernetes o SSH y configurar el entorno de software para tu carga de trabajo.
¿Qué ocurre después de solicitar una cotización?
Indica la GPU, la capacidad y el plazo de reserva, o describe tu proyecto. El equipo revisa los requisitos y prepara una propuesta en un plazo de 48 horas, con configuración y fecha de entrega. La capacidad y las condiciones finales se confirman en la propuesta.
08Demos escala a tu idea
Trae el modelo. Llévate un plan.
Cuéntanos sobre tu carga de trabajo, tus objetivos de capacidad y tu calendario. Te ayudaremos a definir la configuración y los pasos para dejarla lista.
- Configuración alineada con tu proyecto
- Propuesta con plazo de entrega
- Pruebas de aceptación antes de empezar