
De testes de sistema antes da entrega do cluster.
APOIO ESPECIALIZADO, DO PLANO À PRIMEIRA EXECUÇÃO
Especialistas ao seu lado, do plano à operação.
Planeje seu ambiente dedicado de GPUs com especialistas que entendem computação, rede, armazenamento e testes operacionais.
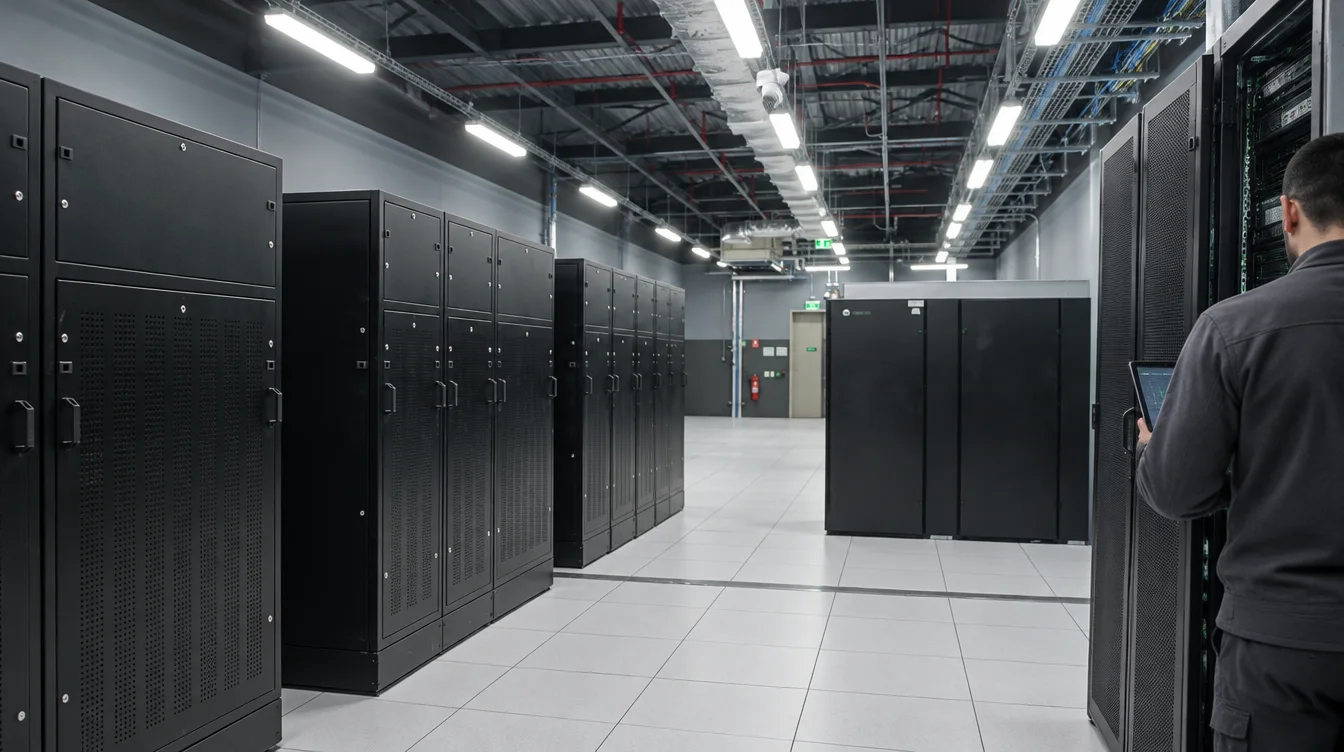
PRONTO ANTES DE CHEGAR À SUA EQUIPE
SLA de substituição de nó.
Carga, memória, rede e temperatura.
UM CAMINHO OPERACIONAL CLARO
Entenda seu cluster antes de começar a usar.
Cada decisão técnica fica visível, da primeira conversa sobre a carga de trabalho à última verificação antes da entrega.
01 Entenda a carga de trabalho
Alinhe modelo, memória das GPUs, quantidade de nós, dados, rede e prazo.
02 Planeje o sistema
Coordene computação, fluxo de dados, reserva e entrega de acordo com o trabalho.
03 Revise os testes
Consulte os resultados de carga, memória, rede e temperatura antes da entrega.
APOIO EM CADA DETALHE
Clareza em cada decisão.
Uma infraestrutura dedicada envolve muitas etapas. Mantenha cada decisão conectada à sua carga de trabalho e ao próximo marco do projeto.
01
PLANEJAMENTO DE CAPACIDADE
Configuração pensada para o trabalho
Alinhe modelo, memória das GPUs, quantidade de nós e cronograma antes de reservar.02
TESTES DE ACEITAÇÃO
Resultados para sua equipe revisar
Os testes de carga, memória, rede e temperatura são feitos antes da entrega, com resultados disponíveis para análise.03
CONTINUIDADE OPERACIONAL
Um caminho para manter o trabalho em movimento
Configurações elegíveis incluem nós de reposição no mesmo rack e SLA de substituição em 15 minutos. Confirme o escopo contratado com nossa equipe.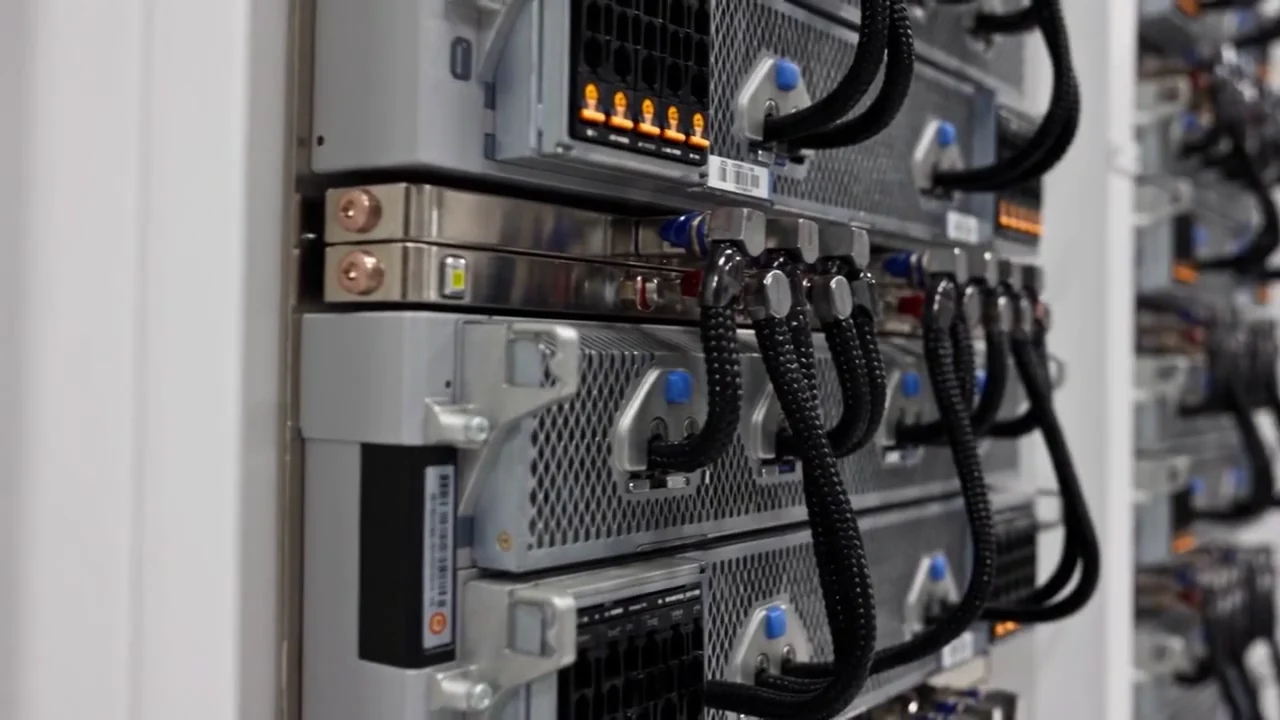
TESTADO ANTES DA ENTREGA
Comece com um cluster em que sua equipe pode confiar.
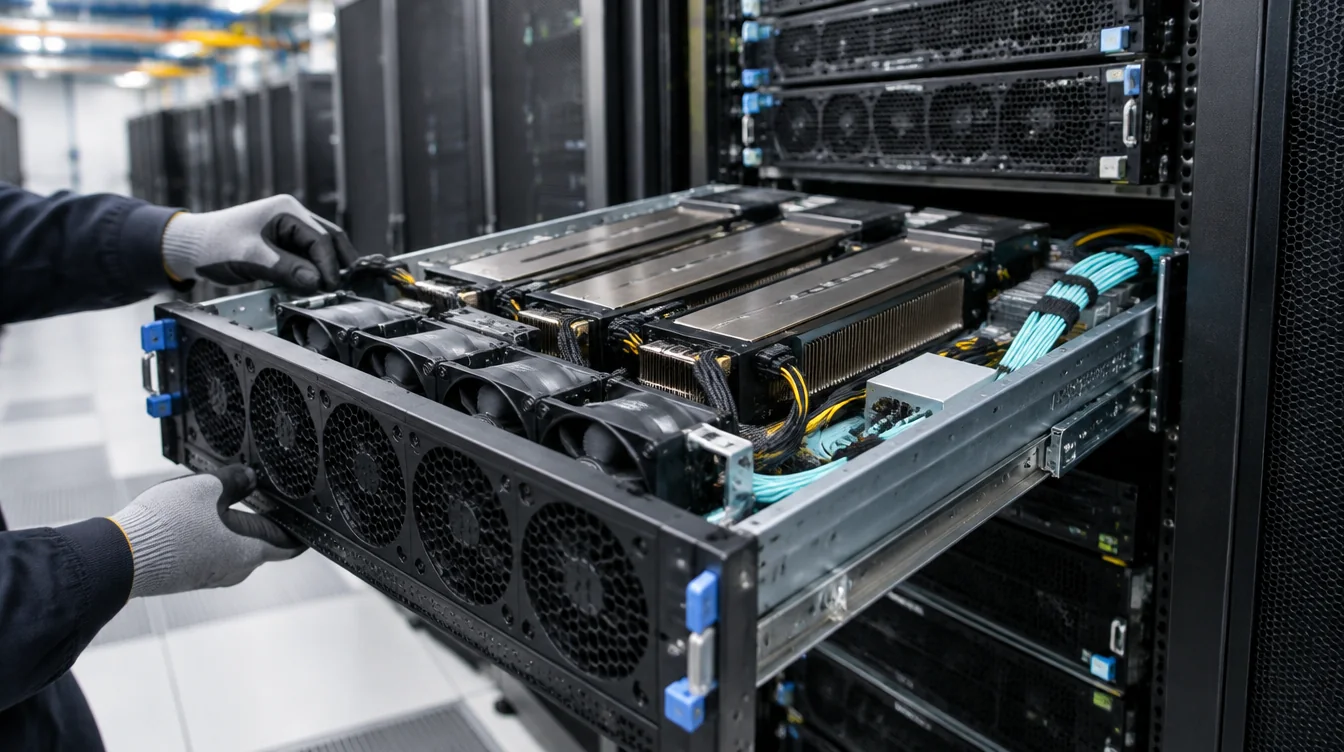
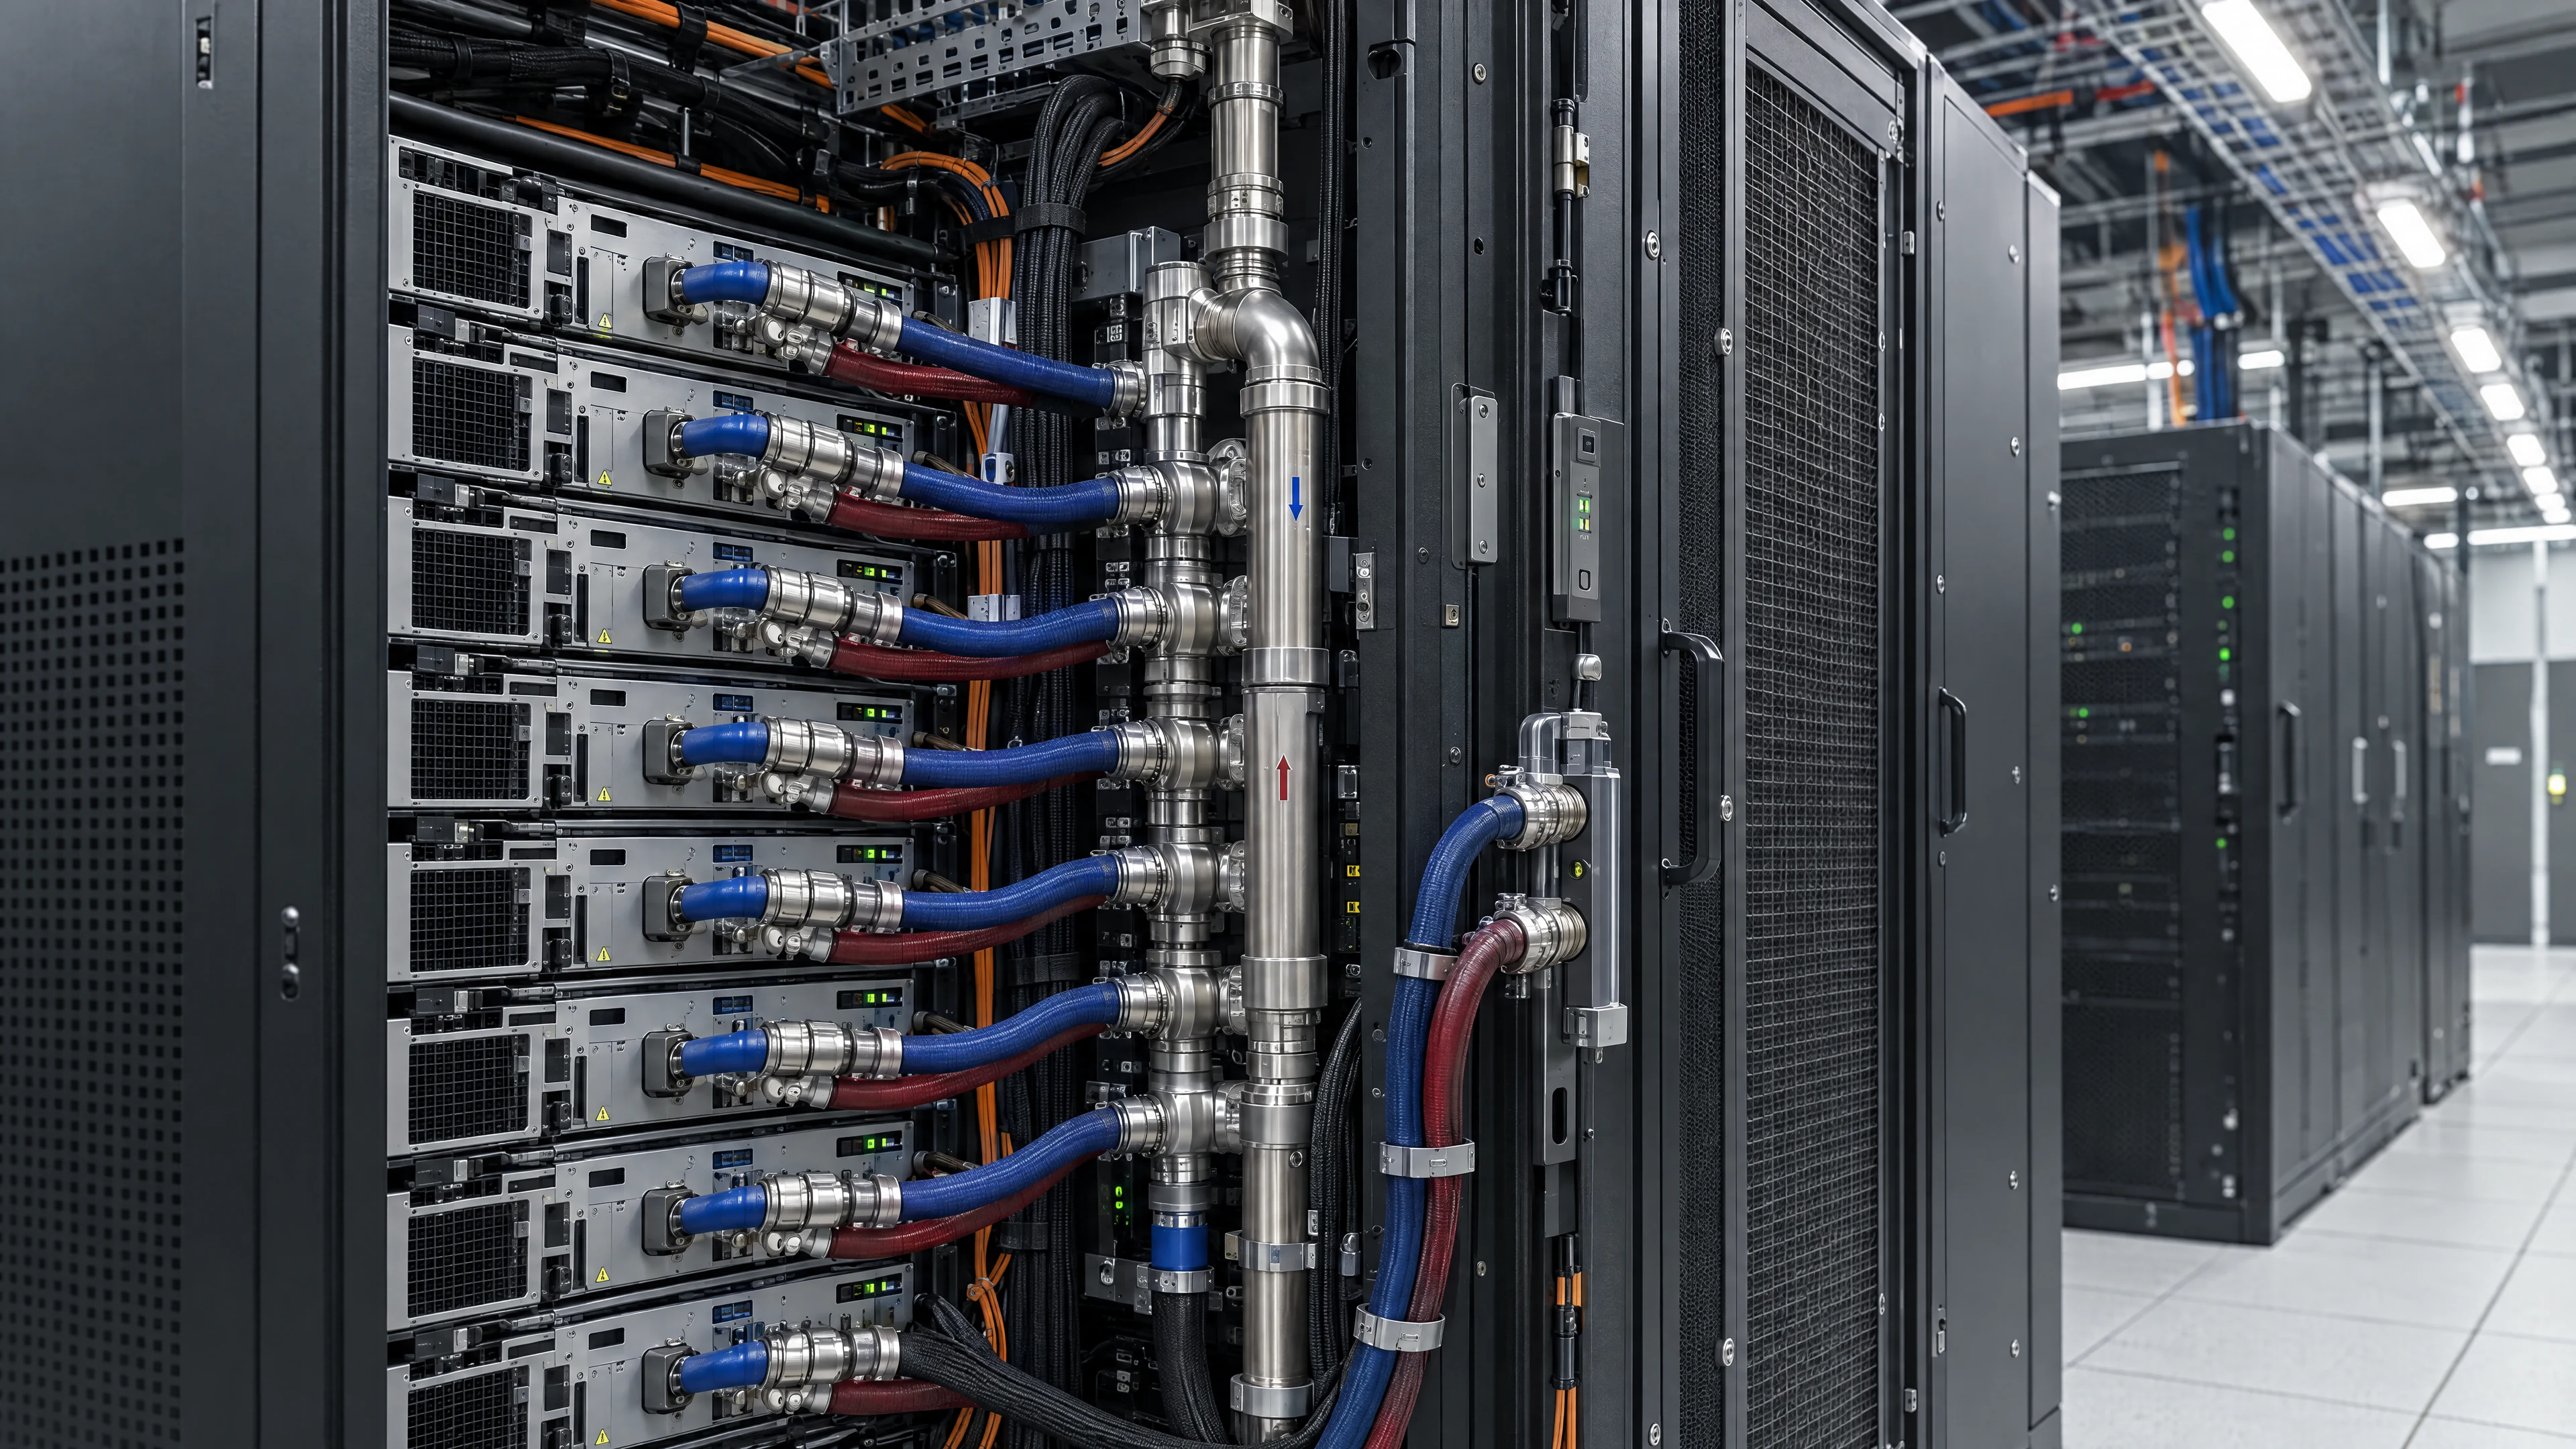
Cada cluster passa por 72 horas de testes de carga, memória, rede e temperatura. Sua equipe analisa os resultados antes de aprovar a entrega.
72h
TESTES DE ACEITAÇÃO
Testes de carga · memória · rede · temperatura
CARGAS DE TRABALHO DE IA
- TENSORBAY AIFACTORYTreinamento de modelosGPUs dedicadas e rede de alta velocidade para execuções longas de treinamento.
- TENSORBAY AIFACTORYAjuste fino e pesquisaNós de 8 GPUs para adaptar modelos e iterar em experimentos.
- TENSORBAY AIFACTORYInferência em produçãoSistemas com mais memória para servir modelos em infraestrutura dedicada.
O preço é por GPU ou por nó?
Os preços publicados para HGX são em USD por hora de um nó completo com 8 GPUs, dentro de uma reserva mensal ou anual. Sistemas NVL72 têm cotação por rack. Os valores não incluem impostos.
Qual GPU NVIDIA devo escolher para meu projeto de IA?
Compare a memória da GPU, os requisitos de rede e a carga de treinamento ou inferência. A seção de hardware apresenta H100, H200, B200, B300 e sistemas de rack completo. Nossa equipe ajuda a dimensionar a configuração a partir do modelo, dos dados e da capacidade necessária.
Posso usar o cluster para treinamento, fine-tuning e inferência?
Sim. A TensorBay oferece infraestrutura dedicada de GPUs NVIDIA para treinamento de modelos, fine-tuning e inferência. Você pode trabalhar com Slurm, Kubernetes ou SSH e configurar o ambiente de software para sua carga de trabalho.
O que acontece depois que eu peço uma cotação?
Informe a GPU, a capacidade e o prazo da reserva, ou conte sobre seu projeto. A equipe avalia os requisitos e prepara uma proposta em até 48 horas, com configuração e prazo de entrega. A capacidade e as condições finais são confirmadas na proposta.
08Vamos dar escala à sua ideia
Traga o modelo. Saia com um plano.
Conte sobre sua carga de trabalho, capacidade desejada e prazo. Vamos ajudar a definir a configuração e as etapas para deixá-la pronta.
- Configuração alinhada ao seu projeto
- Proposta com prazo de entrega
- Testes de aceitação antes de começar