
Reserve espaço para o modelo
Memória, tamanho do contexto e vazão definem se a carga de inferência cabe no sistema planejado.
INFERÊNCIA DE IA
Execute inferência em sistemas NVIDIA dedicados, dimensionados para a memória do modelo, a rede e a capacidade necessária. Combine computação com um plano de reserva claro para levar as cargas à produção.
O DESAFIO DA INFERÊNCIA
Um modelo em produção depende do equilíbrio entre memória, fluxo de dados e capacidade. Planejar esses pontos em conjunto deixa mais claro o caminho entre a implantação e o crescimento.
Memória, tamanho do contexto e vazão definem se a carga de inferência cabe no sistema planejado.
A execução depende de um caminho confiável entre os dados do modelo, a computação e o armazenamento da aplicação.
Prazos de reserva, capacidade disponível e um plano claro de expansão ajudam a orientar decisões de produção.
COMO A TENSORBAY AJUDA
MEMÓRIA DO MODELO01
Compare a memória por GPU e a configuração do nó com o tamanho do modelo, o contexto e os requisitos de execução.
Conheça os sistemas GPUFLUXO DE DADOS02
Planeje computação, rede e armazenamento em conjunto, considerando o caminho das solicitações e dos dados do modelo.
Explore rede e armazenamentoPLANO DE CAPACIDADE03
Consulte preços publicados e opções de capacidade dedicada com clareza sobre o cronograma do projeto.
Consulte preços e reservasEQUIPES QUE USAM TENSORBAY
CONTE COM QUEM CONHECE A STACK
Traga seu modelo, sua necessidade de capacidade e seu prazo. A equipe TensorBay ajuda a definir a configuração e os próximos passos.
Fale com vendas
05Invista no próximo passo
Escolha o prazo da reserva, compare a capacidade e planeje seu investimento. Aqui, a conversa começa com os preços abertos.
| GPU e memória | Contrato mensalReserva por contrato mensal | Contrato anualMenor valor por hora |
|---|---|---|
NVIDIAHGX B300288 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 83,20/h | Anual a partir de Cotar anualUS$ 58,50/h |
NVIDIAHGX B200180 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 72,80/h | Anual a partir de Cotar anualUS$ 50,70/h |
NVIDIAHGX H200141 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 44,20/h | Anual a partir de Cotar anualUS$ 31,20/h |
NVIDIAHGX H10080 GB HBM3 por GPU | Mensal a partir de Cotar mensalUS$ 28,60/h | Anual a partir de Cotar anualUS$ 19,50/h |
O valor por hora é do nó completo com 8 GPUs. Escolha o contrato para solicitar sua cotação.
Cada detalhe na conta
Veja o que está incluído e consulte as tarifas de armazenamento, transferência de dados e rede.
Falar com um especialistaValores em USD por hora de nó HGX com 8 GPUs; sistemas rack-scale são cotados por rack. Impostos não incluídos. Gerenciamento de Slurm e Kubernetes sem custo adicional. Armazenamento e Direct Connect seguem as tarifas acima. Consulte condições para contratos de longo prazo.
Receber minha propostaOs preços publicados para HGX são em USD por hora de um nó completo com 8 GPUs, dentro de uma reserva mensal ou anual. Sistemas NVL72 têm cotação por rack. Os valores não incluem impostos.
Compare a memória da GPU, os requisitos de rede e a carga de treinamento ou inferência. A seção de hardware apresenta H100, H200, B200, B300 e sistemas de rack completo. Nossa equipe ajuda a dimensionar a configuração a partir do modelo, dos dados e da capacidade necessária.
Sim. A TensorBay oferece infraestrutura dedicada de GPUs NVIDIA para treinamento de modelos, fine-tuning e inferência. Você pode trabalhar com Slurm, Kubernetes ou SSH e configurar o ambiente de software para sua carga de trabalho.
Informe a GPU, a capacidade e o prazo da reserva, ou conte sobre seu projeto. A equipe avalia os requisitos e prepara uma proposta em até 48 horas, com configuração e prazo de entrega. A capacidade e as condições finais são confirmadas na proposta.
CONHEÇA A TENSORBAY
Conheça as GPUs, a infraestrutura e os preços para levar seu projeto de IA adiante.
RESERVAS ANTECIPADAS
Veja a configuração Vera Rubin em escala de rack e o cronograma de reserva antecipada.
NVIDIA VR200 NVL72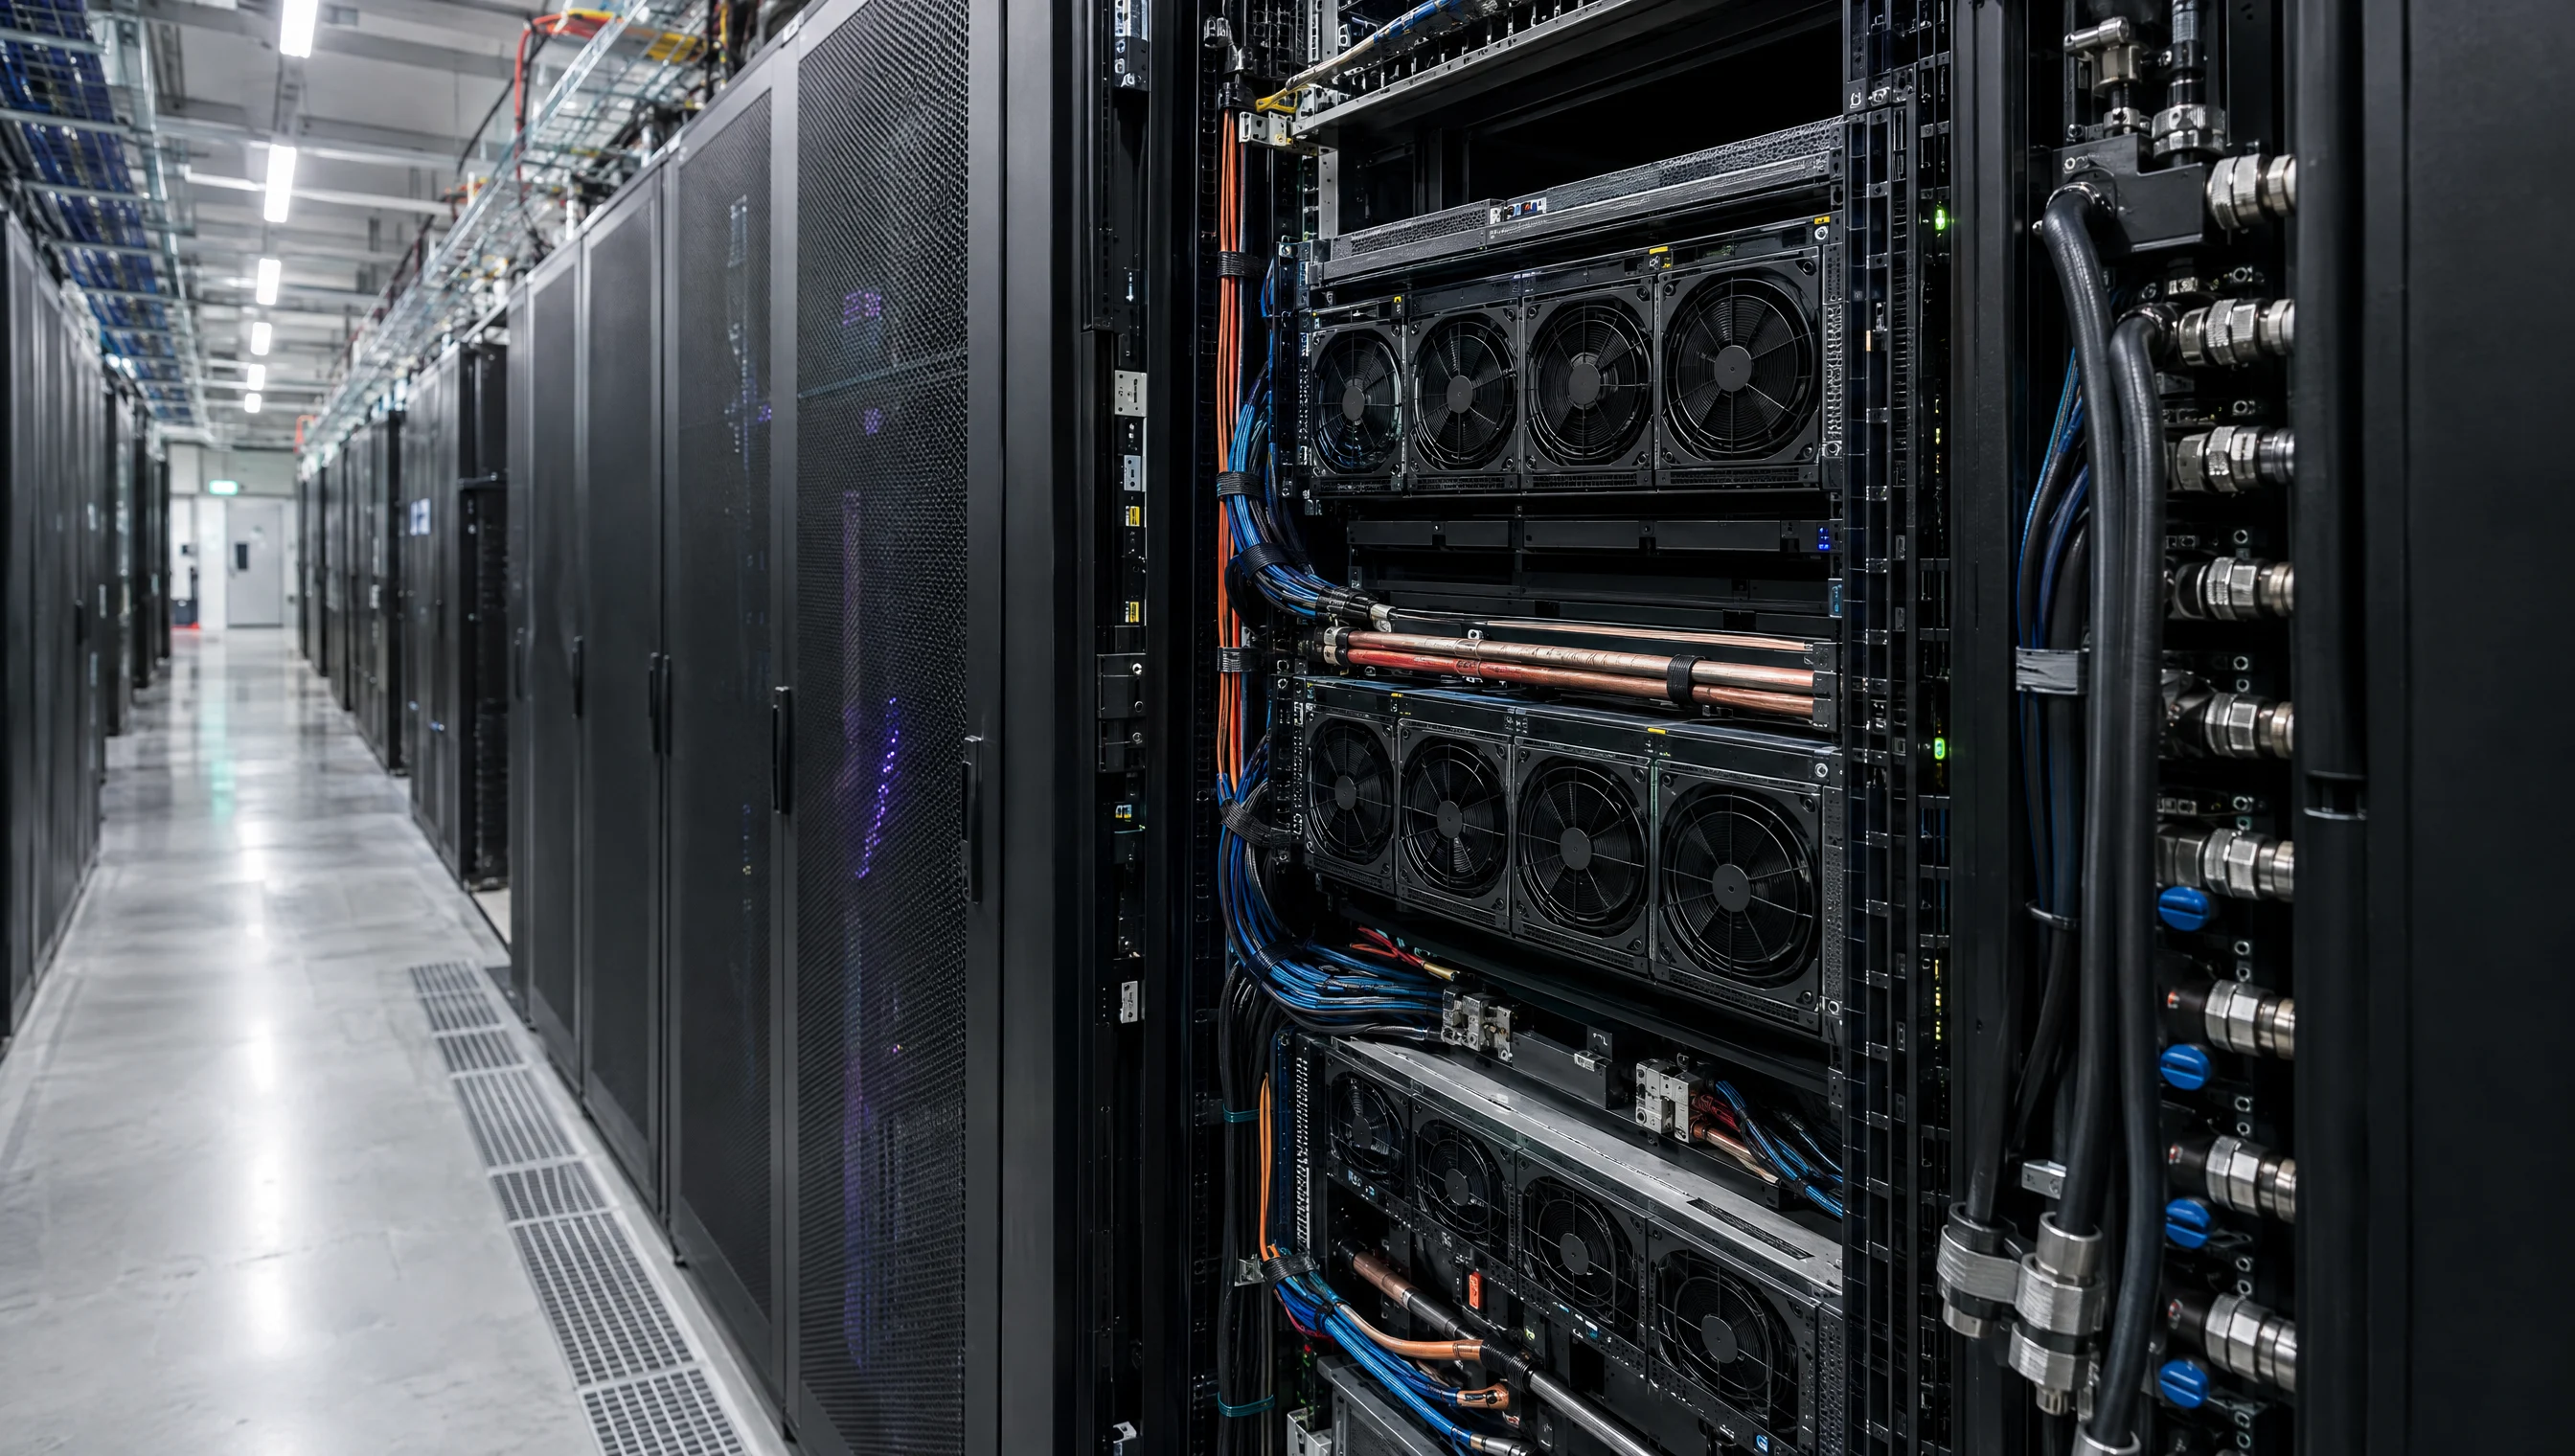
COMPUTAÇÃO GPU
Compare as configurações TensorBay, da geração mais nova às anteriores.
Encontre a GPU NVIDIA ideal
PREÇOS
Compare reservas mensais e anuais para nós GPU e sistemas em escala de rack.
Planeje com tarifas publicadas08Vamos dar escala à sua ideia
Traga seu desafio. Nossa equipe ajuda a definir as GPUs, a capacidade e o prazo. Em até 48 horas, você recebe uma proposta para tirar o projeto do papel ou levá-lo mais longe.
