A nuvem de GPUs para o seu próximo salto

Sua ambição.Nossa potência.IA em escala.

Treine modelos mais ambiciosos. Leve sua IA à produção. Com GPUs NVIDIA dedicadas, rede de alta velocidade e um cluster desenhado para o seu negócio.

Seu ponto de partida: 8 GPUs a partir de US$ 19,50/h · reserva anual

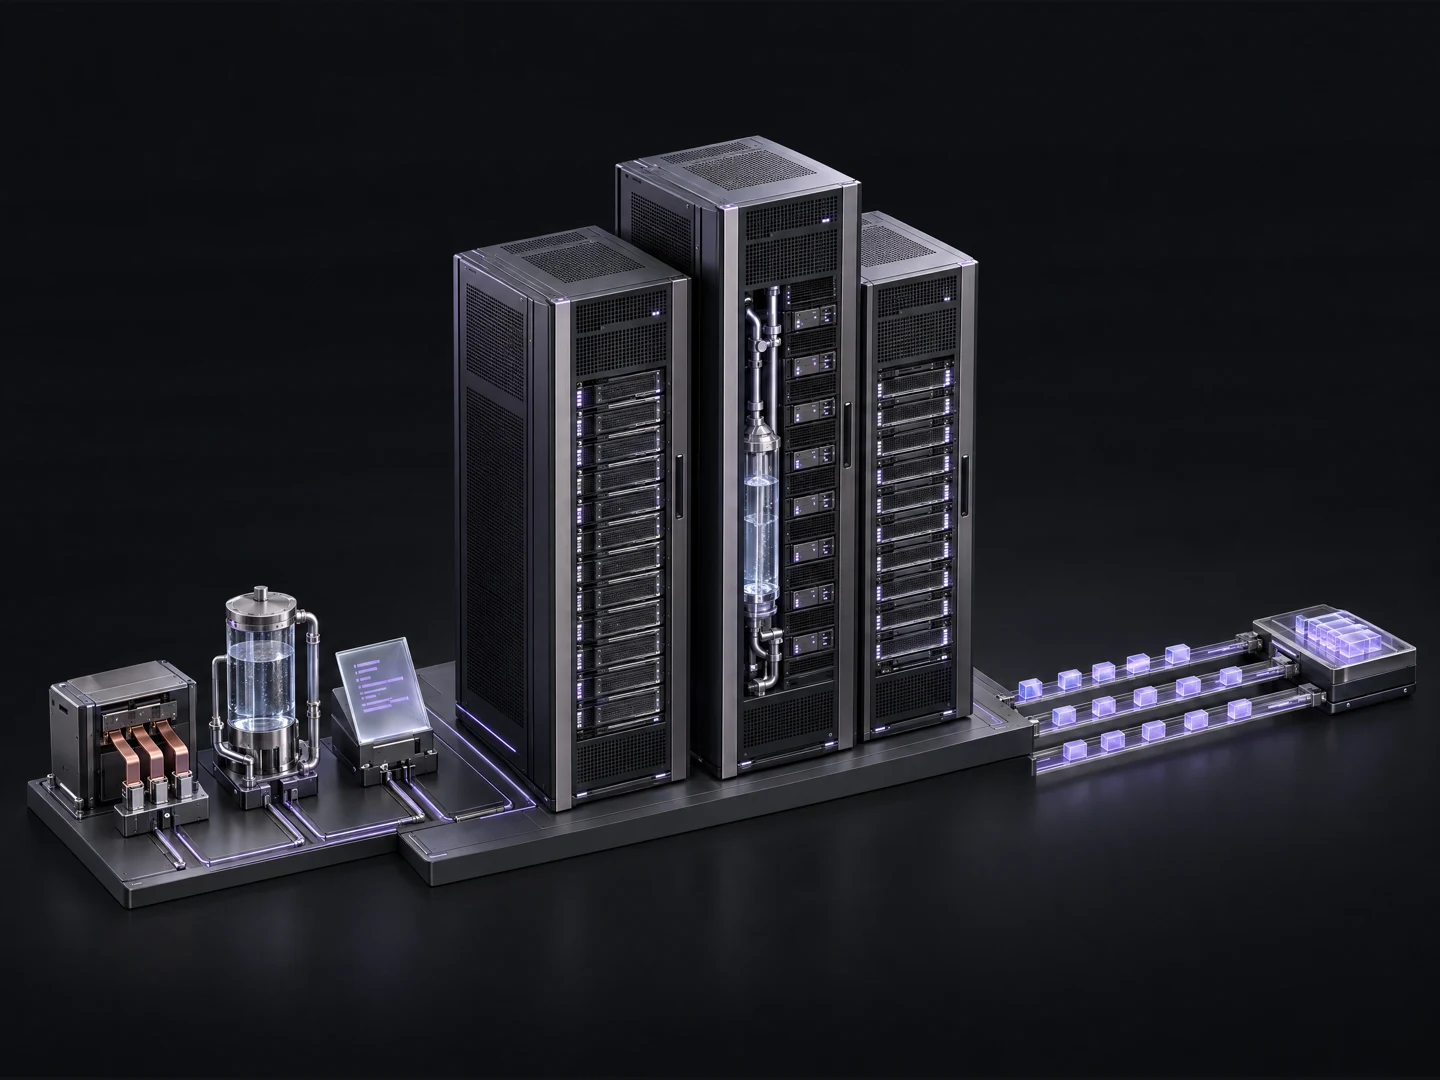
Energia elétrica, criatividade humana e resfriamento conectados a um cluster central de GPUs NVIDIA, com tokens de IA saindo do processamento.
  • Qwen
  • DeepSeek
  • Llama
  • Kimi K3
Potência dedicada à sua IANVIDIA DGX VR200
Sobrecarga de virtualização
0%
InfiniBand por nó
3,2 Tbps
Trabalho útil, últimos 90 dias
97,4%
Potência em 5 locais
1 GW

A potência por trás de quem já transforma negócios com IA.

  • Bank of America
  • Halliburton
  • BRF
  • PicPay
  • BMG Bank
  • Prefeitura do Rio de Janeiro
  • CNSesi
  • AICUBE
  • AirCloud

01Encontre sua potência

O próximo passo da sua IA começa com a GPU certa.

Treinamento, fine-tuning ou inferência: cada desafio pede uma configuração. Compare as opções e encontre a capacidade que faz sentido para sua equipe, seu modelo e seu orçamento.

Ver tabela de preços
NVIDIA HGX

B300

Mais memória para modelos e inferência em grande escala

288 GB HBM3eMemória por GPU
O que vem no nó
8 GPU · 30 TB NVMe · 2 TB RAM
Conexão entre nós
Quantum-X800 XDR 800G
Conhecer a configuração

Conexão entre GPUsNVLink 5 · 1,8 TB/s por GPU

Blackwell Ultra

Ver detalhes da HGX B300 ↗

Anual · reservado

a partir de$58,50/nó-hr

Cotar GPU
NVIDIA HGX

H200

Sirva modelos de contexto longo com mais memória

141 GB HBM3eMemória por GPU
O que vem no nó
8 GPU · 30 TB NVMe · 2 TB RAM
Conexão entre nós
8×400G IB NDR · 3,2 Tbps
Conhecer a configuração

Conexão entre GPUsNVLink 4 · 900 GB/s

Ver detalhes da HGX H200 ↗

Anual · reservado

a partir de$31,20/nó-hr

Cotar GPU
NVIDIA HGX

H100

Treinamento e fine-tuning com foco no orçamento

80 GB HBM3Memória por GPU
O que vem no nó
8 GPU · 15 TB NVMe · 2 TB RAM
Conexão entre nós
8×400G IB NDR · 3,2 Tbps
Conhecer a configuração

Conexão entre GPUsNVLink 4 · 900 GB/s

Versatilidade para sua equipe

Ver detalhes da HGX H100 ↗

Anual · reservado

a partir de$19,50/nó-hr

Cotar GPU

Preços em USD por hora de nó com 8 GPUs. Sistemas rack-scale têm cotação própria. Sujeitos à capacidade e às condições do contrato.

06Da pesquisa ao resultado

Sua próxima descoberta. Seu próximo produto. Sua próxima escala.

  • Treine o que vem depois

    Dê aos seus modelos fundacionais a capacidade que eles exigem. Clusters reservados, rede dedicada e nós de reposição sustentam a infraestrutura dos seus treinamentos mais ambiciosos.

    Explore B200, GB200 e GB300 →
  • Transforme conhecimento em vantagem

    Adapte modelos aos dados e desafios do seu negócio. Nós dedicados de 8 GPUs e armazenamento persistente dão à equipe espaço para testar, ajustar e evoluir.

    Encontre seu H100 ou H200 →
  • Coloque sua IA para trabalhar

    Leve modelos de grande porte à produção com GPUs de alta capacidade de memória. Atenda aplicações de contexto longo com a previsibilidade de uma infraestrutura dedicada.

    Conheça H200 e B300 →

02A vantagem TensorBay

Seu talento cria. Nossa infraestrutura acompanha.

Cada camada do cluster foi pensada para dar à sua equipe mais controle, previsibilidade e espaço para avançar.

  • F-01

    Toda a GPU a favor do seu modelo

    Execute direto no hardware, com a capacidade da máquina dedicada ao seu trabalho. Mais controle sobre o desempenho em cada etapa do projeto.

  • F-02

    Um cluster com o seu nome

    Nós, rede e armazenamento dedicados à sua operação. Sua equipe tem uma base exclusiva para treinar, experimentar e colocar a IA para trabalhar.

  • F-03

    Confiança antes do primeiro treinamento

    Seu cluster passa por 72 horas de testes de carga, memória, rede e temperatura. Você recebe os resultados e aprova a entrega com os números em mãos.

  • F-04

    Liberdade para construir do seu jeito

    Seus drivers, seus kernels, suas ferramentas. Trabalhe com Slurm, Kubernetes ou SSH e configure o ambiente para o que seu modelo precisa.

  • F-05

    Continuidade planejada desde o início

    Nós de reserva no mesmo rack e substituição prevista em SLA de 15 minutos. Uma estrutura preparada para reduzir o impacto de falhas no seu projeto.

  • F-06

    Clareza para planejar o próximo passo

    Tarifas publicadas, medição por minuto dentro da reserva e 20 TB de saída de dados incluídos por nó a cada mês. Decida com os custos na mesa.

03Infraestrutura que sustenta sua ambição

Por trás de cada avanço, uma base à altura.

Energia, refrigeração, GPUs e rede. Projetamos e operamos cada camada em conjunto para que sua IA tenha uma estrutura pronta para crescer.

  1. 01Energia

    1 GW

    Capacidade de energia contratada em cinco países para sustentar a expansão da nossa infraestrutura.

  2. 02Refrigeração

    PUE 1,12

    Refrigeração líquida direto nos chips, em racks de 130 kW. Eficiência projetada para cargas intensivas de IA.

  3. 03Capacidade de GPUs

    24.000+ GPUs

    Expansão em ciclos de seis semanas, com testes de 72 horas antes de cada entrega.

  4. 04Trabalho útil

    97,4%

    Goodput do cluster nos últimos 90 dias: a parcela de capacidade convertida em trabalho útil.

04Rede e armazenamento

Suas GPUs. Uma só força.

Conecte GPUs, dados e armazenamento em uma infraestrutura dedicada ao seu modelo, do primeiro lote de treinamento ao último checkpoint.

Planejar meu cluster

Rede dedicada

Rede à altura das suas GPUs.

InfiniBand dedicada conecta seu cluster com largura de banda para distribuir o treinamento e mover dados entre GPUs.

800Gb/s

por link InfiniBand XDR, Quantum-X800 para Blackwell

Especificações de rede
Fabric de treinamento, Hopper
8×400 Gb/s InfiniBand NDR por nó (3,2 Tbps), fat-tree non-blocking rail-optimized, redução in-network com SHARP
Fabric de treinamento, Blackwell
InfiniBand Quantum-X800 XDR, 800G por link; racks GB200 somam um domínio NVLink 5 coerente de 72 GPUs a 1,8 TB/s por GPU
Oversubscription
1:1, todos os tiers. Sem fabric east-west compartilhado, sem spine dividido com outros tenants
Rede front-end
Dupla 100 GbE por nó, proteção DDoS, suporte a BYO-IP

Armazenamento

Dê ritmo aos seus dados.

NVMe local, WEKA e armazenamento compatível com S3 para carregar datasets e salvar checkpoints na escala do seu projeto.

Até

720GB/s

de leitura agregada por pod, com WEKA dedicado

Especificações de armazenamento
Scratch local
30 TB NVMe Gen5 por nó, ~55 GB/s de leitura, staging de checkpoint sem tocar na rede
Filesystem paralelo
WEKA gerenciado, dedicado por cluster: até 720 GB/s de leitura agregada por pod, POSIX + GPUDirect Storage
Object storage
Compatível com S3, cache em NVMe, colocado junto ao compute, tier hot a $0,055/GB/mês

Transferência de dados

Leve seus dados mais longe.

Entrada de dados e tráfego entre nós sem cobrança, com uma franquia de saída incluída para planejar sua operação.

20TB

de saída incluídos por nó, por mês

Condições de transferência
Transferência de dados
Ingress $0 · 20 TB/nó/mês de egress incluído, depois $1,25/TB · inter-nó $0, Direct Connect 100G grátis em reservas anuais

A configuração de rede e armazenamento acompanha a arquitetura do seu cluster.Consultar tarifas e condições

05Invista no próximo passo

Potência para crescer. Clareza para investir.

Escolha o prazo da reserva, compare a capacidade e planeje seu investimento. Aqui, a conversa começa com os preços abertos.

USD por hora, nó completo com 8 GPUs

Nós de GPU, USD por hora, nó completo com 8 GPUs
GPU e memóriaContrato mensalReserva por contrato mensalContrato anualMenor valor por hora
NVIDIAHGX B300288 GB HBM3e por GPU
Mensal
a partir de
US$ 83,20/h
Cotar mensal
Anual
a partir de
US$ 58,50/h
Cotar anual
NVIDIAHGX B200180 GB HBM3e por GPU
Mensal
a partir de
US$ 72,80/h
Cotar mensal
Anual
a partir de
US$ 50,70/h
Cotar anual
NVIDIAHGX H200141 GB HBM3e por GPU
Mensal
a partir de
US$ 44,20/h
Cotar mensal
Anual
a partir de
US$ 31,20/h
Cotar anual
NVIDIAHGX H10080 GB HBM3 por GPU
Mensal
a partir de
US$ 28,60/h
Cotar mensal
Anual
a partir de
US$ 19,50/h
Cotar anual

O valor por hora é do nó completo com 8 GPUs. Escolha o contrato para solicitar sua cotação.

SLA
99,9% mensal + substituição de nó em 15 min + créditos de goodput
Escala
128–10.000+ GPUs · fabric dedicado por tenant
Cobrança
Medição por minuto dentro da reserva · $0 ingress

Cada detalhe na conta

Sua infraestrutura. Sem pontos cegos.

Veja o que está incluído e consulte as tarifas de armazenamento, transferência de dados e rede.

Falar com um especialista
Armazenamento
  • NVMe local (scratch), 30 TB por nóIncluído
  • Filesystem paralelo, WEKA gerenciadodedicado por cluster$0,09/GB/mês
  • Object storage, hot, compatível com S3cache NVMe, junto ao compute$0,055/GB/mês
  • Object storage, archive$0,015/GB/mês
  • Snapshots$0,021/GB/mês
Transferência de dados
  • Ingresssempre$0
  • Egress incluído20 TB/nó/mês
  • Excedente de egresstodos os sites$1,25/TB
  • Inter-nó / east-westfabric InfiniBand$0
Rede
  • Fabric InfiniBand east-westdedicado por clusterIncluído
  • VLAN privada / VPCIncluído
  • IPv4 público adicionalIPv6 grátis$4/IP-mês
  • BYO-IP, /24 v4 ou /48 v6setup $200Grátis
  • Firewall gerenciado$4/nó/mês
  • Proteção DDoSIncluído
  • Direct Connect 10G / 100G100G grátis no contrato anual$450 / $1.800-mês

Valores em USD por hora de nó HGX com 8 GPUs; sistemas rack-scale são cotados por rack. Impostos não incluídos. Gerenciamento de Slurm e Kubernetes sem custo adicional. Armazenamento e Direct Connect seguem as tarifas acima. Consulte condições para contratos de longo prazo.

Receber minha proposta

07Confiança para ir além

Sua inovação merece uma base segura.

Leve seus projetos à produção com hardware dedicado, isolamento físico e controles de acesso. Segurança faz parte da infraestrutura, desde o primeiro nó.

  • SOC 2 Type II

    Escopo: compute bare-metal, fabric e storage gerenciado

  • ISO 27001:2022

    Certificado, todos os sites de datacenter

  • HIPAA

    BAA disponível em clusters dedicados

  • GDPR

    Região UE com residência de dados no país

  • Hardware, rede e armazenamento fisicamente dedicados à sua operação
  • Dados criptografados em repouso e apagamento seguro na devolução do hardware
  • Destruição certificada das mídias retiradas de operação
  • Login corporativo, autenticação com chave de segurança e registros de auditoria imutáveis
  • Consulte o escopo e os relatórios em trust.tensorbay.com

Perguntas frequentes

Clareza para escolher seu próximo cluster.

Falar com um especialista
O preço é por GPU ou por nó?

Os preços publicados para HGX são em USD por hora de um nó completo com 8 GPUs, dentro de uma reserva mensal ou anual. Sistemas NVL72 têm cotação por rack. Os valores não incluem impostos.

Qual GPU NVIDIA devo escolher para meu projeto de IA?

Compare a memória da GPU, os requisitos de rede e a carga de treinamento ou inferência. A seção de hardware apresenta H100, H200, B200, B300 e sistemas de rack completo. Nossa equipe ajuda a dimensionar a configuração a partir do modelo, dos dados e da capacidade necessária.

Posso usar o cluster para treinamento, fine-tuning e inferência?

Sim. A TensorBay oferece infraestrutura dedicada de GPUs NVIDIA para treinamento de modelos, fine-tuning e inferência. Você pode trabalhar com Slurm, Kubernetes ou SSH e configurar o ambiente de software para sua carga de trabalho.

O que acontece depois que eu peço uma cotação?

Informe a GPU, a capacidade e o prazo da reserva, ou conte sobre seu projeto. A equipe avalia os requisitos e prepara uma proposta em até 48 horas, com configuração e prazo de entrega. A capacidade e as condições finais são confirmadas na proposta.

08Vamos dar escala à sua ideia

O próximo salto da sua IA começa com uma conversa.

Traga seu desafio. Nossa equipe ajuda a definir as GPUs, a capacidade e o prazo. Em até 48 horas, você recebe uma proposta para tirar o projeto do papel ou levá-lo mais longe.

  • Configuração alinhada ao seu projeto
  • Proposta com prazo de entrega
  • Testes de aceitação antes de começar
tensorbay@tensorbay.io