
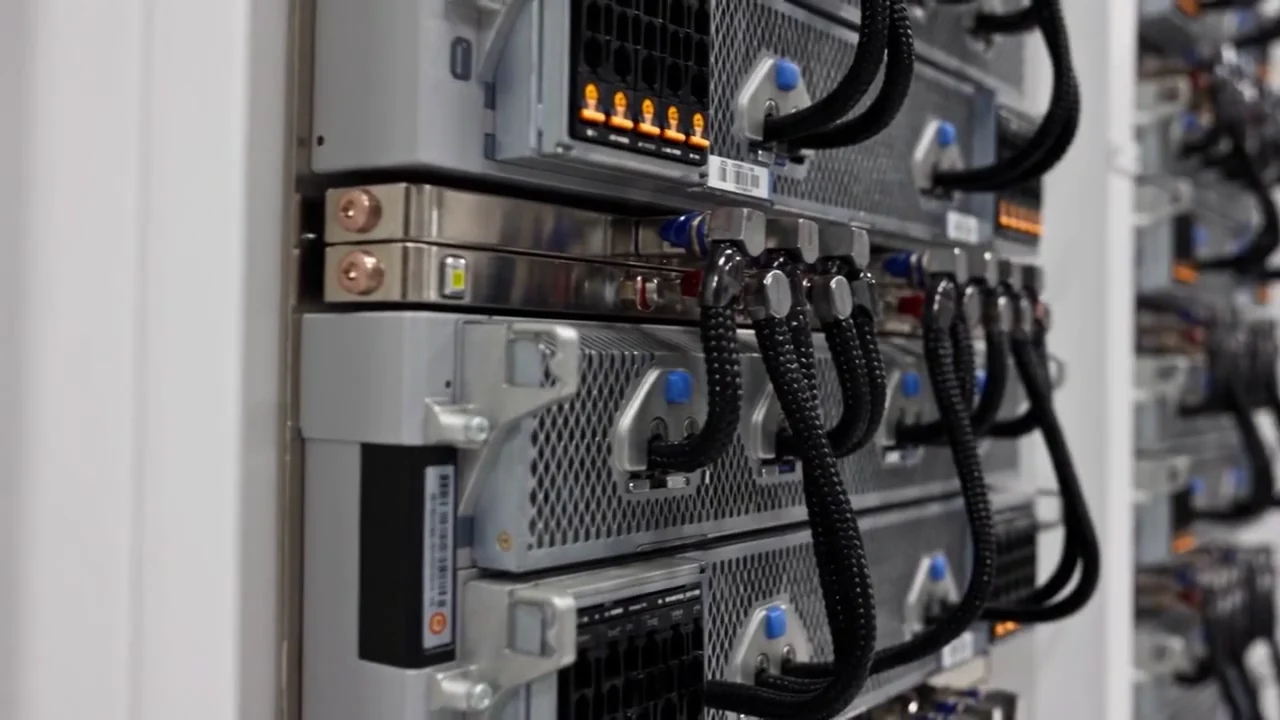
Link InfiniBand XDR em sistemas Blackwell selecionados.
REDE E ARMAZENAMENTO PARA IA
Mantenha cada GPU em sintonia com seus dados.
Treinamento distribuído exige mais do que aceleradores rápidos. Planeje InfiniBand dedicada, NVMe e armazenamento compartilhado como um único caminho de dados para seu cluster GPU.
REDE, ARMAZENAMENTO E TRANSFERÊNCIA, PLANEJADOS EM CONJUNTO
Leitura agregada por pod com WEKA dedicada.
De saída de dados incluídos por nó, por mês.
De NVMe local em nós HGX selecionados.
ACOMPANHE O FLUXO DOS DADOS
Um caminho claro da carga de trabalho ao checkpoint.
Planeje computação, rede do cluster e armazenamento como partes de uma configuração. O caminho ideal depende do formato da tarefa, do paralelismo e de como ela salva os dados.
01 COMPUTAÇÃO
Nós GPU dedicados
Escolha capacidade por nó ou em escala de rack de acordo com o modelo, a memória e o tipo de carga.
02 INTERCONEXÃO
InfiniBand para o cluster
Conecte as GPUs com uma rede dedicada de alta velocidade, planejada para a comunicação entre nós.
03 DADOS
Armazenamento para cada etapa
Combine NVMe local, sistema de arquivos paralelo e armazenamento de objetos compatível com S3 para dados e checkpoints.
TENSORBAY AIFACTORY01 / 03
COMPUTAÇÃO
Nós GPU dedicados04Rede e armazenamento
Suas GPUs. Uma só força.
Conecte GPUs, dados e armazenamento em uma infraestrutura dedicada ao seu modelo, do primeiro lote de treinamento ao último checkpoint.
Planejar meu clusterRede dedicada
Rede à altura das suas GPUs.
InfiniBand dedicada conecta seu cluster com largura de banda para distribuir o treinamento e mover dados entre GPUs.
800Gb/s
por link InfiniBand XDR, Quantum-X800 para Blackwell

Especificações de rede
- Fabric de treinamento, Hopper
- 8×400 Gb/s InfiniBand NDR por nó (3,2 Tbps), fat-tree non-blocking rail-optimized, redução in-network com SHARP
- Fabric de treinamento, Blackwell
- InfiniBand Quantum-X800 XDR, 800G por link; racks GB200 somam um domínio NVLink 5 coerente de 72 GPUs a 1,8 TB/s por GPU
- Oversubscription
- 1:1, todos os tiers. Sem fabric east-west compartilhado, sem spine dividido com outros tenants
- Rede front-end
- Dupla 100 GbE por nó, proteção DDoS, suporte a BYO-IP
Armazenamento
Dê ritmo aos seus dados.
NVMe local, WEKA e armazenamento compatível com S3 para carregar datasets e salvar checkpoints na escala do seu projeto.
Até
720GB/s
de leitura agregada por pod, com WEKA dedicado
Especificações de armazenamento
- Scratch local
- 30 TB NVMe Gen5 por nó, ~55 GB/s de leitura, staging de checkpoint sem tocar na rede
- Filesystem paralelo
- WEKA gerenciado, dedicado por cluster: até 720 GB/s de leitura agregada por pod, POSIX + GPUDirect Storage
- Object storage
- Compatível com S3, cache em NVMe, colocado junto ao compute, tier hot a $0,055/GB/mês
Transferência de dados
Leve seus dados mais longe.
Entrada de dados e tráfego entre nós sem cobrança, com uma franquia de saída incluída para planejar sua operação.
20TB
de saída incluídos por nó, por mês
Condições de transferência
- Transferência de dados
- Ingress $0 · 20 TB/nó/mês de egress incluído, depois $1,25/TB · inter-nó $0, Direct Connect 100G grátis em reservas anuais
TESTADO ANTES DA ENTREGA
Comece com um cluster em que sua equipe pode confiar.
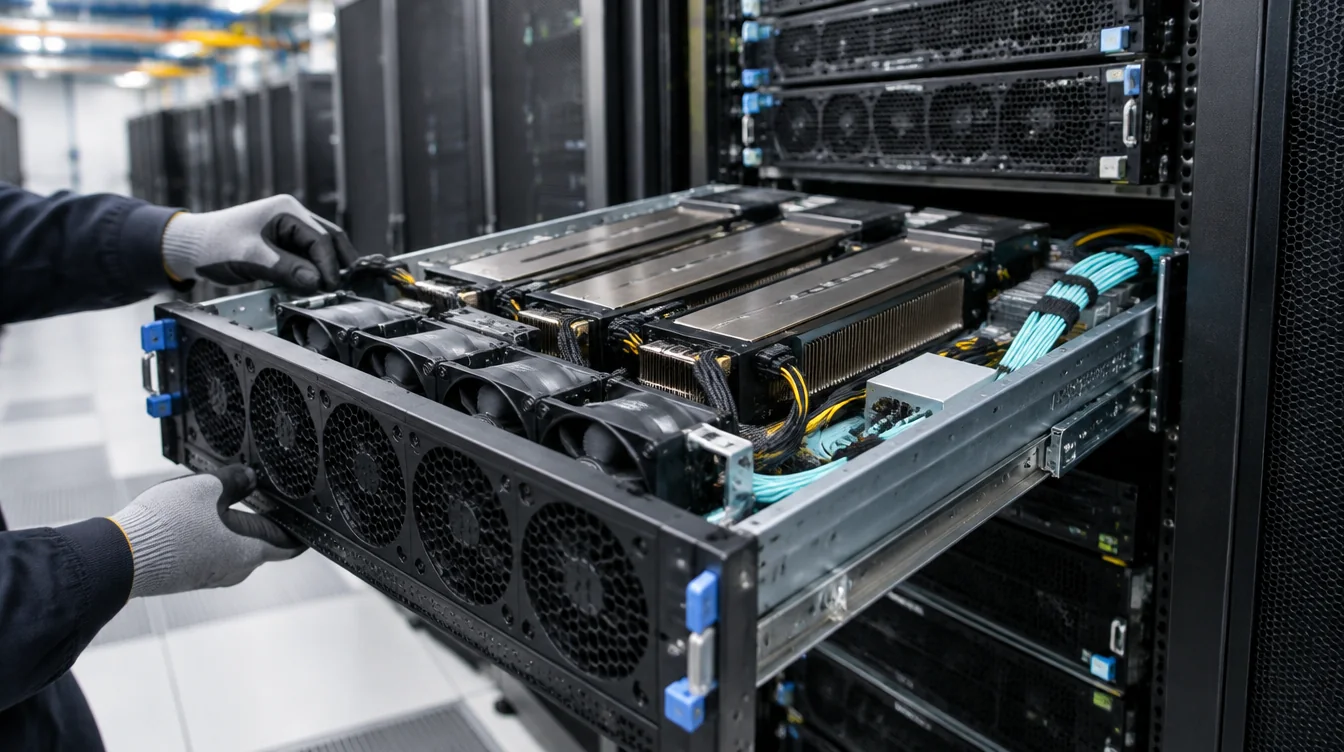
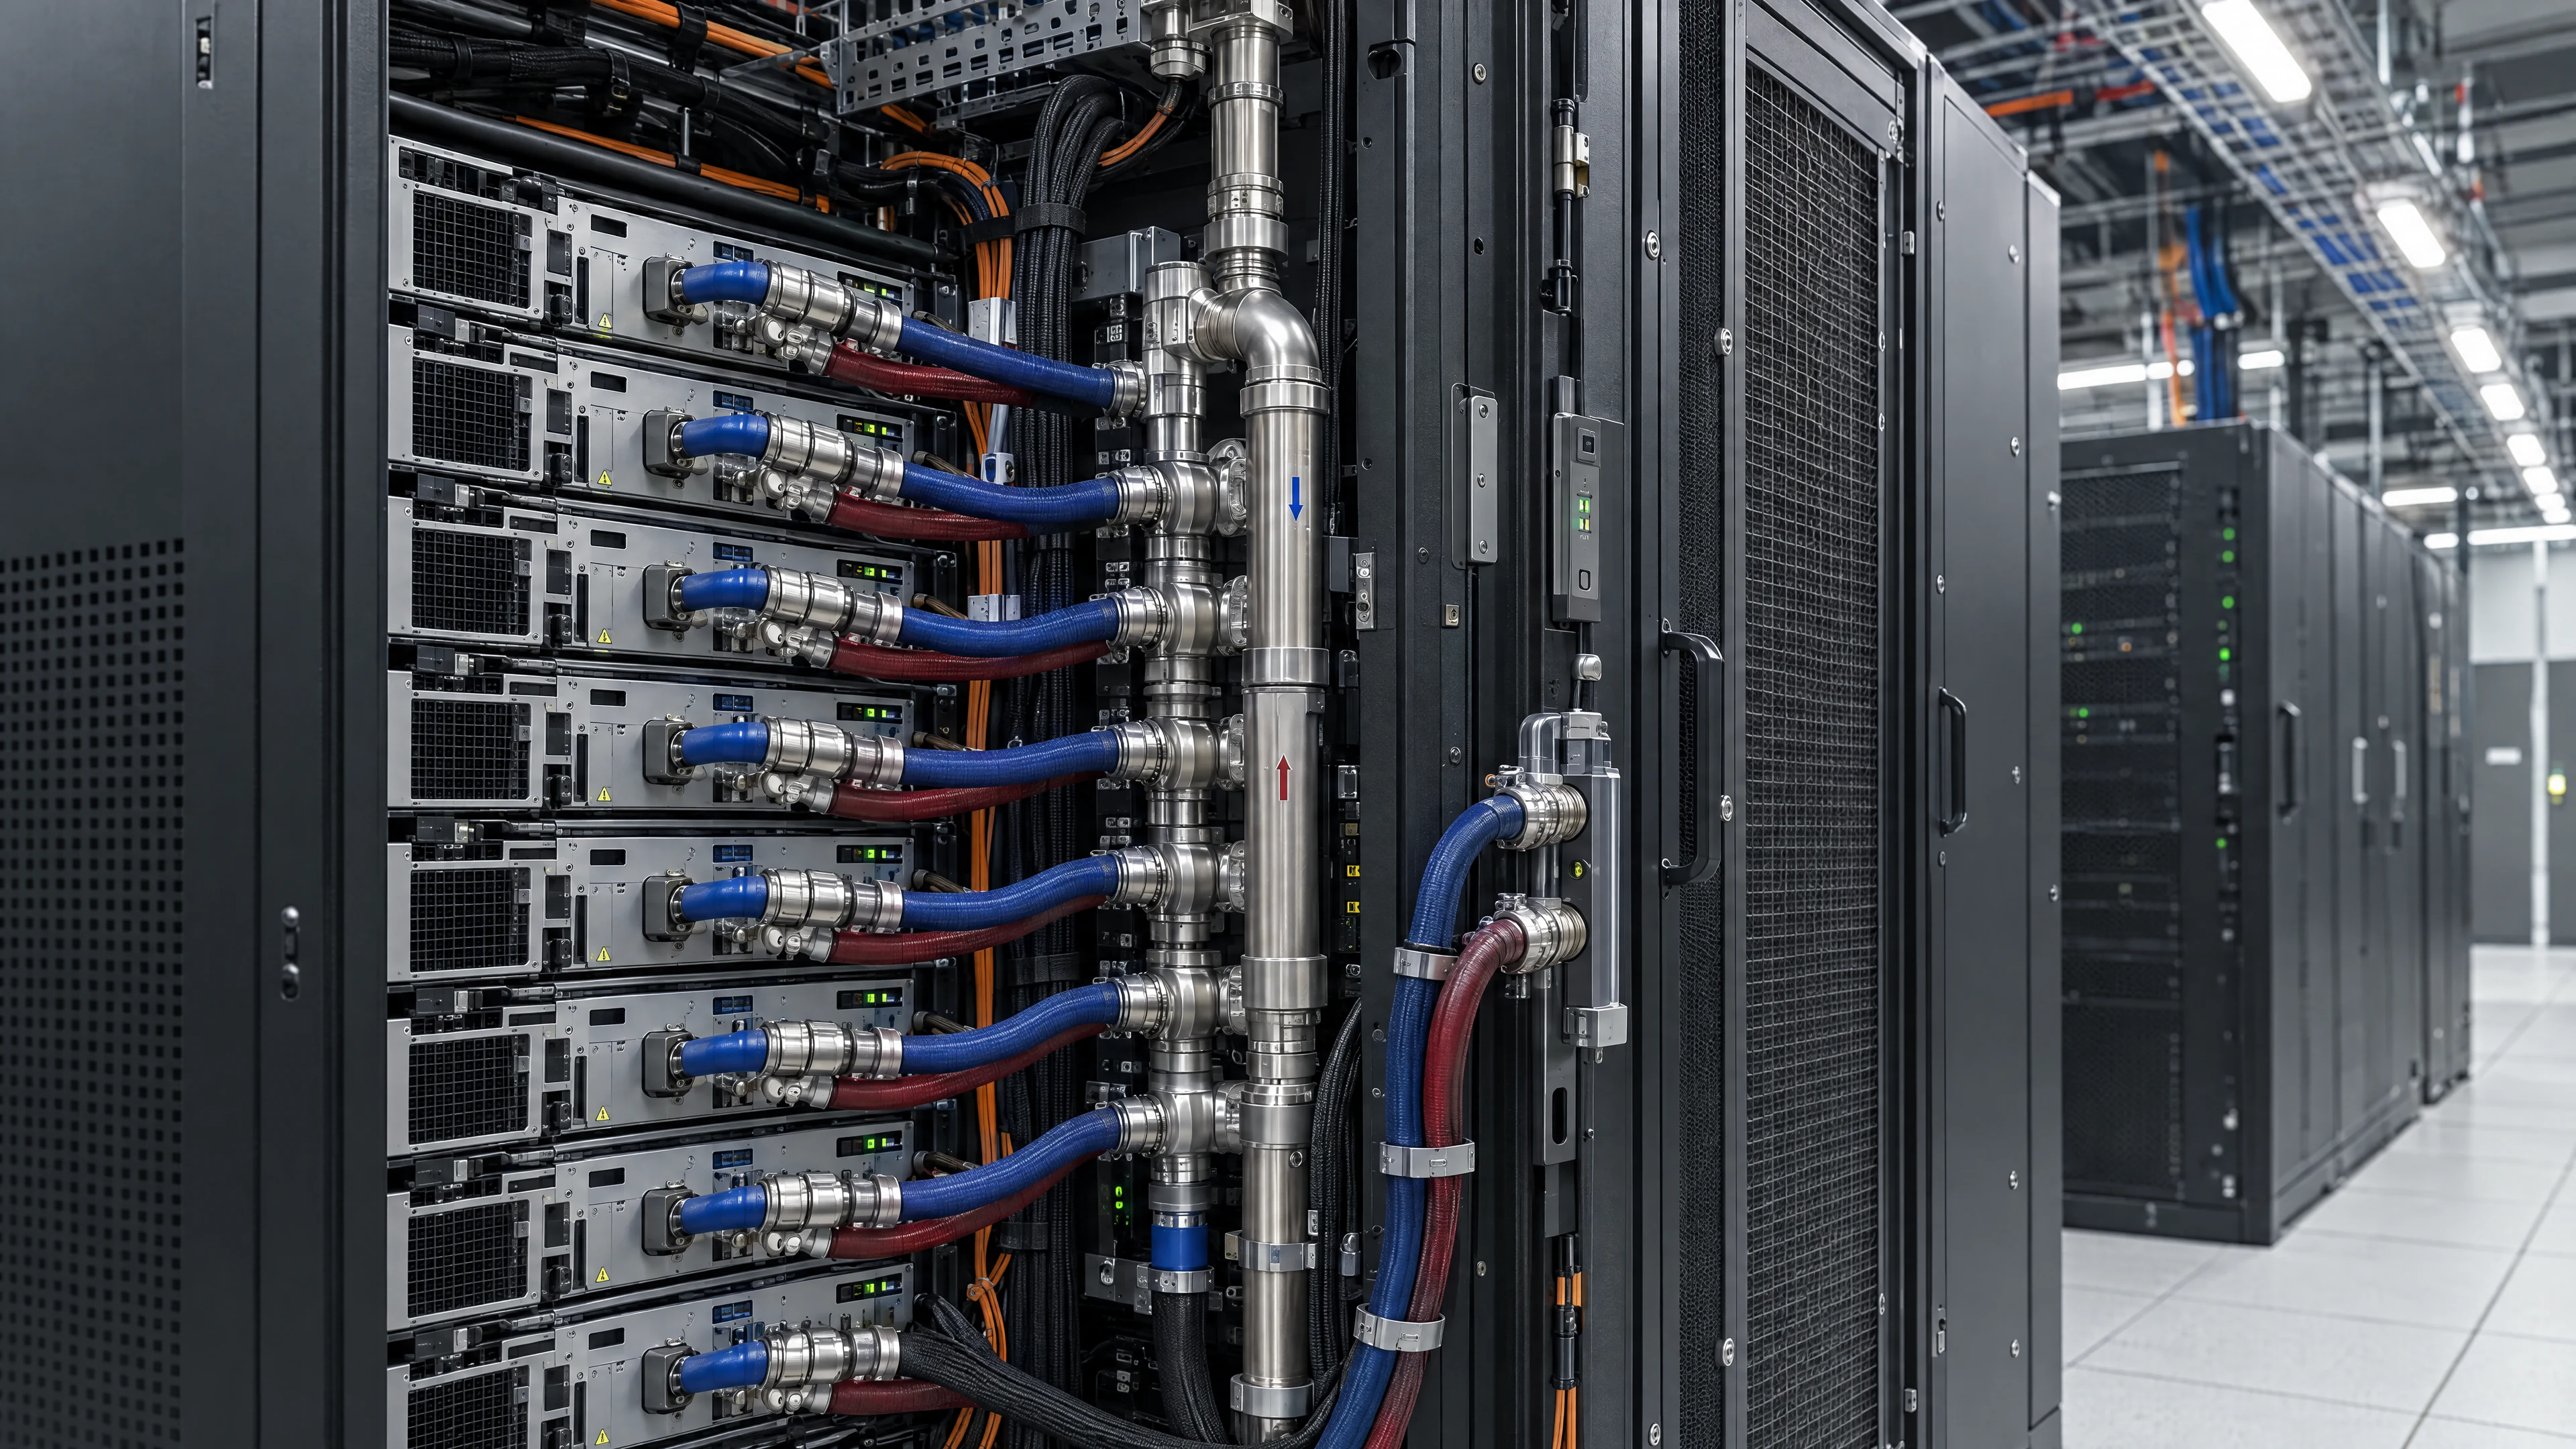
Cada cluster passa por 72 horas de testes de carga, memória, rede e temperatura. Sua equipe analisa os resultados antes de aprovar a entrega.
72h
TESTES DE ACEITAÇÃO
Testes de carga · memória · rede · temperatura
CARGAS DE TRABALHO DE IA
- TENSORBAY AIFACTORYTreinamento de modelosGPUs dedicadas e rede de alta velocidade para execuções longas de treinamento.
- TENSORBAY AIFACTORYAjuste fino e pesquisaNós de 8 GPUs para adaptar modelos e iterar em experimentos.
- TENSORBAY AIFACTORYInferência em produçãoSistemas com mais memória para servir modelos em infraestrutura dedicada.
CONTE COM QUEM CONHECE A STACK
Gente que entende de infraestrutura, por perto.
Traga seu modelo, sua necessidade de capacidade e seu prazo. A equipe TensorBay ajuda a definir a configuração e os próximos passos.
Fale com vendas
- 01Configuração alinhada ao seu projeto
- 02Proposta com prazo de entrega
- 03Testes de aceitação antes de começar
05Invista no próximo passo
Potência para crescer. Clareza para investir.
Escolha o prazo da reserva, compare a capacidade e planeje seu investimento. Aqui, a conversa começa com os preços abertos.
| GPU e memória | Contrato mensalReserva por contrato mensal | Contrato anualMenor valor por hora |
|---|---|---|
NVIDIAHGX B300288 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 83,20/h | Anual a partir de Cotar anualUS$ 58,50/h |
NVIDIAHGX B200180 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 72,80/h | Anual a partir de Cotar anualUS$ 50,70/h |
NVIDIAHGX H200141 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 44,20/h | Anual a partir de Cotar anualUS$ 31,20/h |
NVIDIAHGX H10080 GB HBM3 por GPU | Mensal a partir de Cotar mensalUS$ 28,60/h | Anual a partir de Cotar anualUS$ 19,50/h |
O valor por hora é do nó completo com 8 GPUs. Escolha o contrato para solicitar sua cotação.
- SLA
- 99,9% mensal + substituição de nó em 15 min + créditos de goodput
- Escala
- 128–10.000+ GPUs · fabric dedicado por tenant
- Cobrança
- Medição por minuto dentro da reserva · $0 ingress
Cada detalhe na conta
Sua infraestrutura. Sem pontos cegos.
Veja o que está incluído e consulte as tarifas de armazenamento, transferência de dados e rede.
Falar com um especialistaArmazenamento
- NVMe local (scratch), 30 TB por nóIncluído
- Filesystem paralelo, WEKA gerenciadodedicado por cluster$0,09/GB/mês
- Object storage, hot, compatível com S3cache NVMe, junto ao compute$0,055/GB/mês
- Object storage, archive$0,015/GB/mês
- Snapshots$0,021/GB/mês
Transferência de dados
- Ingresssempre$0
- Egress incluído20 TB/nó/mês
- Excedente de egresstodos os sites$1,25/TB
- Inter-nó / east-westfabric InfiniBand$0
Rede
- Fabric InfiniBand east-westdedicado por clusterIncluído
- VLAN privada / VPCIncluído
- IPv4 público adicionalIPv6 grátis$4/IP-mês
- BYO-IP, /24 v4 ou /48 v6setup $200Grátis
- Firewall gerenciado$4/nó/mês
- Proteção DDoSIncluído
- Direct Connect 10G / 100G100G grátis no contrato anual$450 / $1.800-mês
Valores em USD por hora de nó HGX com 8 GPUs; sistemas rack-scale são cotados por rack. Impostos não incluídos. Gerenciamento de Slurm e Kubernetes sem custo adicional. Armazenamento e Direct Connect seguem as tarifas acima. Consulte condições para contratos de longo prazo.
Receber minha propostaO preço é por GPU ou por nó?
Os preços publicados para HGX são em USD por hora de um nó completo com 8 GPUs, dentro de uma reserva mensal ou anual. Sistemas NVL72 têm cotação por rack. Os valores não incluem impostos.
Qual GPU NVIDIA devo escolher para meu projeto de IA?
Compare a memória da GPU, os requisitos de rede e a carga de treinamento ou inferência. A seção de hardware apresenta H100, H200, B200, B300 e sistemas de rack completo. Nossa equipe ajuda a dimensionar a configuração a partir do modelo, dos dados e da capacidade necessária.
Posso usar o cluster para treinamento, fine-tuning e inferência?
Sim. A TensorBay oferece infraestrutura dedicada de GPUs NVIDIA para treinamento de modelos, fine-tuning e inferência. Você pode trabalhar com Slurm, Kubernetes ou SSH e configurar o ambiente de software para sua carga de trabalho.
O que acontece depois que eu peço uma cotação?
Informe a GPU, a capacidade e o prazo da reserva, ou conte sobre seu projeto. A equipe avalia os requisitos e prepara uma proposta em até 48 horas, com configuração e prazo de entrega. A capacidade e as condições finais são confirmadas na proposta.
08Vamos dar escala à sua ideia
Mantenha o trabalho de IA em movimento com o caminho certo para os dados.
Conte para nós sobre suas GPUs, seus dados e seu padrão de treinamento ou inferência. Vamos ajudar a planejar rede e armazenamento para sua carga de trabalho.
- Configuração alinhada ao seu projeto
- Proposta com prazo de entrega
- Testes de aceitação antes de começar