
Enlace InfiniBand XDR en sistemas Blackwell seleccionados.
RED Y ALMACENAMIENTO PARA IA
Mantén cada GPU sincronizada con tus datos.
El entrenamiento distribuido necesita más que aceleradores rápidos. Planifica InfiniBand dedicada, NVMe y almacenamiento compartido como una sola ruta de datos para tu clúster GPU.
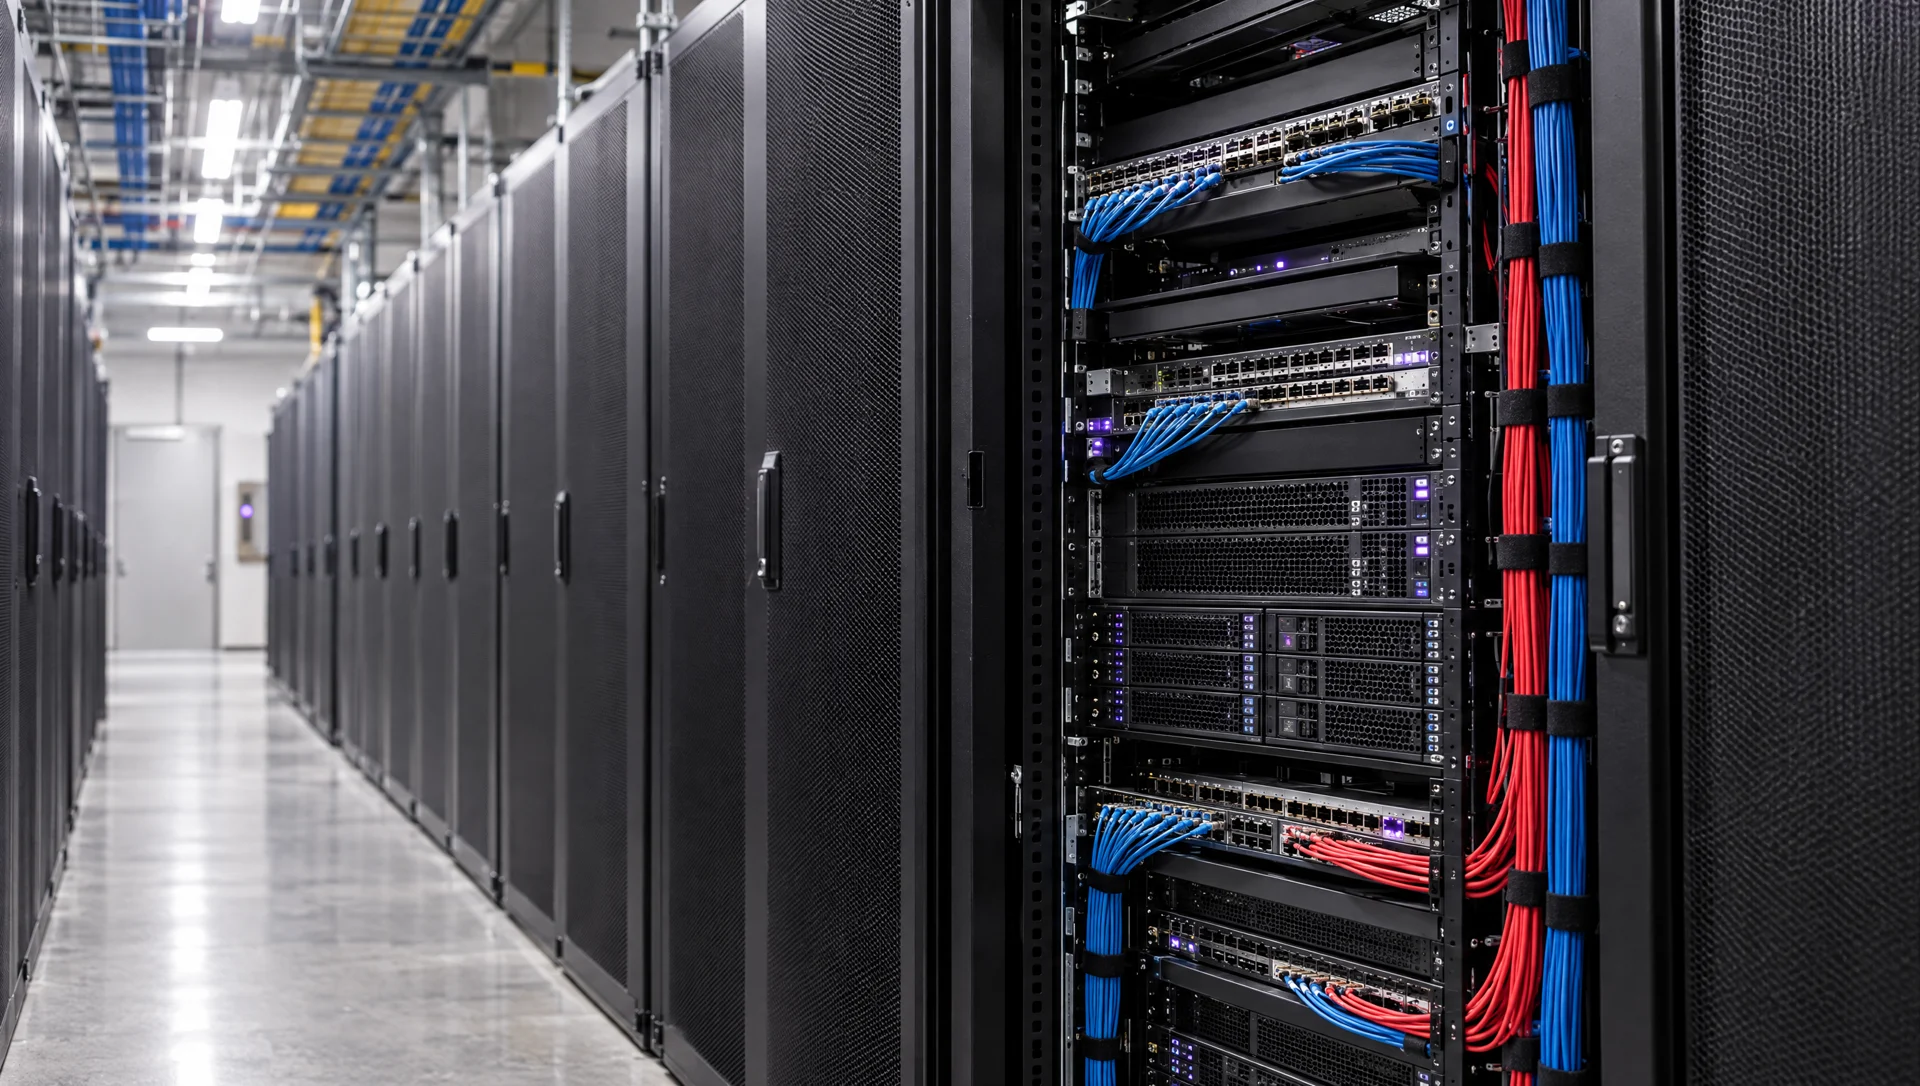
RED, ALMACENAMIENTO Y TRANSFERENCIA, PLANIFICADOS EN CONJUNTO
Lectura agregada por pod con WEKA dedicada.
De salida de datos incluidos por nodo al mes.
De NVMe local en nodos HGX seleccionados.
SIGUE EL RECORRIDO DE LOS DATOS
Una ruta clara de la carga de trabajo al checkpoint.
Planifica cómputo, red del clúster y almacenamiento dentro de una misma configuración. La ruta adecuada depende del tipo de tarea, del paralelismo y de cómo guarda los datos.
01 CÓMPUTO
Nodos GPU dedicados
Elige capacidad por nodo o a escala de rack según tu modelo, memoria y carga de trabajo.
02 INTERCONEXIÓN
InfiniBand para el clúster
Conecta las GPU mediante una red dedicada de alta velocidad, planificada para la comunicación entre nodos.
03 DATOS
Almacenamiento para cada etapa
Combina NVMe local, sistema de archivos paralelo y almacenamiento de objetos compatible con S3 para datos y checkpoints.
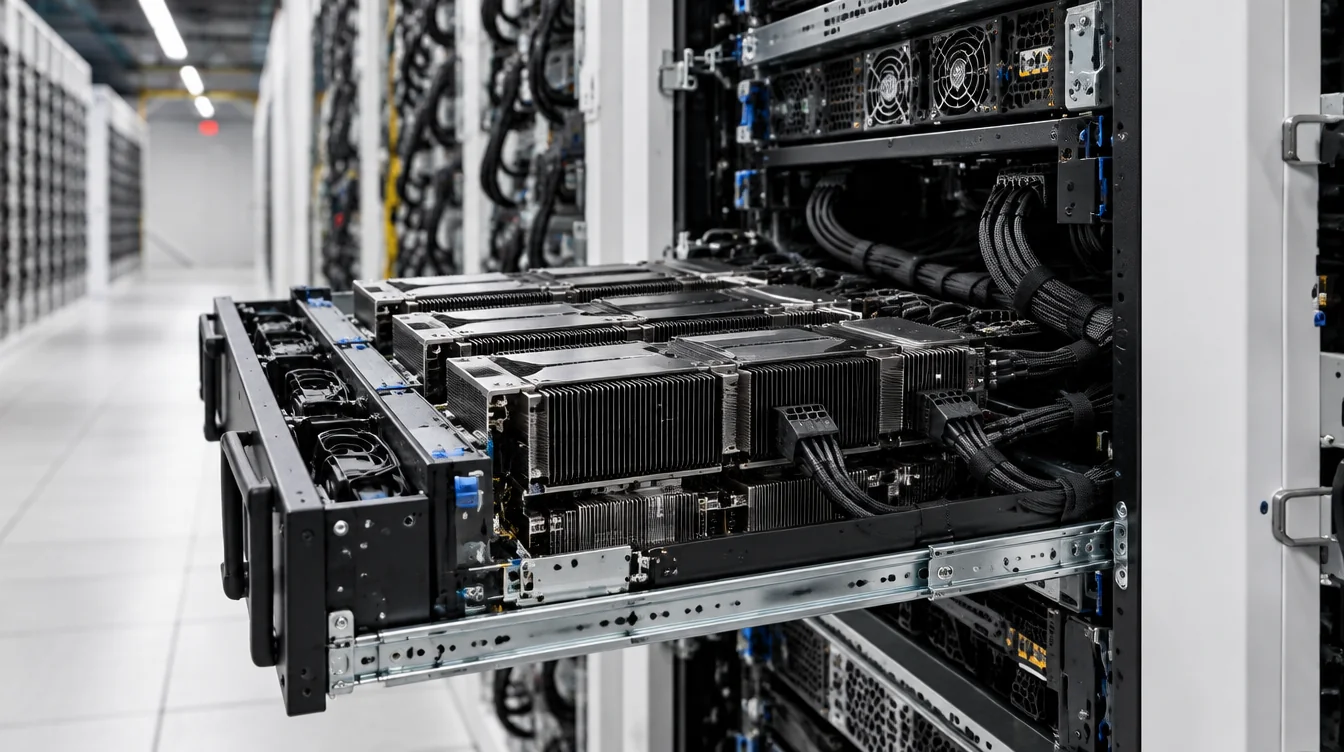
TENSORBAY AIFACTORY01 / 03
CÓMPUTO
Nodos GPU dedicados04Red y almacenamiento
Tus GPU. Una sola fuerza.
Conecta GPU, datos y almacenamiento en una infraestructura dedicada a tu modelo, desde el primer lote de entrenamiento hasta el último checkpoint.
Planificar mi clústerRed dedicada
Una red a la altura de tus GPU.
InfiniBand dedicada conecta tu clúster con ancho de banda para distribuir el entrenamiento y mover datos entre GPU.
800Gb/s
por enlace InfiniBand XDR, Quantum-X800 para Blackwell

Especificaciones de red
- Fabric de entrenamiento — Hopper
- 8×400 Gb/s InfiniBand NDR por nodo (3.2 Tbps), fat-tree non-blocking rail-optimized, reducción en red con SHARP
- Fabric de entrenamiento — Blackwell
- InfiniBand XDR Quantum-X800, 800G por enlace; los racks GB200 añaden un dominio NVLink 5 coherente de 72 GPUs a 1.8 TB/s por GPU
- Sobresuscripción
- 1:1 en todos los niveles. Sin fabric este-oeste compartido, sin spine mezclado con otros tenants
- Red front-end
- Doble 100 GbE por nodo, con protección DDoS y soporte BYO-IP
Almacenamiento
Dale ritmo a tus datos.
NVMe local, WEKA y almacenamiento compatible con S3 para cargar datasets y guardar checkpoints a la escala de tu proyecto.
Hasta
720GB/s
de lectura agregada por pod, con WEKA dedicado
Especificaciones de almacenamiento
- Scratch local
- 30 TB NVMe Gen5 por nodo, ~55 GB/s de lectura — staging de checkpoints sin tocar la red
- Sistema de ficheros paralelo
- WEKA gestionado, dedicado por clúster: hasta 720 GB/s de lectura agregada por pod, POSIX + GPUDirect Storage
- Almacenamiento de objetos
- Compatible S3, con caché NVMe, colocado junto al cómputo — $0.055/GB-mes en el nivel hot
Transferencia de datos
Lleva tus datos más lejos.
Entrada de datos y tráfico entre nodos sin cargos, con una cuota de salida incluida para planificar tu operación.
20TB
de salida incluidos por nodo, por mes
Condiciones de transferencia
- Transferencia de datos
- Ingress $0 · 20 TB/nodo-mes de egress incluido, después $1.25/TB · inter-nodo $0. Direct Connect 100G gratis en reservas anuales
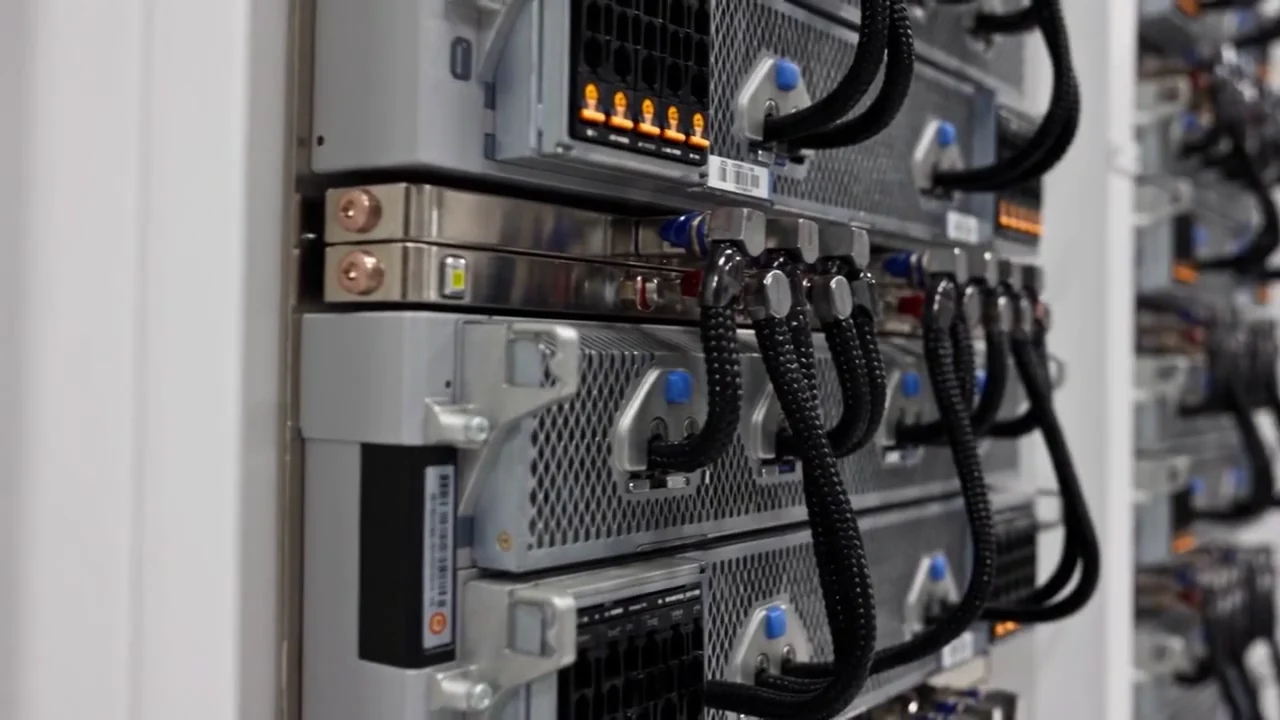
PROBADO ANTES DE LA ENTREGA
Empieza con un clúster en el que tu equipo pueda confiar.
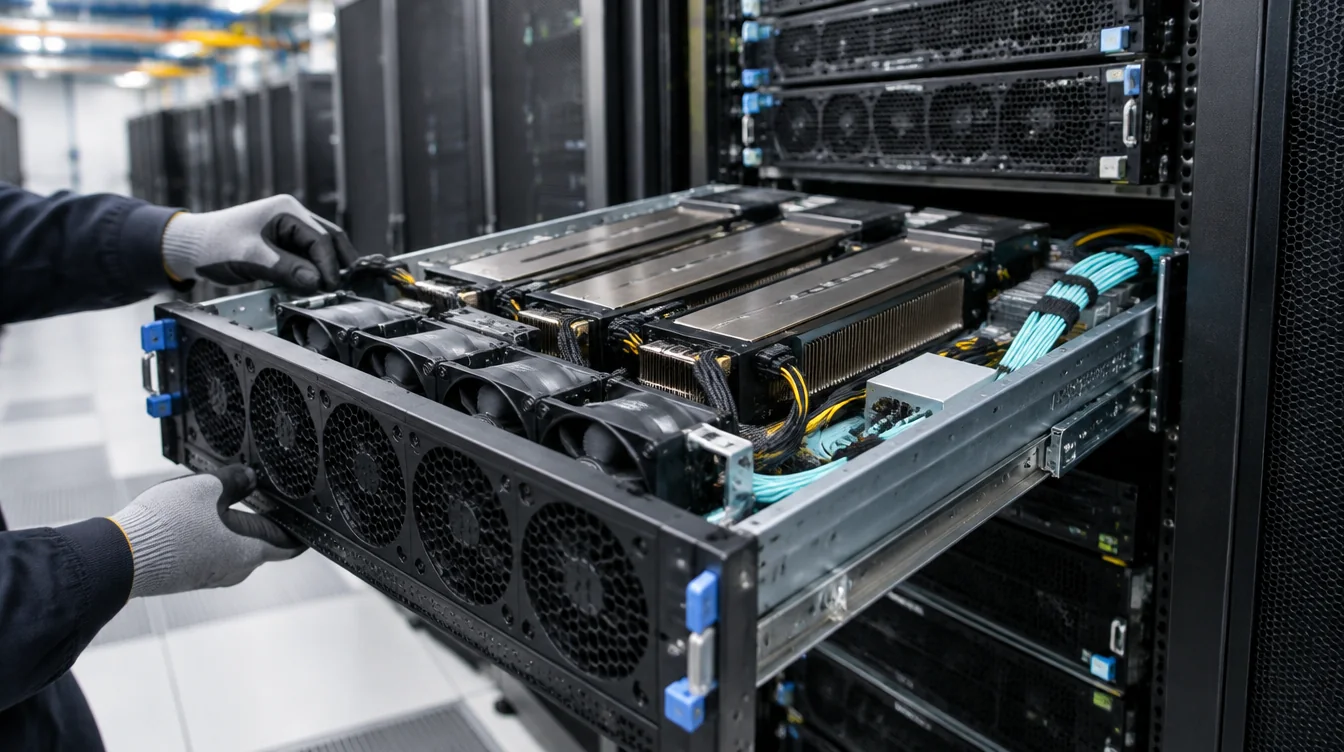
Cada clúster pasa por 72 horas de pruebas de carga, memoria, red y temperatura. Tu equipo revisa los resultados antes de aprobar la entrega.
72h
PRUEBAS DE ACEPTACIÓN
Pruebas de carga · memoria · red · temperatura
CARGAS DE TRABAJO DE IA
- TENSORBAY AIFACTORYEntrenamiento de modelosGPU dedicadas y red de alta velocidad para entrenamientos prolongados.
- TENSORBAY AIFACTORYAjuste fino e investigaciónNodos de 8 GPU para adaptar modelos e iterar en experimentos.
- TENSORBAY AIFACTORYInferencia en producciónSistemas con más memoria para servir modelos en infraestructura dedicada.
NO CONSTRUYAS EN SOLEDAD
Personas que conocen la infraestructura, a tu alcance.
Cuéntanos sobre tu modelo, capacidad y plazos. El equipo de TensorBay puede ayudarte a definir la configuración y los próximos pasos.
Habla con ventas
- 01Configuración alineada con tu proyecto
- 02Propuesta con plazo de entrega
- 03Pruebas de aceptación antes de empezar
05Invierte en tu próximo paso
Potencia para crecer. Claridad para invertir.
Elige el plazo de reserva, compara la capacidad y planifica tu inversión. Aquí, la conversación empieza con los precios a la vista.
| GPU y memoria | Plazo mensualReserva con contrato mensual | Plazo anualMenor precio por hora |
|---|---|---|
NVIDIAHGX B300288 GB HBM3e por GPU | Mensual desde Cotizar mensualUS$ 83,20/h | Anual desde Cotizar anualUS$ 58,50/h |
NVIDIAHGX B200180 GB HBM3e por GPU | Mensual desde Cotizar mensualUS$ 72,80/h | Anual desde Cotizar anualUS$ 50,70/h |
NVIDIAHGX H200141 GB HBM3e por GPU | Mensual desde Cotizar mensualUS$ 44,20/h | Anual desde Cotizar anualUS$ 31,20/h |
NVIDIAHGX H10080 GB HBM3 por GPU | Mensual desde Cotizar mensualUS$ 28,60/h | Anual desde Cotizar anualUS$ 19,50/h |
El precio por hora corresponde al nodo completo con 8 GPU. Elige el contrato para solicitar tu cotización.
- SLA
- 99,9% mensual + sustitución de nodo en 15 min + créditos de goodput
- Escala
- 128–10.000+ GPUs · fabric dedicado por tenant
- Facturación
- Medición por minuto dentro de la reserva · $0 ingress
Cada detalle cuenta
Tu infraestructura. Sin puntos ciegos.
Consulta qué está incluido y las tarifas de almacenamiento, transferencia de datos y red.
Hablar con un especialistaAlmacenamiento
- NVMe local (scratch) — 30 TB por nodoIncluido
- Sistema de archivos paralelo — WEKA gestionadodedicado por clúster$0.09/GB-mes
- Object storage — hot, compatible con S3caché NVMe, junto al cómputo$0.055/GB-mes
- Object storage — archivo$0.015/GB-mes
- Snapshots$0.021/GB-mes
Transferencia de datos
- Ingresssiempre$0
- Egress incluido20 TB/nodo-mes
- Exceso de egresstodos los sites$1.25/TB
- Inter-nodo / east-westfabric InfiniBand$0
Red
- Fabric InfiniBand east-westdedicado por clústerIncluido
- VLAN privada / VPCIncluido
- IPv4 público adicionalIPv6 gratis$4/IP-mes
- BYO-IP — /24 v4 o /48 v6alta $200Gratis
- Firewall gestionado$4/nodo-mes
- Protección DDoSIncluido
- Direct Connect 10G / 100G100G gratis en plazo anual$450 / $1.800-mes
Precios en USD por hora de nodo HGX de 8 GPUs; los sistemas rack-scale se cotizan por rack. Impuestos no incluidos. Gestión de Slurm y Kubernetes incluida. Almacenamiento y Direct Connect según las tarifas anteriores. Consulta las condiciones para contratos a largo plazo.
Recibir mi propuesta¿El precio es por GPU o por nodo?
Los precios publicados de HGX son en USD por hora de un nodo completo con 8 GPU, dentro de una reserva mensual o anual. Los sistemas NVL72 se cotizan por rack. Los impuestos no están incluidos.
¿Qué GPU NVIDIA debo elegir para mi proyecto de IA?
Compara la memoria de la GPU, los requisitos de red y la carga de entrenamiento o inferencia. La sección de hardware presenta H100, H200, B200, B300 y sistemas de rack completo. Nuestro equipo te ayuda a dimensionar la configuración según el modelo, los datos y la capacidad necesaria.
¿Puedo usar el clúster para entrenamiento, fine-tuning e inferencia?
Sí. TensorBay ofrece infraestructura dedicada de GPU NVIDIA para entrenamiento de modelos, fine-tuning e inferencia. Puedes trabajar con Slurm, Kubernetes o SSH y configurar el entorno de software para tu carga de trabajo.
¿Qué ocurre después de solicitar una cotización?
Indica la GPU, la capacidad y el plazo de reserva, o describe tu proyecto. El equipo revisa los requisitos y prepara una propuesta en un plazo de 48 horas, con configuración y fecha de entrega. La capacidad y las condiciones finales se confirman en la propuesta.
08Demos escala a tu idea
Mantén el trabajo de IA en marcha con una ruta de datos adecuada.
Cuéntanos sobre tus GPU, tus datos y tu patrón de entrenamiento o inferencia. Te ayudaremos a planificar la red y el almacenamiento para tu carga.
- Configuración alineada con tu proyecto
- Propuesta con plazo de entrega
- Pruebas de aceptación antes de empezar