TensorBay

CÓMPUTO GPU

GPUs NVIDIA para cada etapa de la IA.

Entrena, ajusta modelos y ejecuta inferencia en sistemas dedicados. Compara nodos de 8 GPUs y configuraciones a escala de rack, con red de alta velocidad y precios claros de reserva.

06De la investigación al resultado

Tu próximo descubrimiento. Tu próximo producto. Tu próxima escala.

  • Entrena lo que viene

    Da a tus modelos fundacionales la capacidad que necesitan. Clústeres reservados, red dedicada y nodos de reposición sostienen tus entrenamientos más ambiciosos.

    Explora B200, GB200 y GB300
  • Convierte conocimiento en ventaja

    Adapta modelos a los datos y retos de tu negocio. Nodos dedicados de 8 GPUs y almacenamiento persistente dan a tu equipo espacio para probar, ajustar y evolucionar.

    Encuentra tu H100 o H200
  • Pon tu IA a trabajar

    Lleva grandes modelos a producción con GPUs de alta capacidad de memoria. Atiende aplicaciones de contexto largo con una infraestructura dedicada y previsible.

    Descubre H200 y B300

01Encuentra tu potencia

El próximo avance de tu IA empieza con la GPU adecuada.

Entrenamiento, fine-tuning o inferencia: cada reto necesita su configuración. Encuentra la capacidad que se ajusta a tu equipo, tu modelo y tu presupuesto.

Ver todos los precios

Destacado de nueva generación

Early buy — entrega en marzo de 2027

Planifica tu próximo ciclo con la generación Rubin

Memoria por GPU
288 GB HBM4
Qué incluye el nodo
Rack NVL72 · refrigeración líquida
Conexión entre nodos
ConnectX-9 · 1.6T XDR
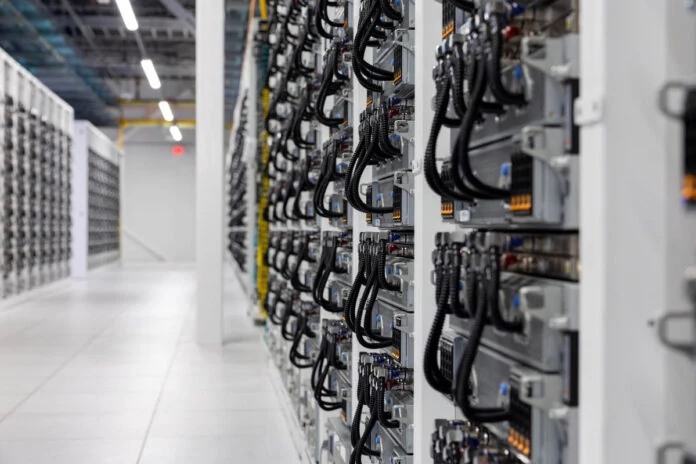
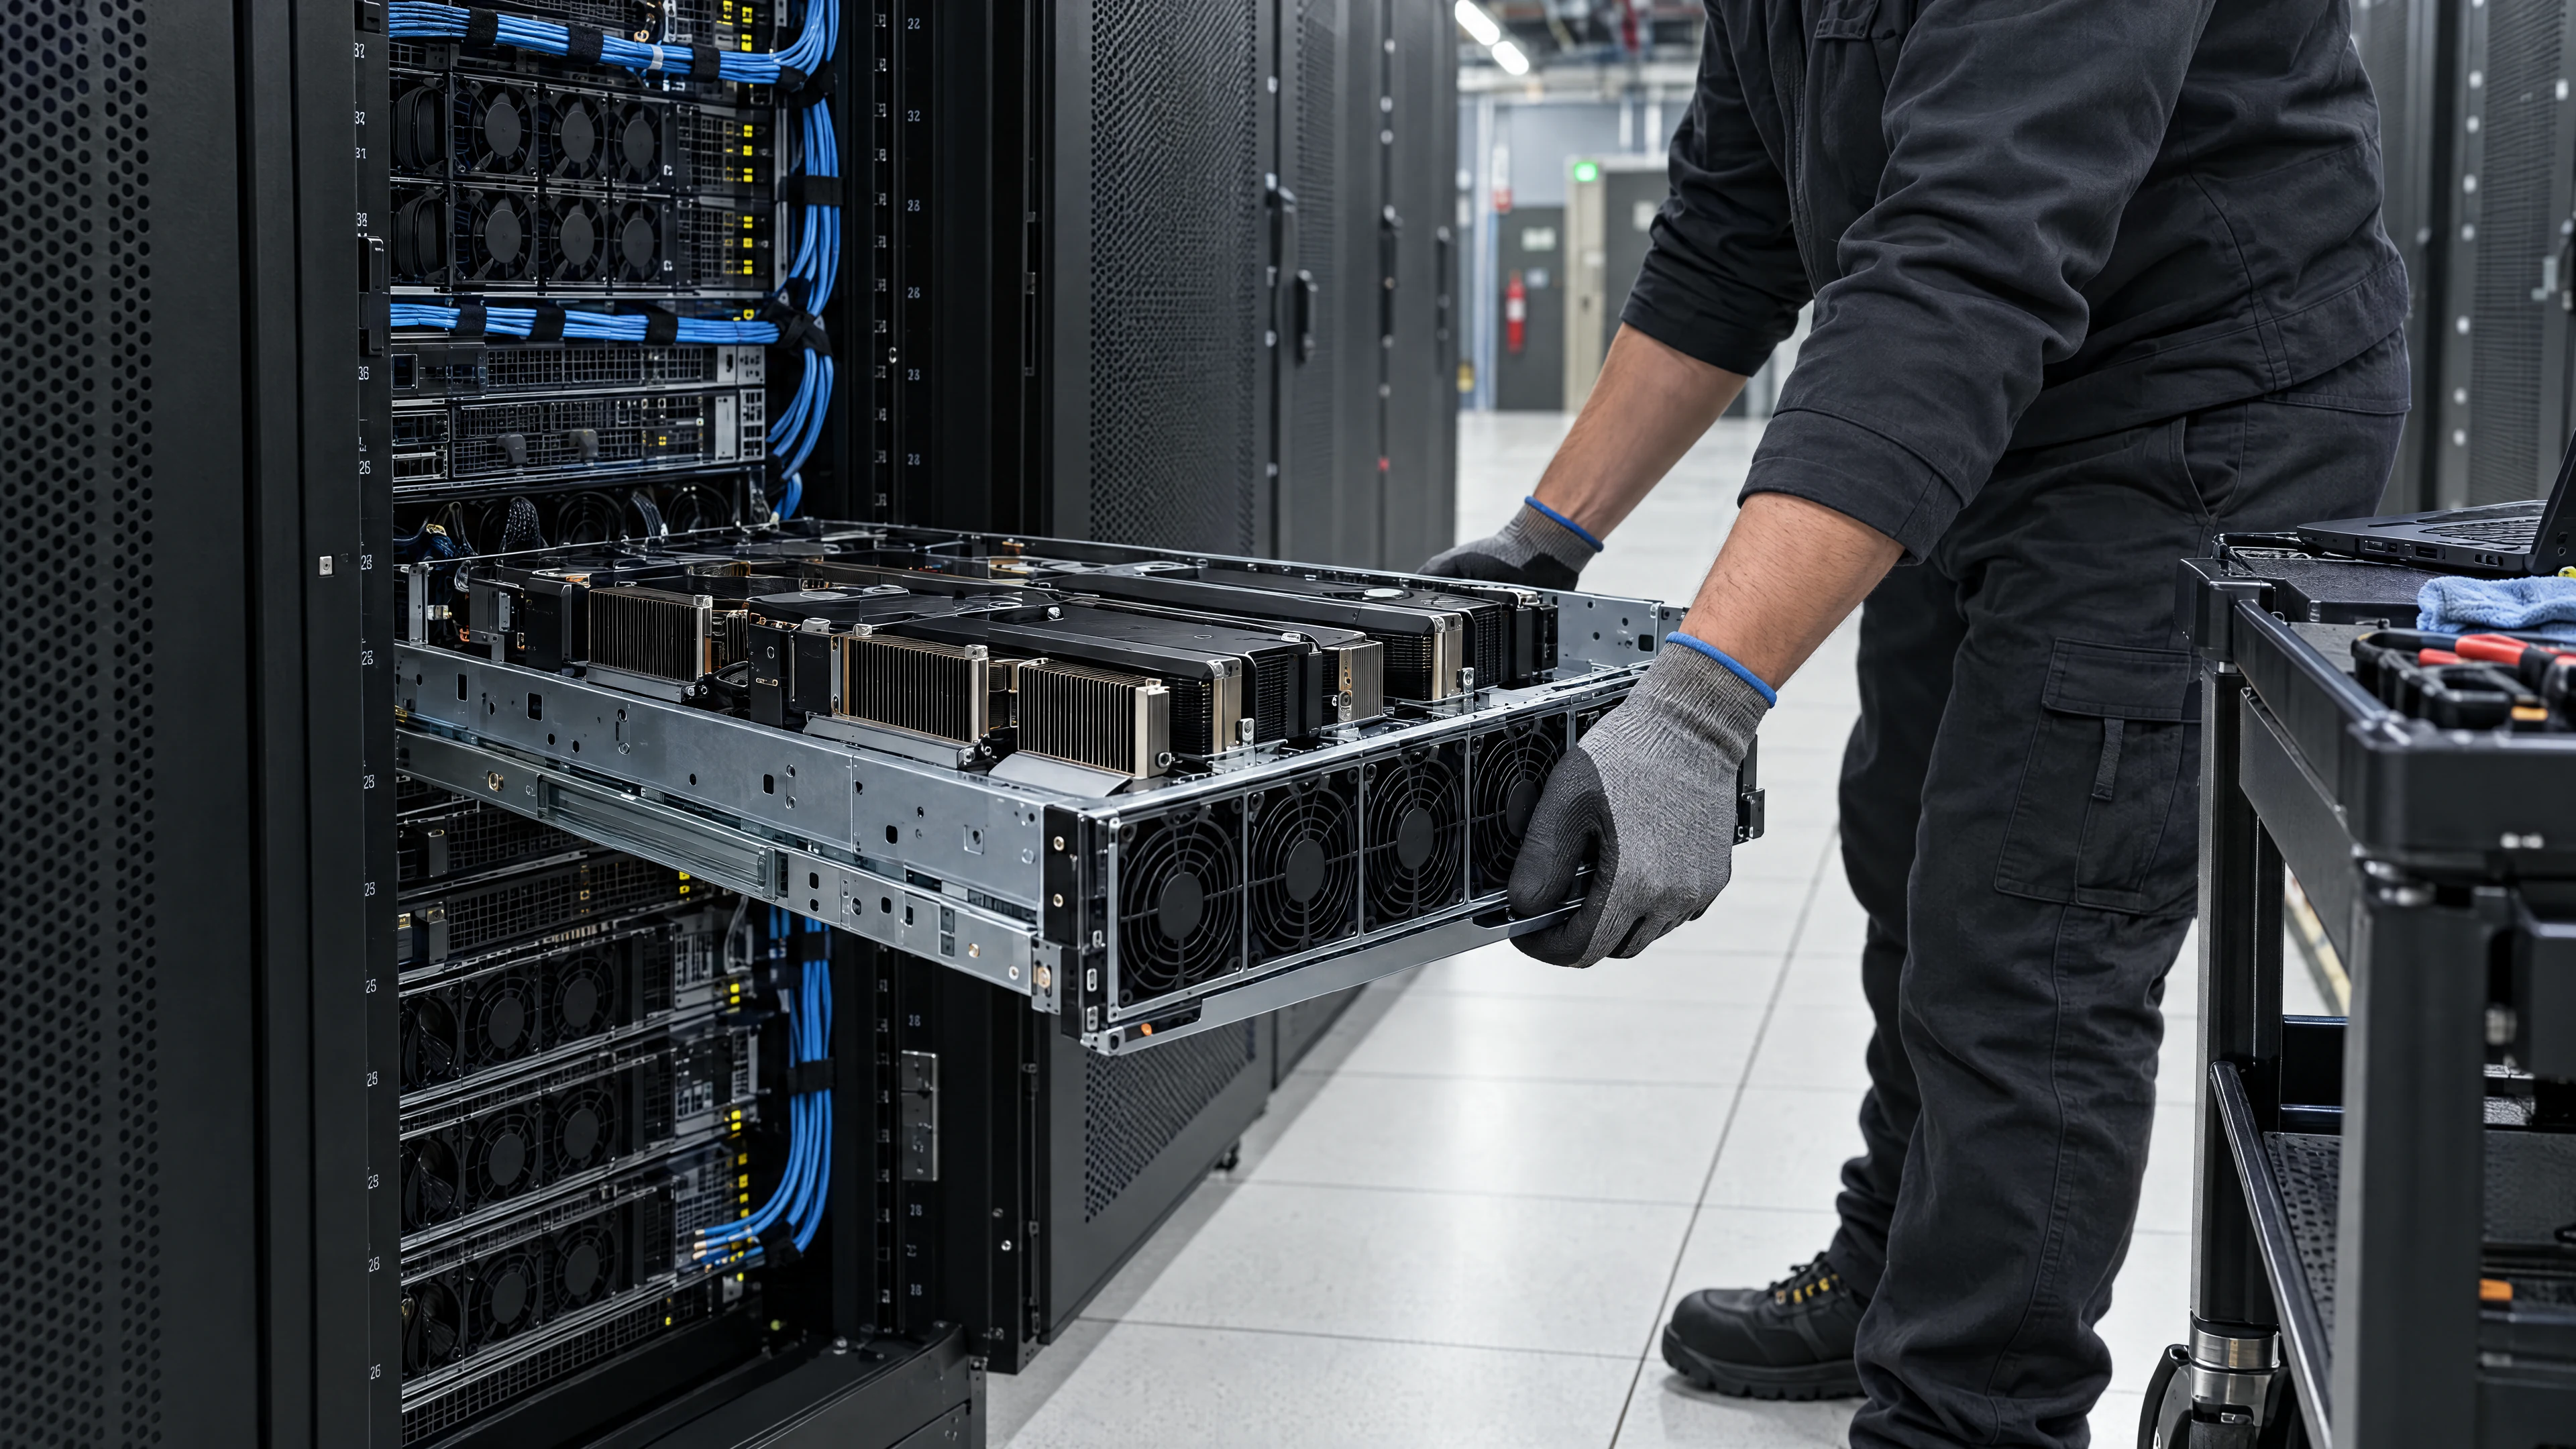
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
CÓMPUTO GPU · CAPACIDAD DEDICADA
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
NVIDIA NVL72

GB300 NVL72

Capacidad para modelos MoE e IA de razonamiento

288 GB HBM3e/GPUMemoria por GPU
Qué incluye el nodo
Rack completo o medio · refrigeración líquida
Conexión entre nodos
Quantum-X800 XDR entre racks
Explorar la configuración

Conexión entre GPUsDominio NVLink 5 coherente de 72 GPUs

Escala de rack

Ver detalles de GB300 NVL72

Anual · reservado

A consultar

Solicitar precio
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
NVIDIA HGX

B300

Más memoria para grandes modelos e inferencia

288 GB HBM3eMemoria por GPU
Qué incluye el nodo
8 GPU · 30 TB NVMe · 2 TB RAM
Conexión entre nodos
Quantum-X800 XDR 800G
Explorar la configuración

Conexión entre GPUsNVLink 5 · 1.8 TB/s por GPU

Blackwell Ultra

Ver detalles de HGX B300

Anual · reservado

desde$58,50/nodo-hr

Solicitar precio
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
NVIDIA NVL72

GB200 NVL72

Una base de 72 GPUs para modelos de gran tamaño

186 GB HBM3e/GPUMemoria por GPU
Qué incluye el nodo
Rack completo o medio · refrigeración líquida
Conexión entre nodos
Quantum-X800 XDR entre racks
Explorar la configuración

Conexión entre GPUsDominio NVLink 5 coherente de 72 GPUs

Escala de rack

Ver detalles de GB200 NVL72

Anual · reservado

A consultar

Solicitar precio
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
NVIDIA HGX

B200

Entrenamiento de modelos de frontera e inferencia FP4

180 GB HBM3eMemoria por GPU
Qué incluye el nodo
8 GPU · 30 TB NVMe · 2 TB RAM
Conexión entre nodos
Quantum-X800 XDR 800G
Explorar la configuración

Conexión entre GPUsNVLink 5 · 1.8 TB/s por GPU

Nuevo — en puesta en marcha

Ver detalles de HGX B200

Anual · reservado

desde$50,70/nodo-hr

Solicitar precio
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
NVIDIA HGX

H200

Más memoria para modelos de contexto largo

141 GB HBM3eMemoria por GPU
Qué incluye el nodo
8 GPU · 30 TB NVMe · 2 TB RAM
Conexión entre nodos
8×400G IB NDR · 3.2 Tbps
Explorar la configuración

Conexión entre GPUsNVLink 4 · 900 GB/s

Ver detalles de HGX H200

Anual · reservado

desde$31,20/nodo-hr

Solicitar precio
Racks de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo
NVIDIA HGX

H100

Entrenamiento y fine-tuning con foco en tu presupuesto

80 GB HBM3Memoria por GPU
Qué incluye el nodo
8 GPU · 15 TB NVMe · 2 TB RAM
Conexión entre nodos
8×400G IB NDR · 3.2 Tbps
Explorar la configuración

Conexión entre GPUsNVLink 4 · 900 GB/s

Caballo de batalla

Ver detalles de HGX H100

Anual · reservado

desde$19,50/nodo-hr

Solicitar precio

Precios en USD por hora de nodo de 8 GPUs. Los sistemas rack-scale se cotizan por separado. Sujetos a capacidad y condiciones del contrato.

0%
Overhead de hipervisor
3.2 Tbps
InfiniBand por nodo
97,4%
Goodput del clúster, 90 días

PROBADO ANTES DE LA ENTREGA

Empieza con un clúster en el que tu equipo pueda confiar.

Cada clúster pasa por 72 horas de pruebas de carga, memoria, red y temperatura. Tu equipo revisa los resultados antes de aprobar la entrega.

72h
PRUEBAS DE ACEPTACIÓN

Pruebas de carga · memoria · red · temperatura

Habla con nuestro equipo

03Infraestructura para tu ambición

Detrás de cada avance, una base a su altura.

Energía, refrigeración, GPUs y red. Diseñamos y operamos cada capa en conjunto para que tu IA tenga una base preparada para crecer.

TensorBay AIFactoryInfraestructura de GPU diseñada como un sistema integrado
  1. 01Refrigeración

    PUE 1,12

    Refrigeración líquida directa al chip en racks de 130 kW. Eficiencia diseñada para cargas intensivas de IA.

  2. 02Capacidad GPU

    24.000+ GPUs

    La capacidad se amplía en ciclos de seis semanas, con verificaciones de preparación antes de cada entrega.

  3. 03Trabajo útil

    97,4%

    Goodput del clúster en los últimos 90 días: la parte de la capacidad convertida en trabajo útil.

04Red y almacenamiento

Tus GPU. Una sola fuerza.

Conecta GPU, datos y almacenamiento en una infraestructura dedicada a tu modelo, desde el primer lote de entrenamiento hasta el último checkpoint.

Planificar mi clúster

Red dedicada

Una red a la altura de tus GPU.

InfiniBand dedicada conecta tu clúster con ancho de banda para distribuir el entrenamiento y mover datos entre GPU.

800Gb/s

por enlace InfiniBand XDR, Quantum-X800 para Blackwell

Especificaciones de red
Fabric de entrenamiento — Hopper
8×400 Gb/s InfiniBand NDR por nodo (3.2 Tbps), fat-tree non-blocking rail-optimized, reducción en red con SHARP
Fabric de entrenamiento — Blackwell
InfiniBand XDR Quantum-X800, 800G por enlace; los racks GB200 añaden un dominio NVLink 5 coherente de 72 GPUs a 1.8 TB/s por GPU
Sobresuscripción
1:1 en todos los niveles. Sin fabric este-oeste compartido, sin spine mezclado con otros tenants
Red front-end
Doble 100 GbE por nodo, con protección DDoS y soporte BYO-IP

Almacenamiento

Dale ritmo a tus datos.

NVMe local, WEKA y almacenamiento compatible con S3 para cargar datasets y guardar checkpoints a la escala de tu proyecto.

Hasta

720GB/s

de lectura agregada por pod, con WEKA dedicado

Especificaciones de almacenamiento
Scratch local
30 TB NVMe Gen5 por nodo, ~55 GB/s de lectura — staging de checkpoints sin tocar la red
Sistema de ficheros paralelo
WEKA gestionado, dedicado por clúster: hasta 720 GB/s de lectura agregada por pod, POSIX + GPUDirect Storage
Almacenamiento de objetos
Compatible S3, con caché NVMe, colocado junto al cómputo — $0.055/GB-mes en el nivel hot

Transferencia de datos

Lleva tus datos más lejos.

Entrada de datos y tráfico entre nodos sin cargos, con una cuota de salida incluida para planificar tu operación.

20TB

de salida incluidos por nodo, por mes

Condiciones de transferencia
Transferencia de datos
Ingress $0 · 20 TB/nodo-mes de egress incluido, después $1.25/TB · inter-nodo $0. Direct Connect 100G gratis en reservas anuales

La red y el almacenamiento se configuran según la arquitectura de tu clúster.Consultar tarifas y condiciones

EXPLORA TENSORBAY

Encuentra la base adecuada para tu próximo paso.

Conoce las GPU, la infraestructura y los precios para impulsar tu proyecto de IA.

Racks oscuros de servidores GPU en un pasillo de centro de datos, con bandejas de cables en el techo

RESERVAS ANTICIPADAS

NVIDIA VR200 NVL72

Consulta la configuración Vera Rubin a escala de rack y el calendario de reserva anticipada.

NVIDIA VR200 NVL72
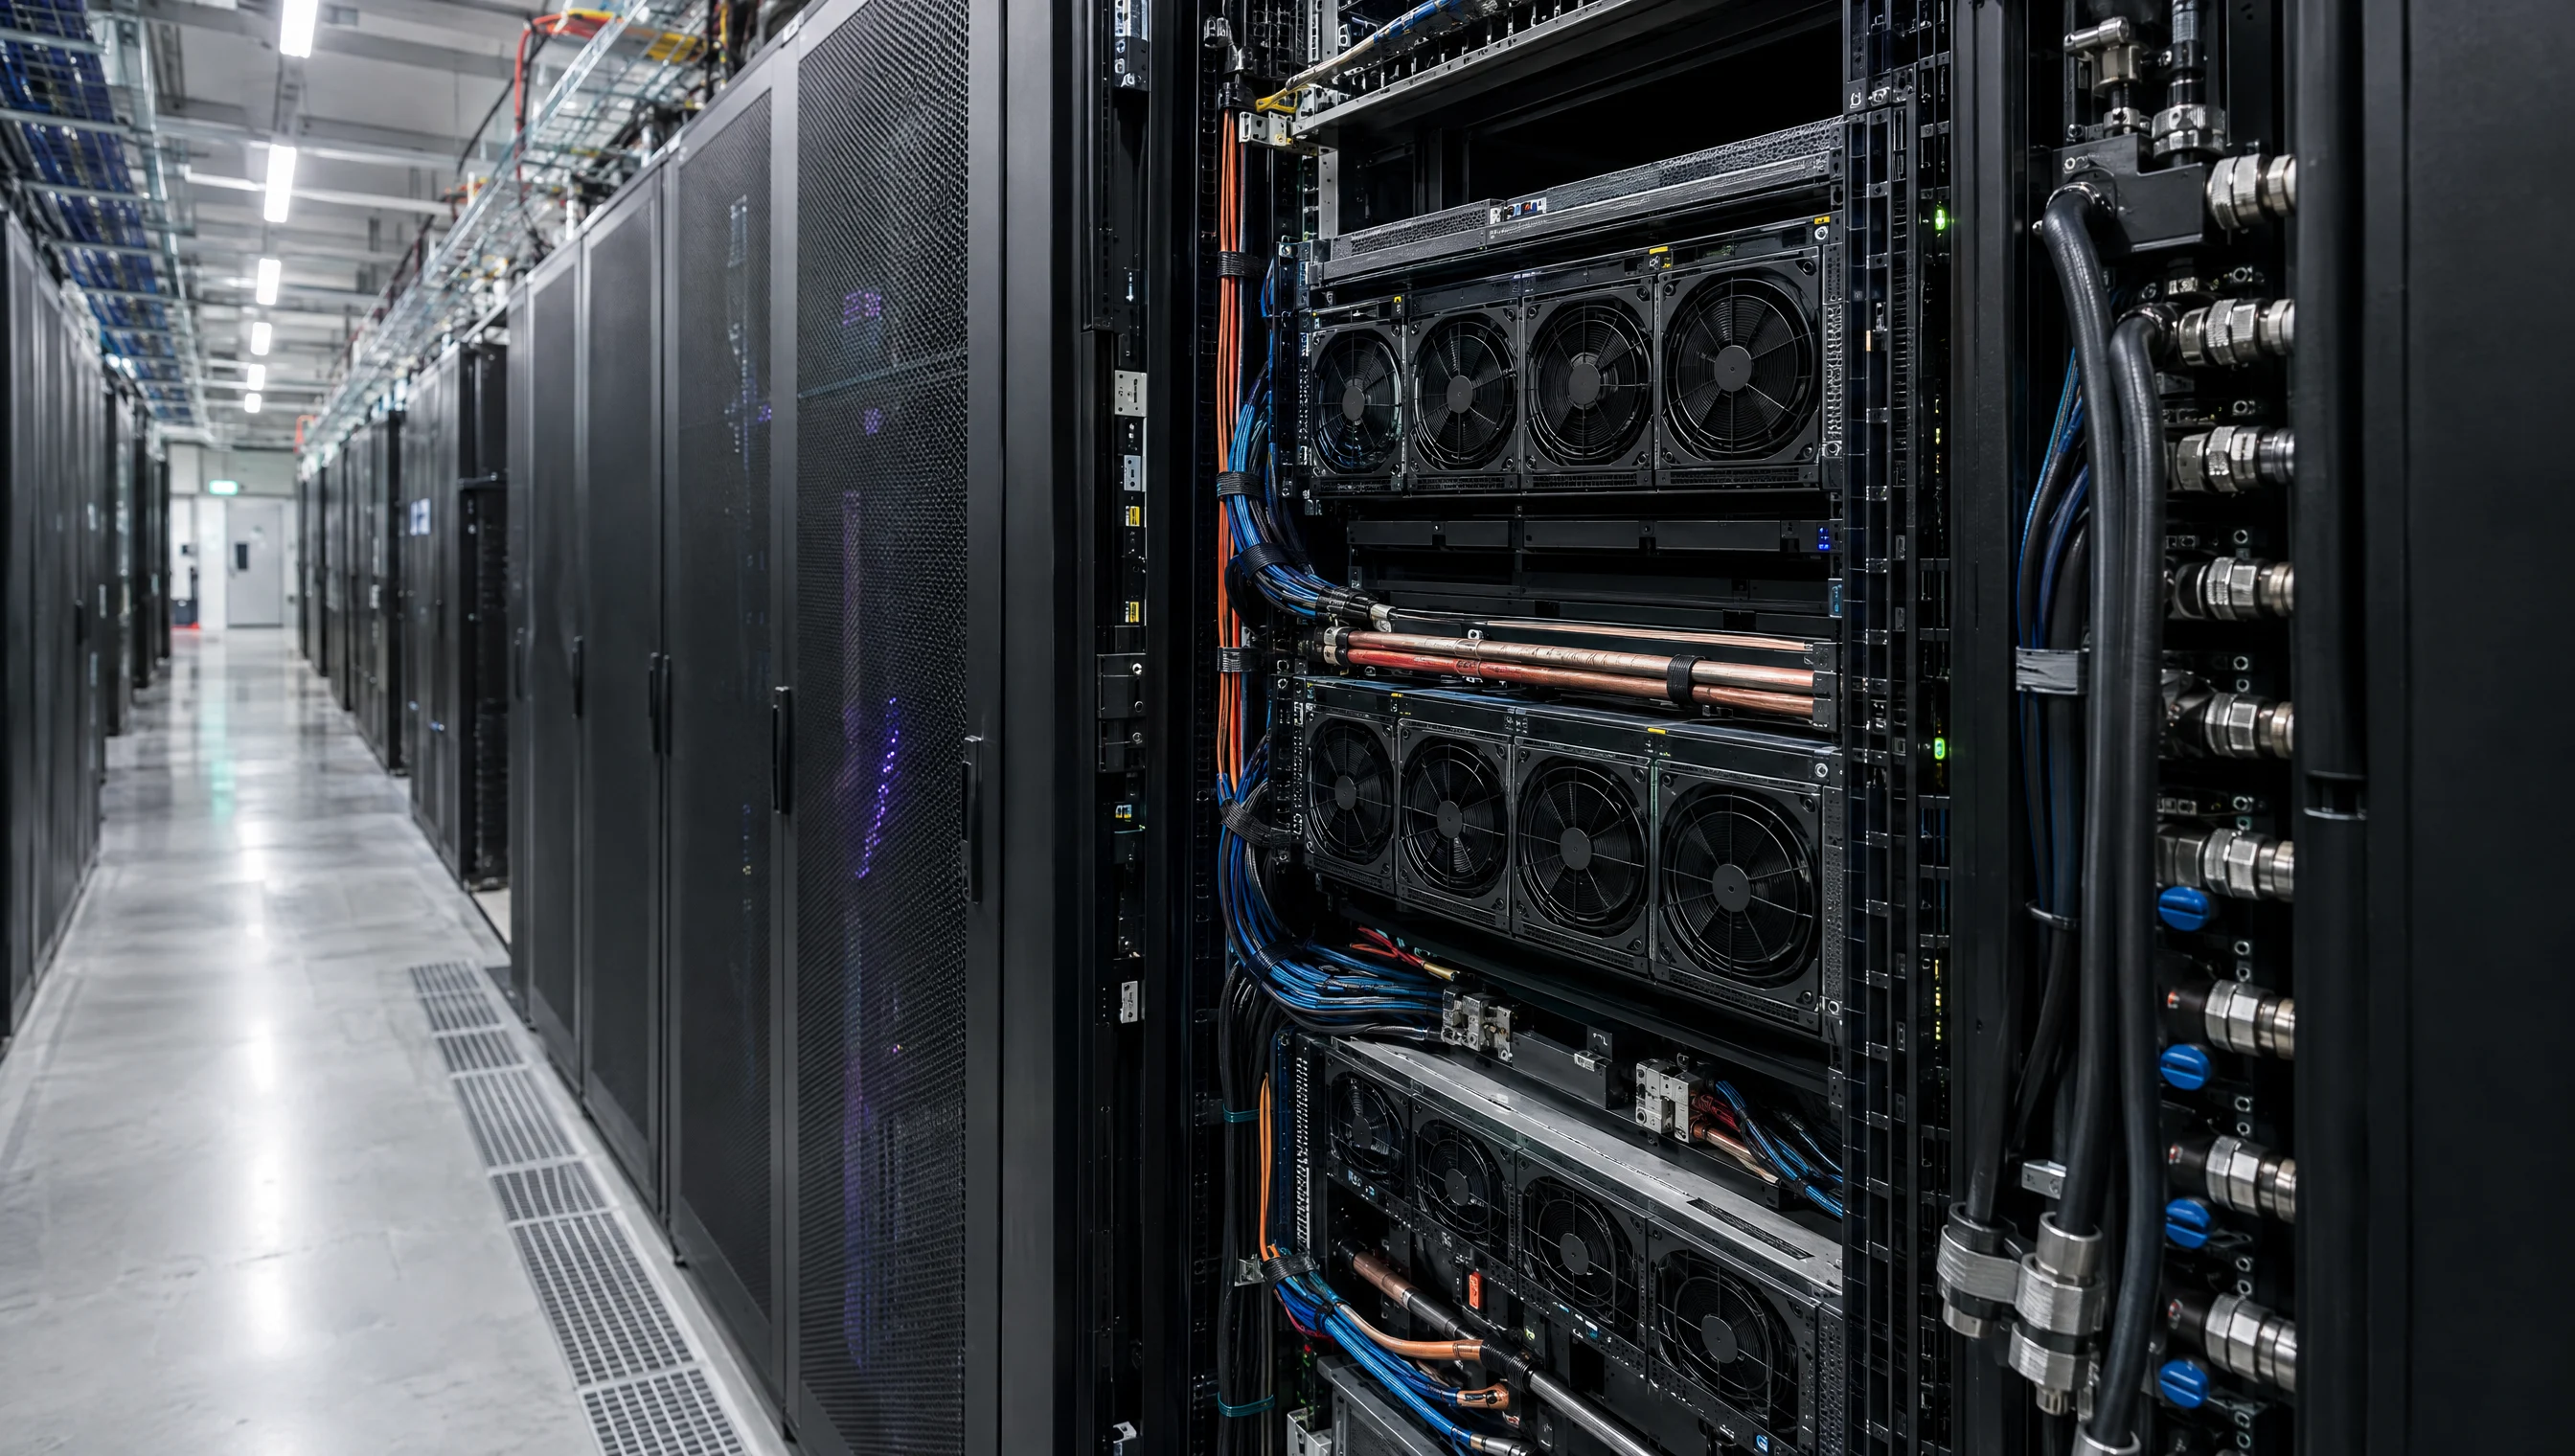
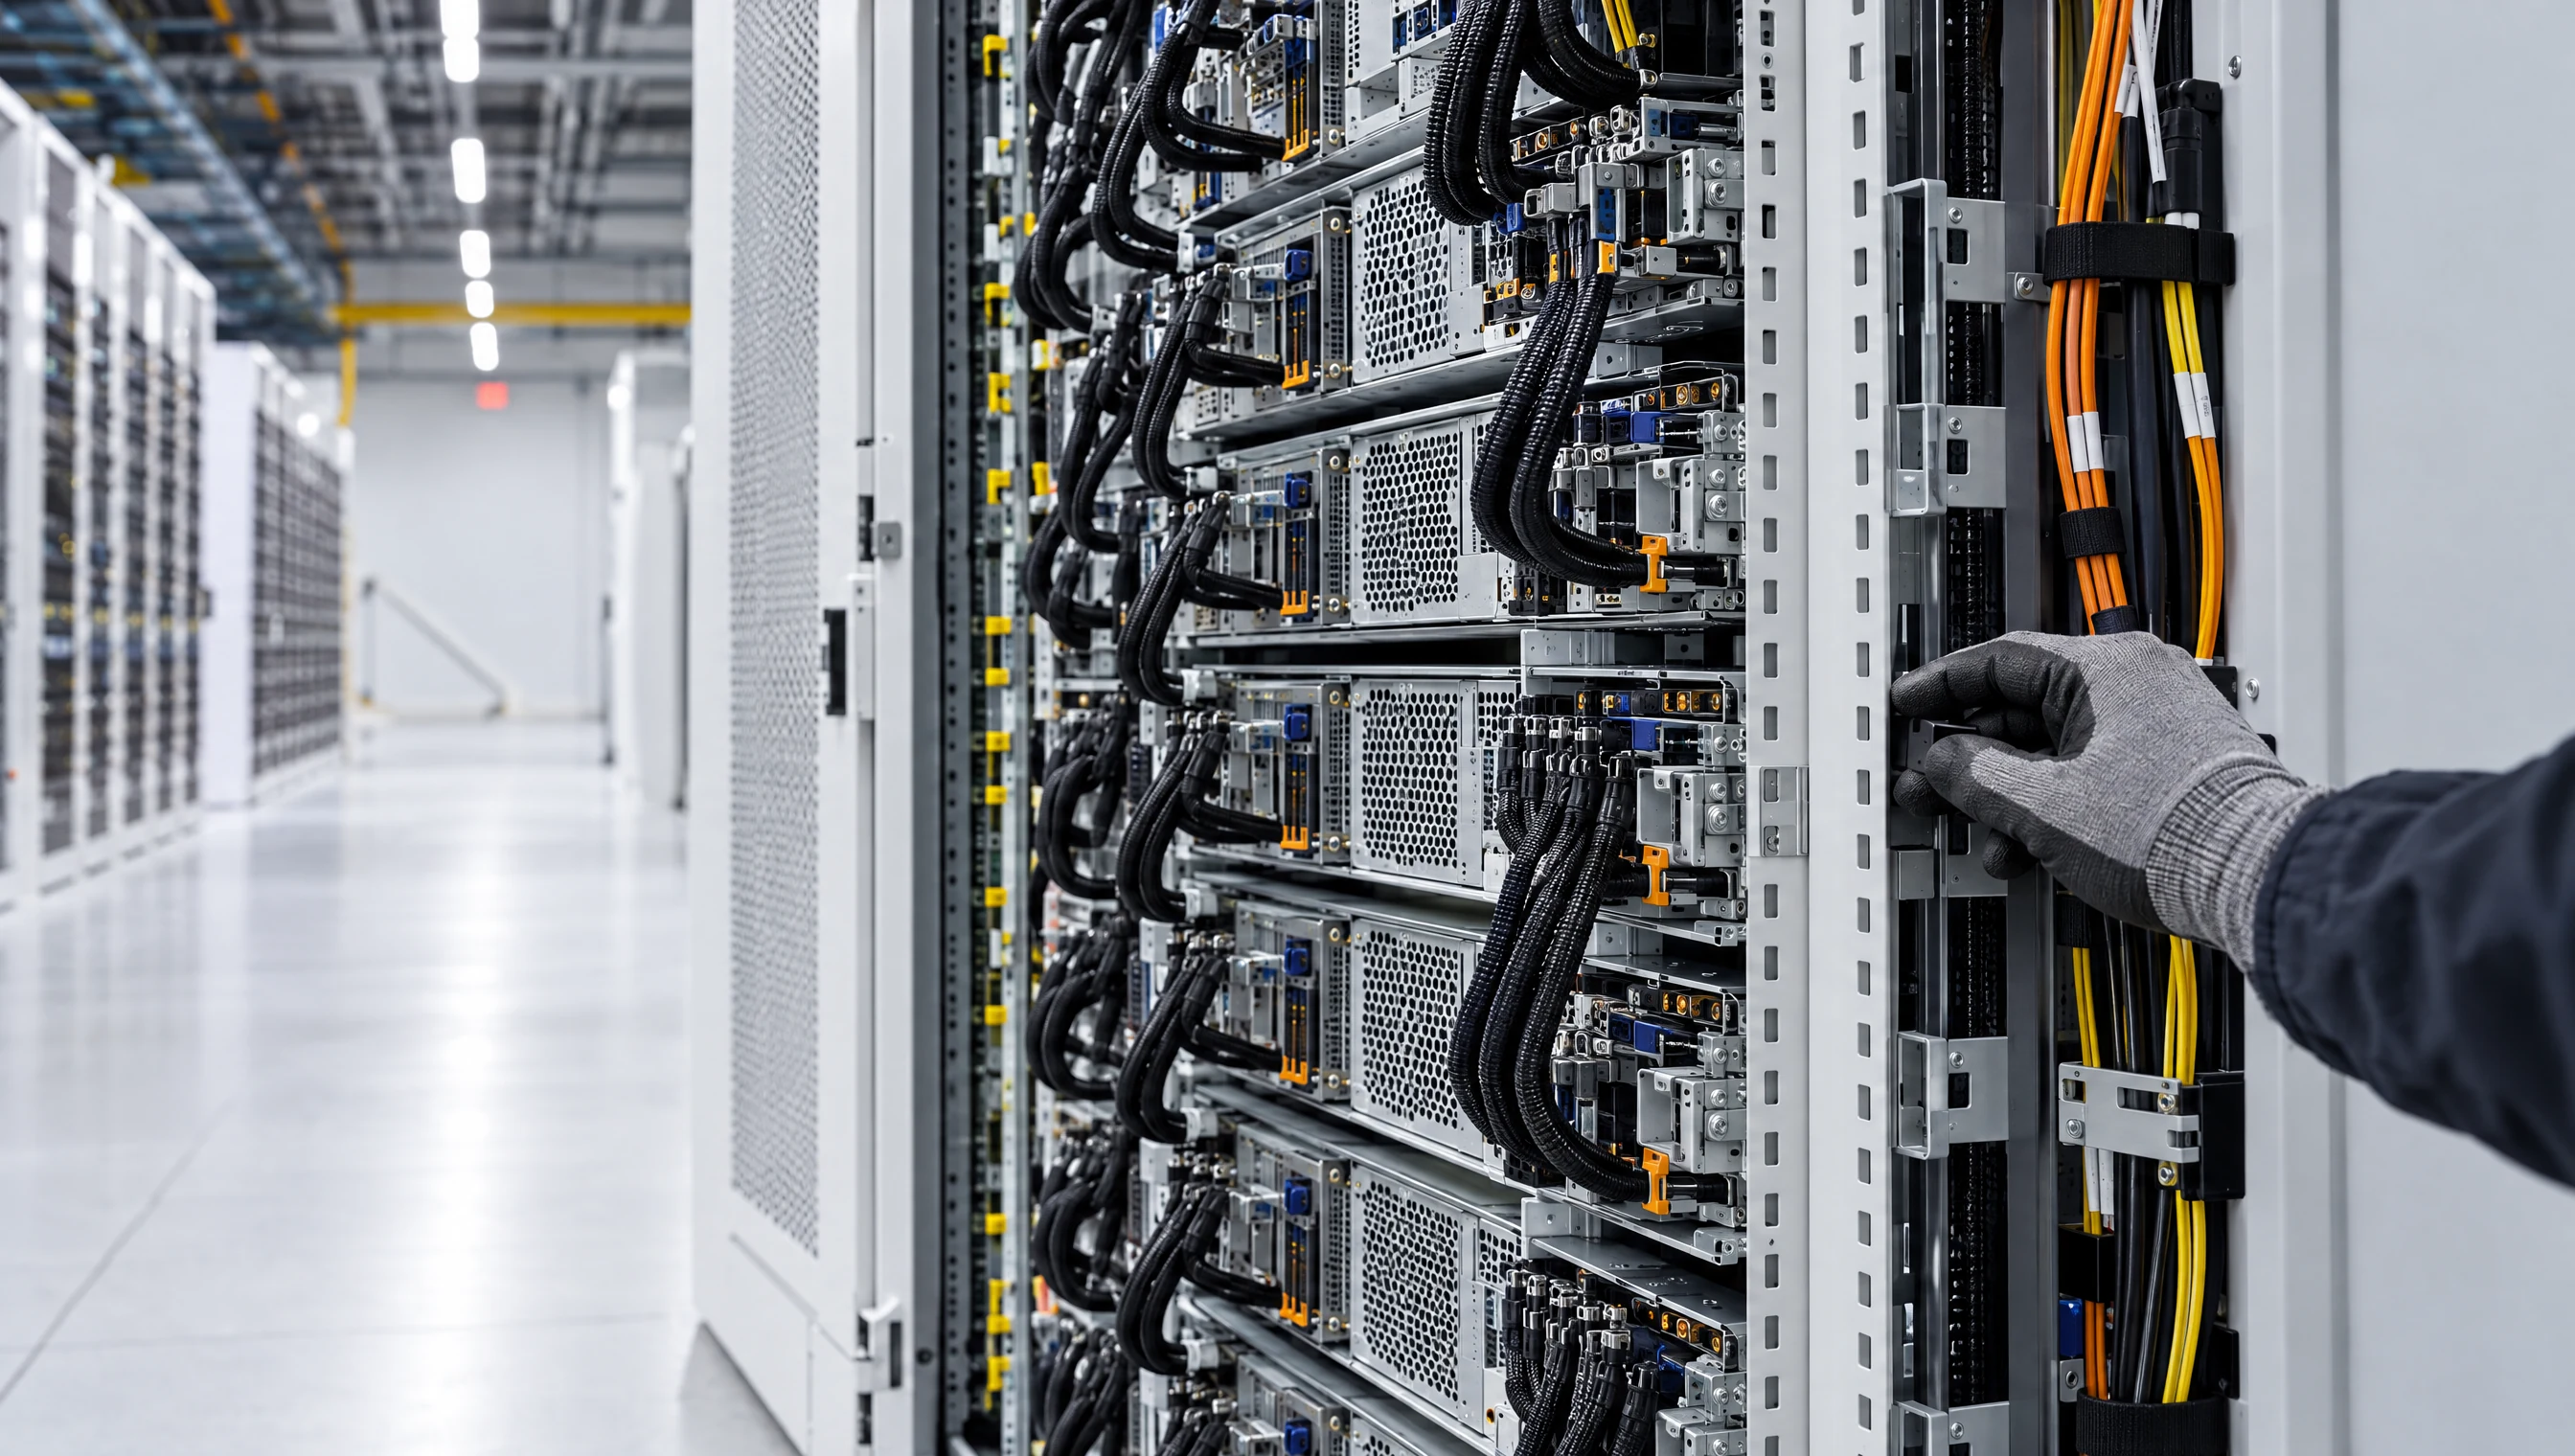
Detalle de un rack de servidores GPU con refrigeración y cables de datos en un centro de datos

CÓMPUTO GPU

Encuentra la GPU NVIDIA adecuada

Compara las configuraciones TensorBay, de la generación más reciente a las anteriores.

Encuentra la GPU NVIDIA adecuada

05Invierte en tu próximo paso

Potencia para crecer. Claridad para invertir.

Elige el plazo de reserva, compara la capacidad y planifica tu inversión. Aquí, la conversación empieza con los precios a la vista.

USD por hora, nodo completo con 8 GPU

Nodos GPU, USD por hora, nodo completo con 8 GPU
GPU y memoriaPlazo mensualReserva con contrato mensualPlazo anualMenor precio por hora
NVIDIAHGX B300288 GB HBM3e por GPU
Mensual
desde
US$ 83,20/h
Cotizar mensual
Anual
desde
US$ 58,50/h
Cotizar anual
NVIDIAHGX B200180 GB HBM3e por GPU
Mensual
desde
US$ 72,80/h
Cotizar mensual
Anual
desde
US$ 50,70/h
Cotizar anual
NVIDIAHGX H200141 GB HBM3e por GPU
Mensual
desde
US$ 44,20/h
Cotizar mensual
Anual
desde
US$ 31,20/h
Cotizar anual
NVIDIAHGX H10080 GB HBM3 por GPU
Mensual
desde
US$ 28,60/h
Cotizar mensual
Anual
desde
US$ 19,50/h
Cotizar anual

El precio por hora corresponde al nodo completo con 8 GPU. Elige el contrato para solicitar tu cotización.

SLA
99,9% mensual + sustitución de nodo en 15 min + créditos de goodput
Escala
128–10.000+ GPUs · fabric dedicado por tenant
Facturación
Medición por minuto dentro de la reserva · $0 ingress

Cada detalle cuenta

Tu infraestructura. Sin puntos ciegos.

Consulta qué está incluido y las tarifas de almacenamiento, transferencia de datos y red.

Hablar con un especialista
Almacenamiento
  • NVMe local (scratch) — 30 TB por nodoIncluido
  • Sistema de archivos paralelo — WEKA gestionadodedicado por clúster$0.09/GB-mes
  • Object storage — hot, compatible con S3caché NVMe, junto al cómputo$0.055/GB-mes
  • Object storage — archivo$0.015/GB-mes
  • Snapshots$0.021/GB-mes
Transferencia de datos
  • Ingresssiempre$0
  • Egress incluido20 TB/nodo-mes
  • Exceso de egresstodos los sites$1.25/TB
  • Inter-nodo / east-westfabric InfiniBand$0
Red
  • Fabric InfiniBand east-westdedicado por clústerIncluido
  • VLAN privada / VPCIncluido
  • IPv4 público adicionalIPv6 gratis$4/IP-mes
  • BYO-IP — /24 v4 o /48 v6alta $200Gratis
  • Firewall gestionado$4/nodo-mes
  • Protección DDoSIncluido
  • Direct Connect 10G / 100G100G gratis en plazo anual$450 / $1.800-mes

Precios en USD por hora de nodo HGX de 8 GPUs; los sistemas rack-scale se cotizan por rack. Impuestos no incluidos. Gestión de Slurm y Kubernetes incluida. Almacenamiento y Direct Connect según las tarifas anteriores. Consulta las condiciones para contratos a largo plazo.

Recibir mi propuesta

Preguntas frecuentes

Claridad para elegir tu próximo clúster.

Hablar con un especialista
¿El precio es por GPU o por nodo?

Los precios publicados de HGX son en USD por hora de un nodo completo con 8 GPU, dentro de una reserva mensual o anual. Los sistemas NVL72 se cotizan por rack. Los impuestos no están incluidos.

¿Qué GPU NVIDIA debo elegir para mi proyecto de IA?

Compara la memoria de la GPU, los requisitos de red y la carga de entrenamiento o inferencia. La sección de hardware presenta H100, H200, B200, B300 y sistemas de rack completo. Nuestro equipo te ayuda a dimensionar la configuración según el modelo, los datos y la capacidad necesaria.

¿Puedo usar el clúster para entrenamiento, fine-tuning e inferencia?

Sí. TensorBay ofrece infraestructura dedicada de GPU NVIDIA para entrenamiento de modelos, fine-tuning e inferencia. Puedes trabajar con Slurm, Kubernetes o SSH y configurar el entorno de software para tu carga de trabajo.

¿Qué ocurre después de solicitar una cotización?

Indica la GPU, la capacidad y el plazo de reserva, o describe tu proyecto. El equipo revisa los requisitos y prepara una propuesta en un plazo de 48 horas, con configuración y fecha de entrega. La capacidad y las condiciones finales se confirman en la propuesta.

08Demos escala a tu idea

El próximo salto de tu IA empieza con una conversación.

Cuéntanos tu reto. Nuestro equipo te ayuda a definir las GPUs, la capacidad y los plazos. Recibe una propuesta en 48 horas para lanzar tu proyecto o llevarlo más lejos.

  • Configuración alineada con tu proyecto
  • Propuesta con plazo de entrega
  • Pruebas de aceptación antes de empezar
tensorbay@tensorbay.io