Destaque da próxima geração
Reserva antecipada, entrega em março de 2027
VR200 NVL72
Planeje seu próximo ciclo com a geração Rubin
- Memória por GPU
- 288 GB HBM4
- O que vem no nó
- Rack NVL72 · refrigeração líquida
- Conexão entre nós
- ConnectX-9 · 1,6T XDR
COMPUTAÇÃO GPU
Treine, ajuste modelos e execute inferência em sistemas dedicados. Compare nós de 8 GPUs e configurações em escala de rack, com rede de alta velocidade e preços claros para reserva.
06Da pesquisa ao resultado
Dê aos seus modelos fundacionais a capacidade que eles exigem. Clusters reservados, rede dedicada e nós de reposição sustentam a infraestrutura dos seus treinamentos mais ambiciosos.
Explore B200, GB200 e GB300Adapte modelos aos dados e desafios do seu negócio. Nós dedicados de 8 GPUs e armazenamento persistente dão à equipe espaço para testar, ajustar e evoluir.
Encontre seu H100 ou H200Leve modelos de grande porte à produção com GPUs de alta capacidade de memória. Atenda aplicações de contexto longo com a previsibilidade de uma infraestrutura dedicada.
Conheça H200 e B30001Encontre sua potência
Treinamento, fine-tuning ou inferência: cada desafio pede uma configuração. Compare as opções e encontre a capacidade que faz sentido para sua equipe, seu modelo e seu orçamento.
Ver tabela de preçosDestaque da próxima geração
Reserva antecipada, entrega em março de 2027
Planeje seu próximo ciclo com a geração Rubin
Capacidade para modelos MoE e IA de raciocínio
Conexão entre GPUsDomínio NVLink 5 coerente de 72 GPUs
Escala de rack
Mais memória para modelos e inferência em grande escala
Conexão entre GPUsNVLink 5 · 1,8 TB/s por GPU
Blackwell Ultra
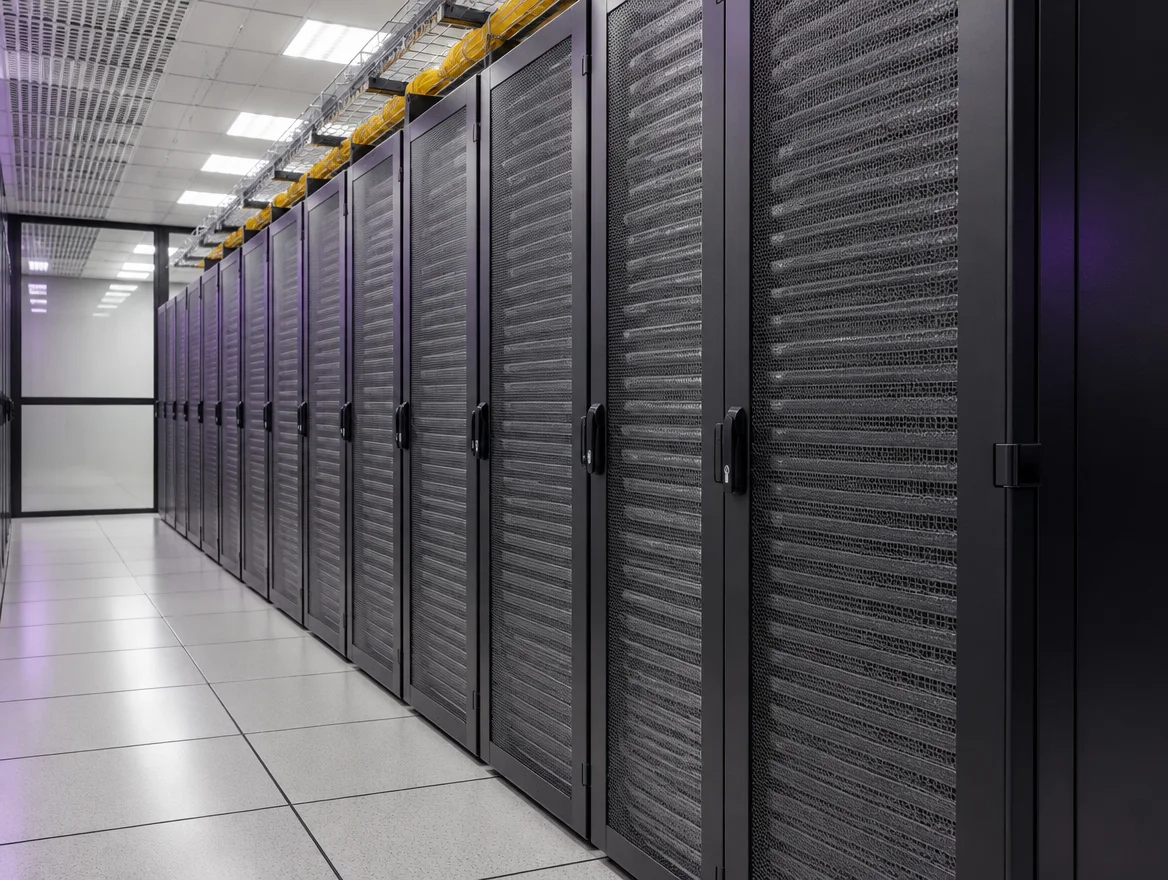
Uma base de 72 GPUs para modelos de grande porte
Conexão entre GPUsDomínio NVLink 5 coerente de 72 GPUs
Escala de rack
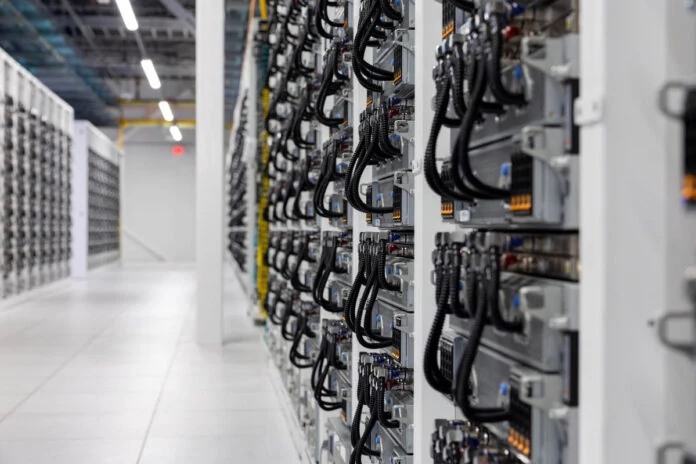
Treine modelos de fronteira e execute inferência FP4
Conexão entre GPUsNVLink 5 · 1,8 TB/s por GPU
Nova geração, em preparação
Sirva modelos de contexto longo com mais memória
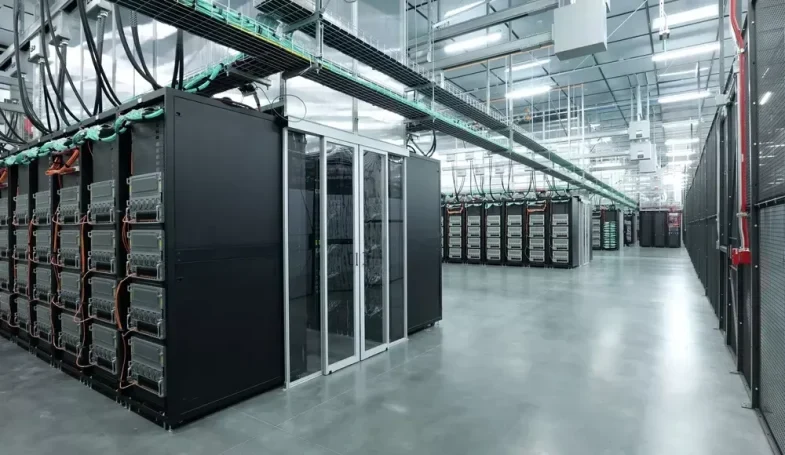
Treinamento e fine-tuning com foco no orçamento
Conexão entre GPUsNVLink 4 · 900 GB/s
Versatilidade para sua equipe
Preços em USD por hora de nó com 8 GPUs. Sistemas rack-scale têm cotação própria. Sujeitos à capacidade e às condições do contrato.
TESTADO ANTES DA ENTREGA
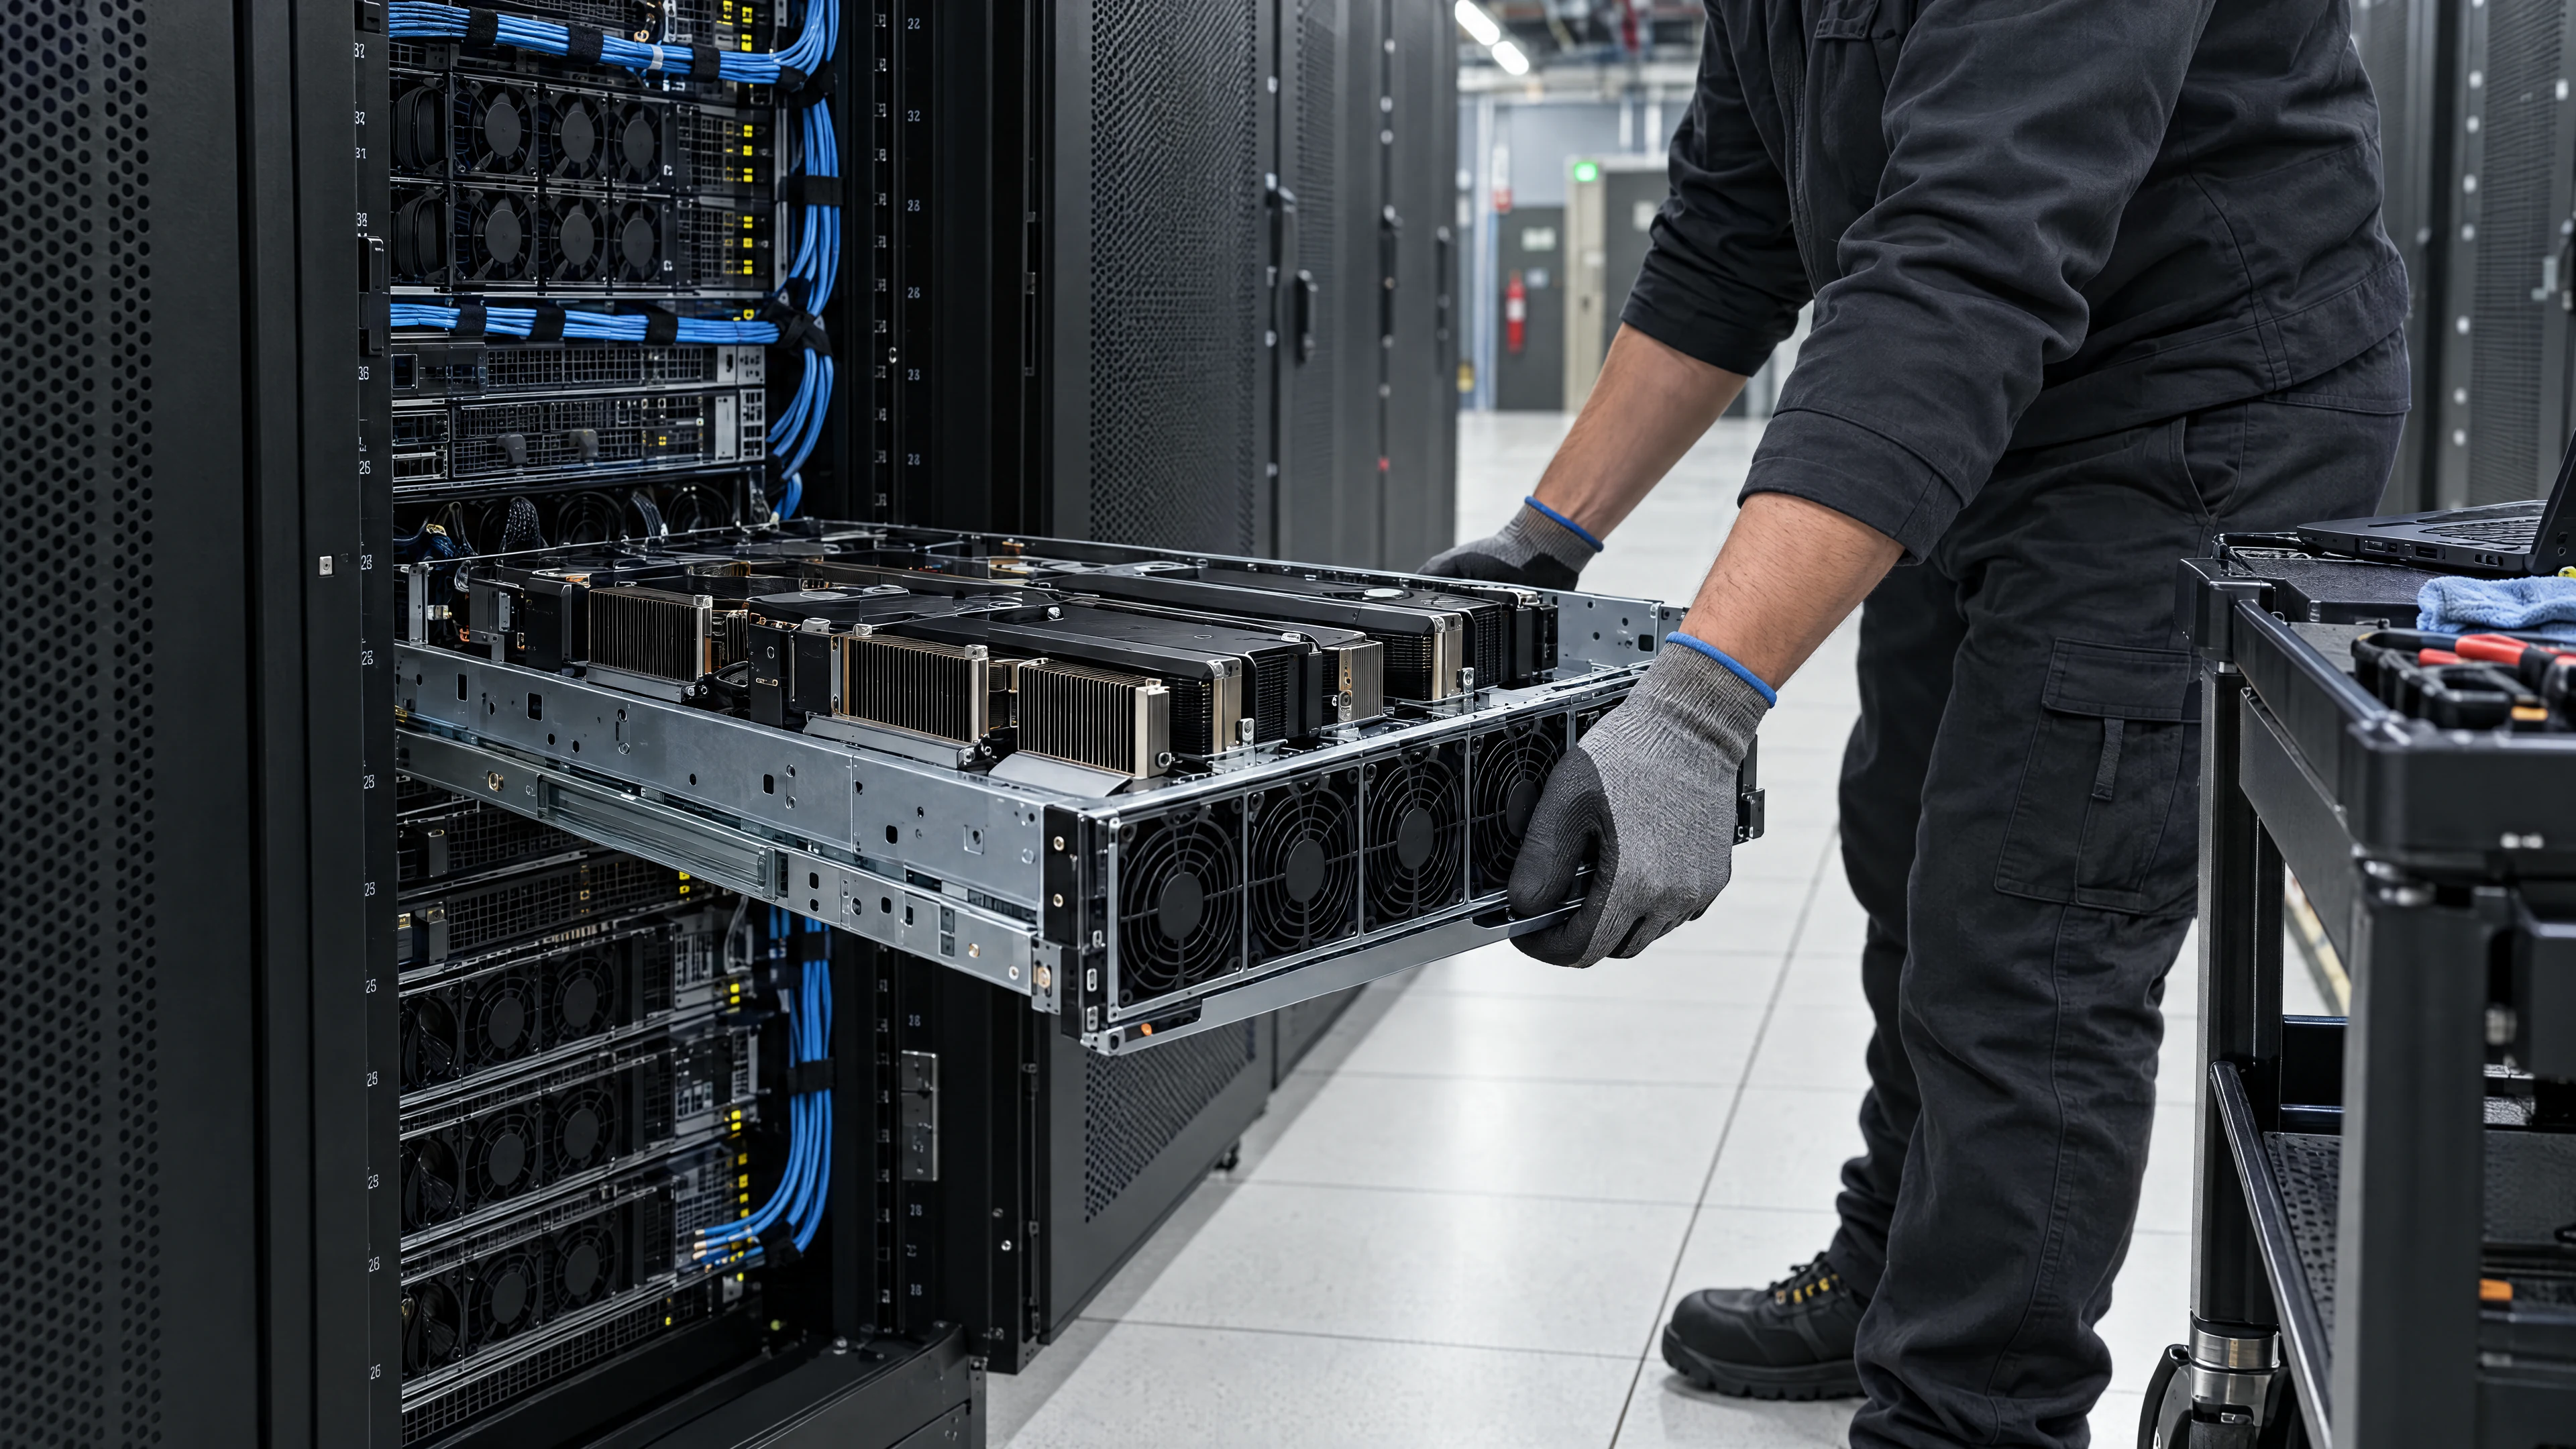
Cada cluster passa por 72 horas de testes de carga, memória, rede e temperatura. Sua equipe analisa os resultados antes de aprovar a entrega.
Testes de carga · memória · rede · temperatura
03Infraestrutura que sustenta sua ambição
Energia, refrigeração, GPUs e rede. Projetamos e operamos cada camada em conjunto para que sua IA tenha uma estrutura pronta para crescer.
PUE 1,12
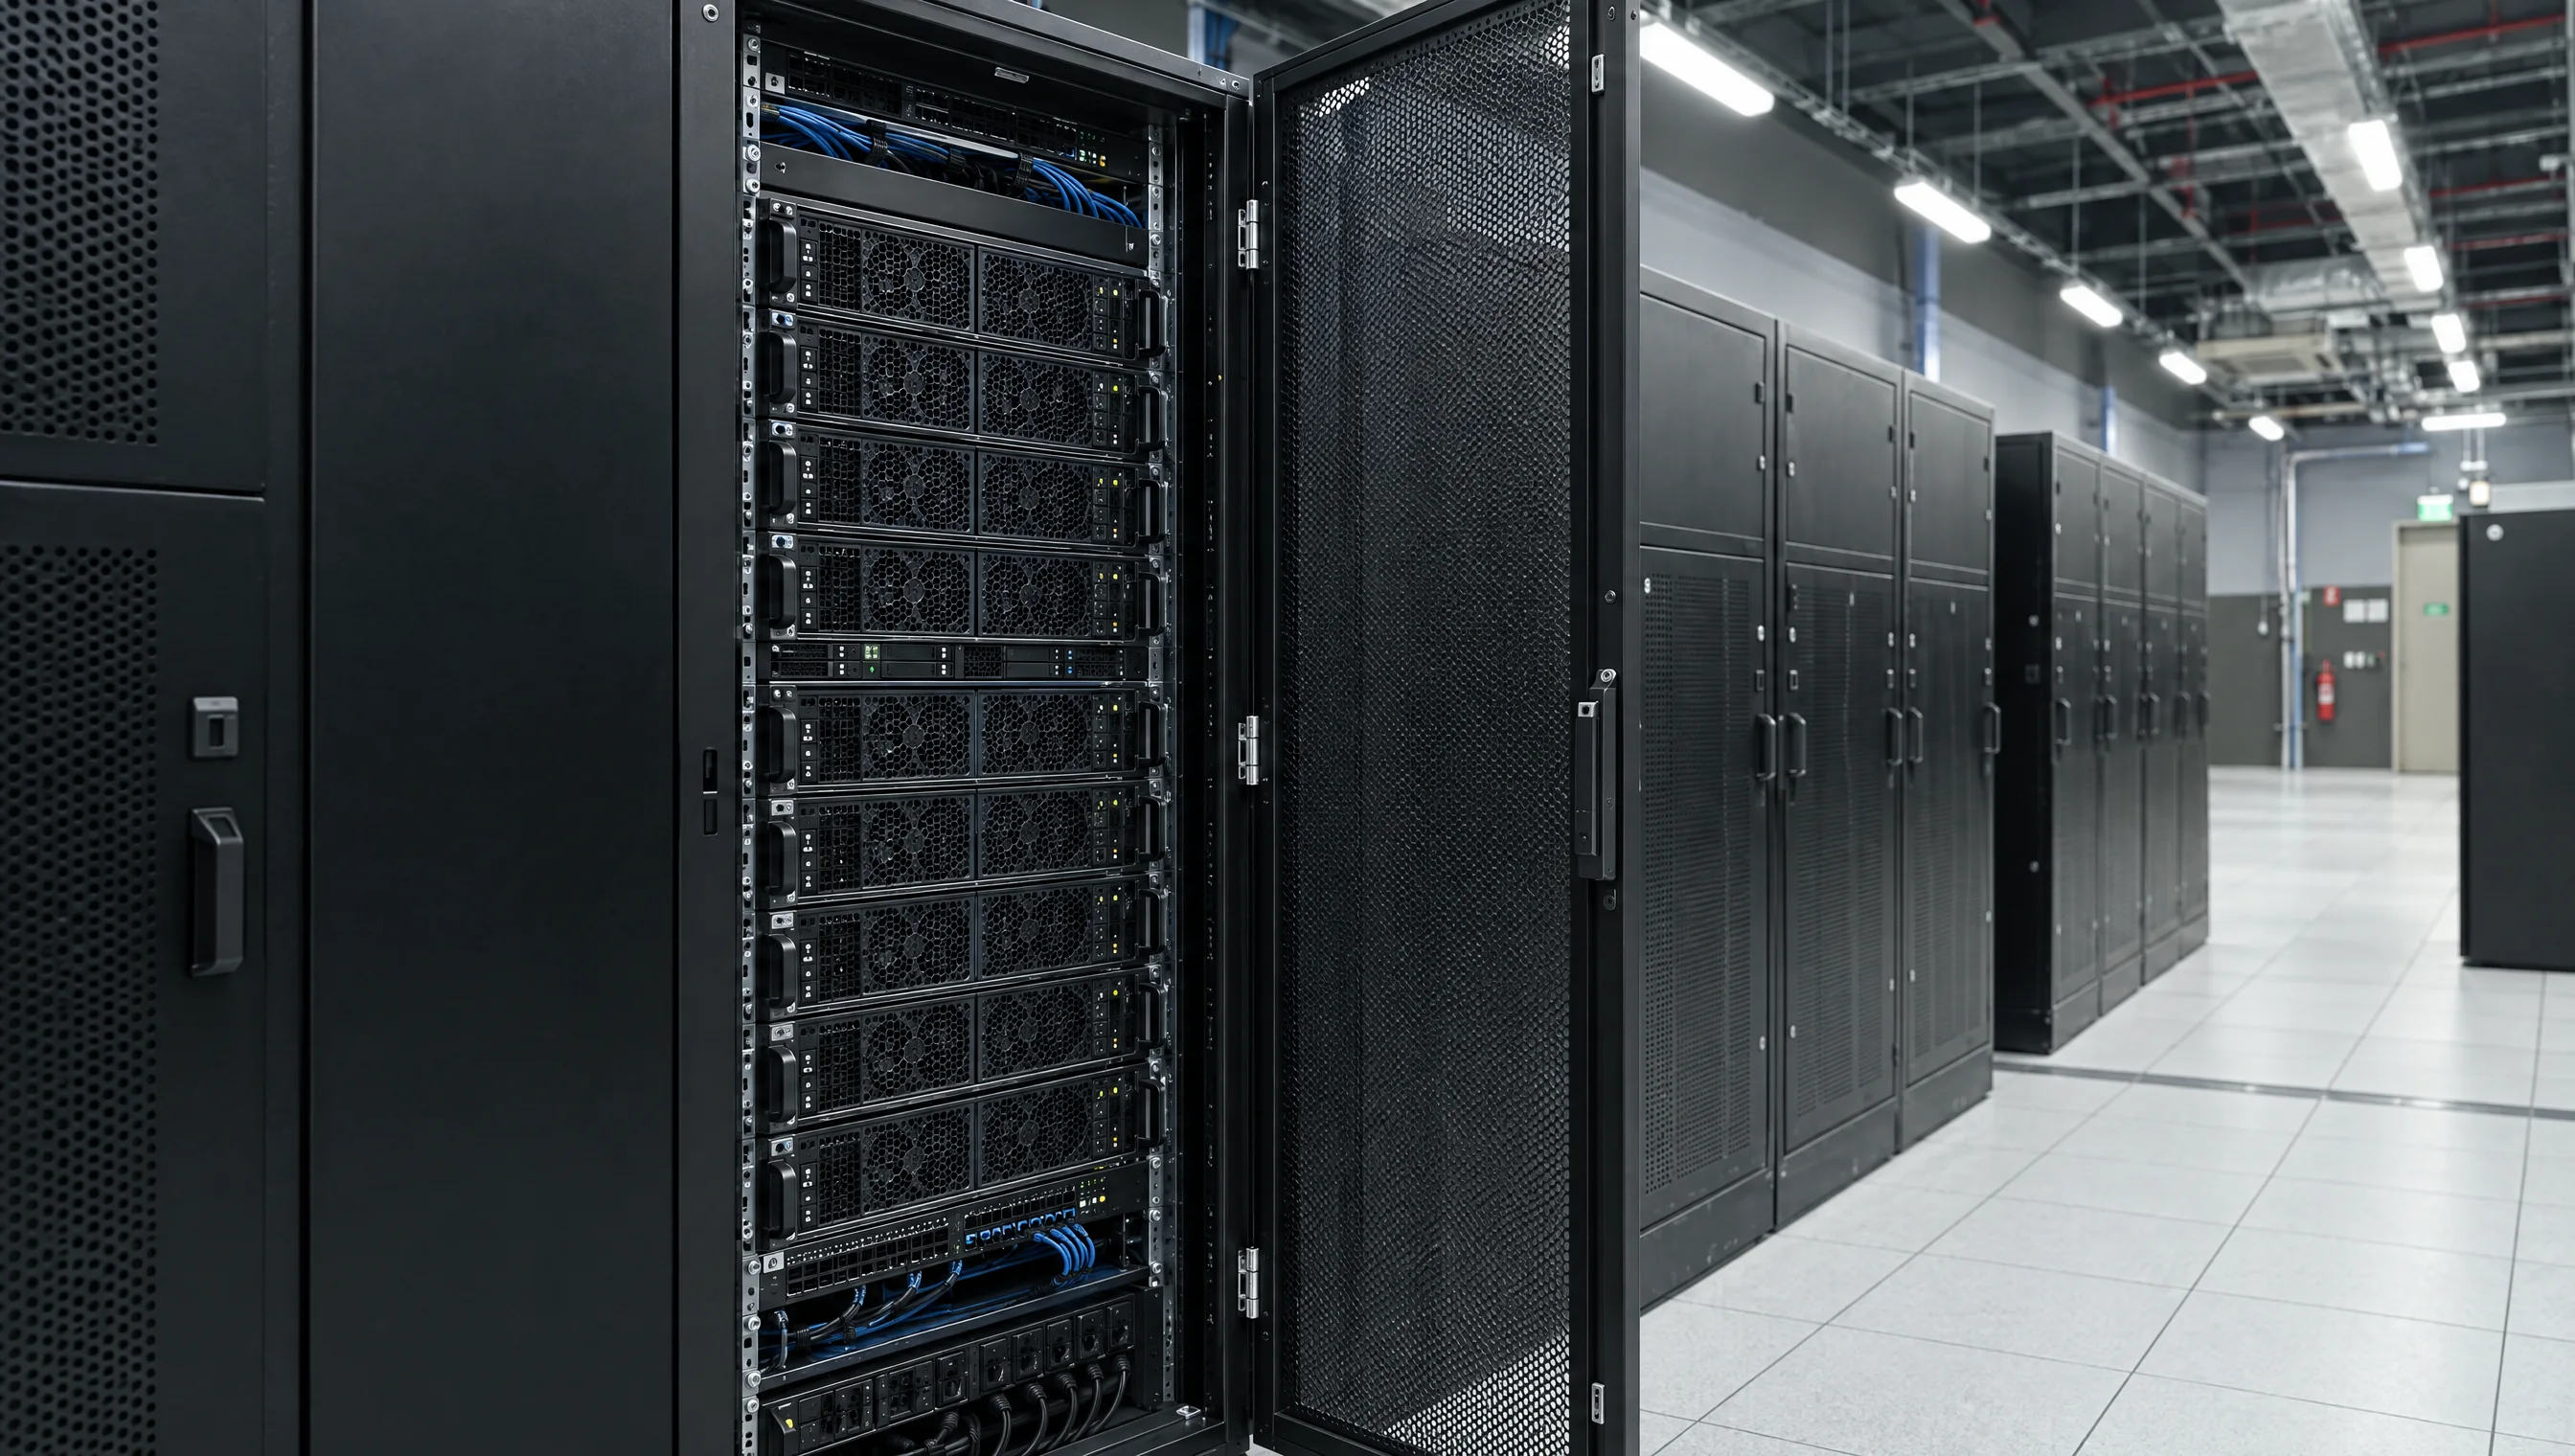
Refrigeração líquida direto nos chips, em racks de 130 kW. Eficiência projetada para cargas intensivas de IA.
24.000+ GPUs
A capacidade cresce em ciclos de seis semanas, com verificações de prontidão antes de cada entrega.
97,4%
Goodput do cluster nos últimos 90 dias: a parcela de capacidade convertida em trabalho útil.
04Rede e armazenamento
Conecte GPUs, dados e armazenamento em uma infraestrutura dedicada ao seu modelo, do primeiro lote de treinamento ao último checkpoint.
Planejar meu clusterRede dedicada
InfiniBand dedicada conecta seu cluster com largura de banda para distribuir o treinamento e mover dados entre GPUs.
800Gb/s
por link InfiniBand XDR, Quantum-X800 para Blackwell
Armazenamento
NVMe local, WEKA e armazenamento compatível com S3 para carregar datasets e salvar checkpoints na escala do seu projeto.
720GB/s
de leitura agregada por pod, com WEKA dedicado
Transferência de dados
Entrada de dados e tráfego entre nós sem cobrança, com uma franquia de saída incluída para planejar sua operação.
20TB
de saída incluídos por nó, por mês
CONHEÇA A TENSORBAY
Conheça as GPUs, a infraestrutura e os preços para levar seu projeto de IA adiante.
RESERVAS ANTECIPADAS
Veja a configuração Vera Rubin em escala de rack e o cronograma de reserva antecipada.
NVIDIA VR200 NVL72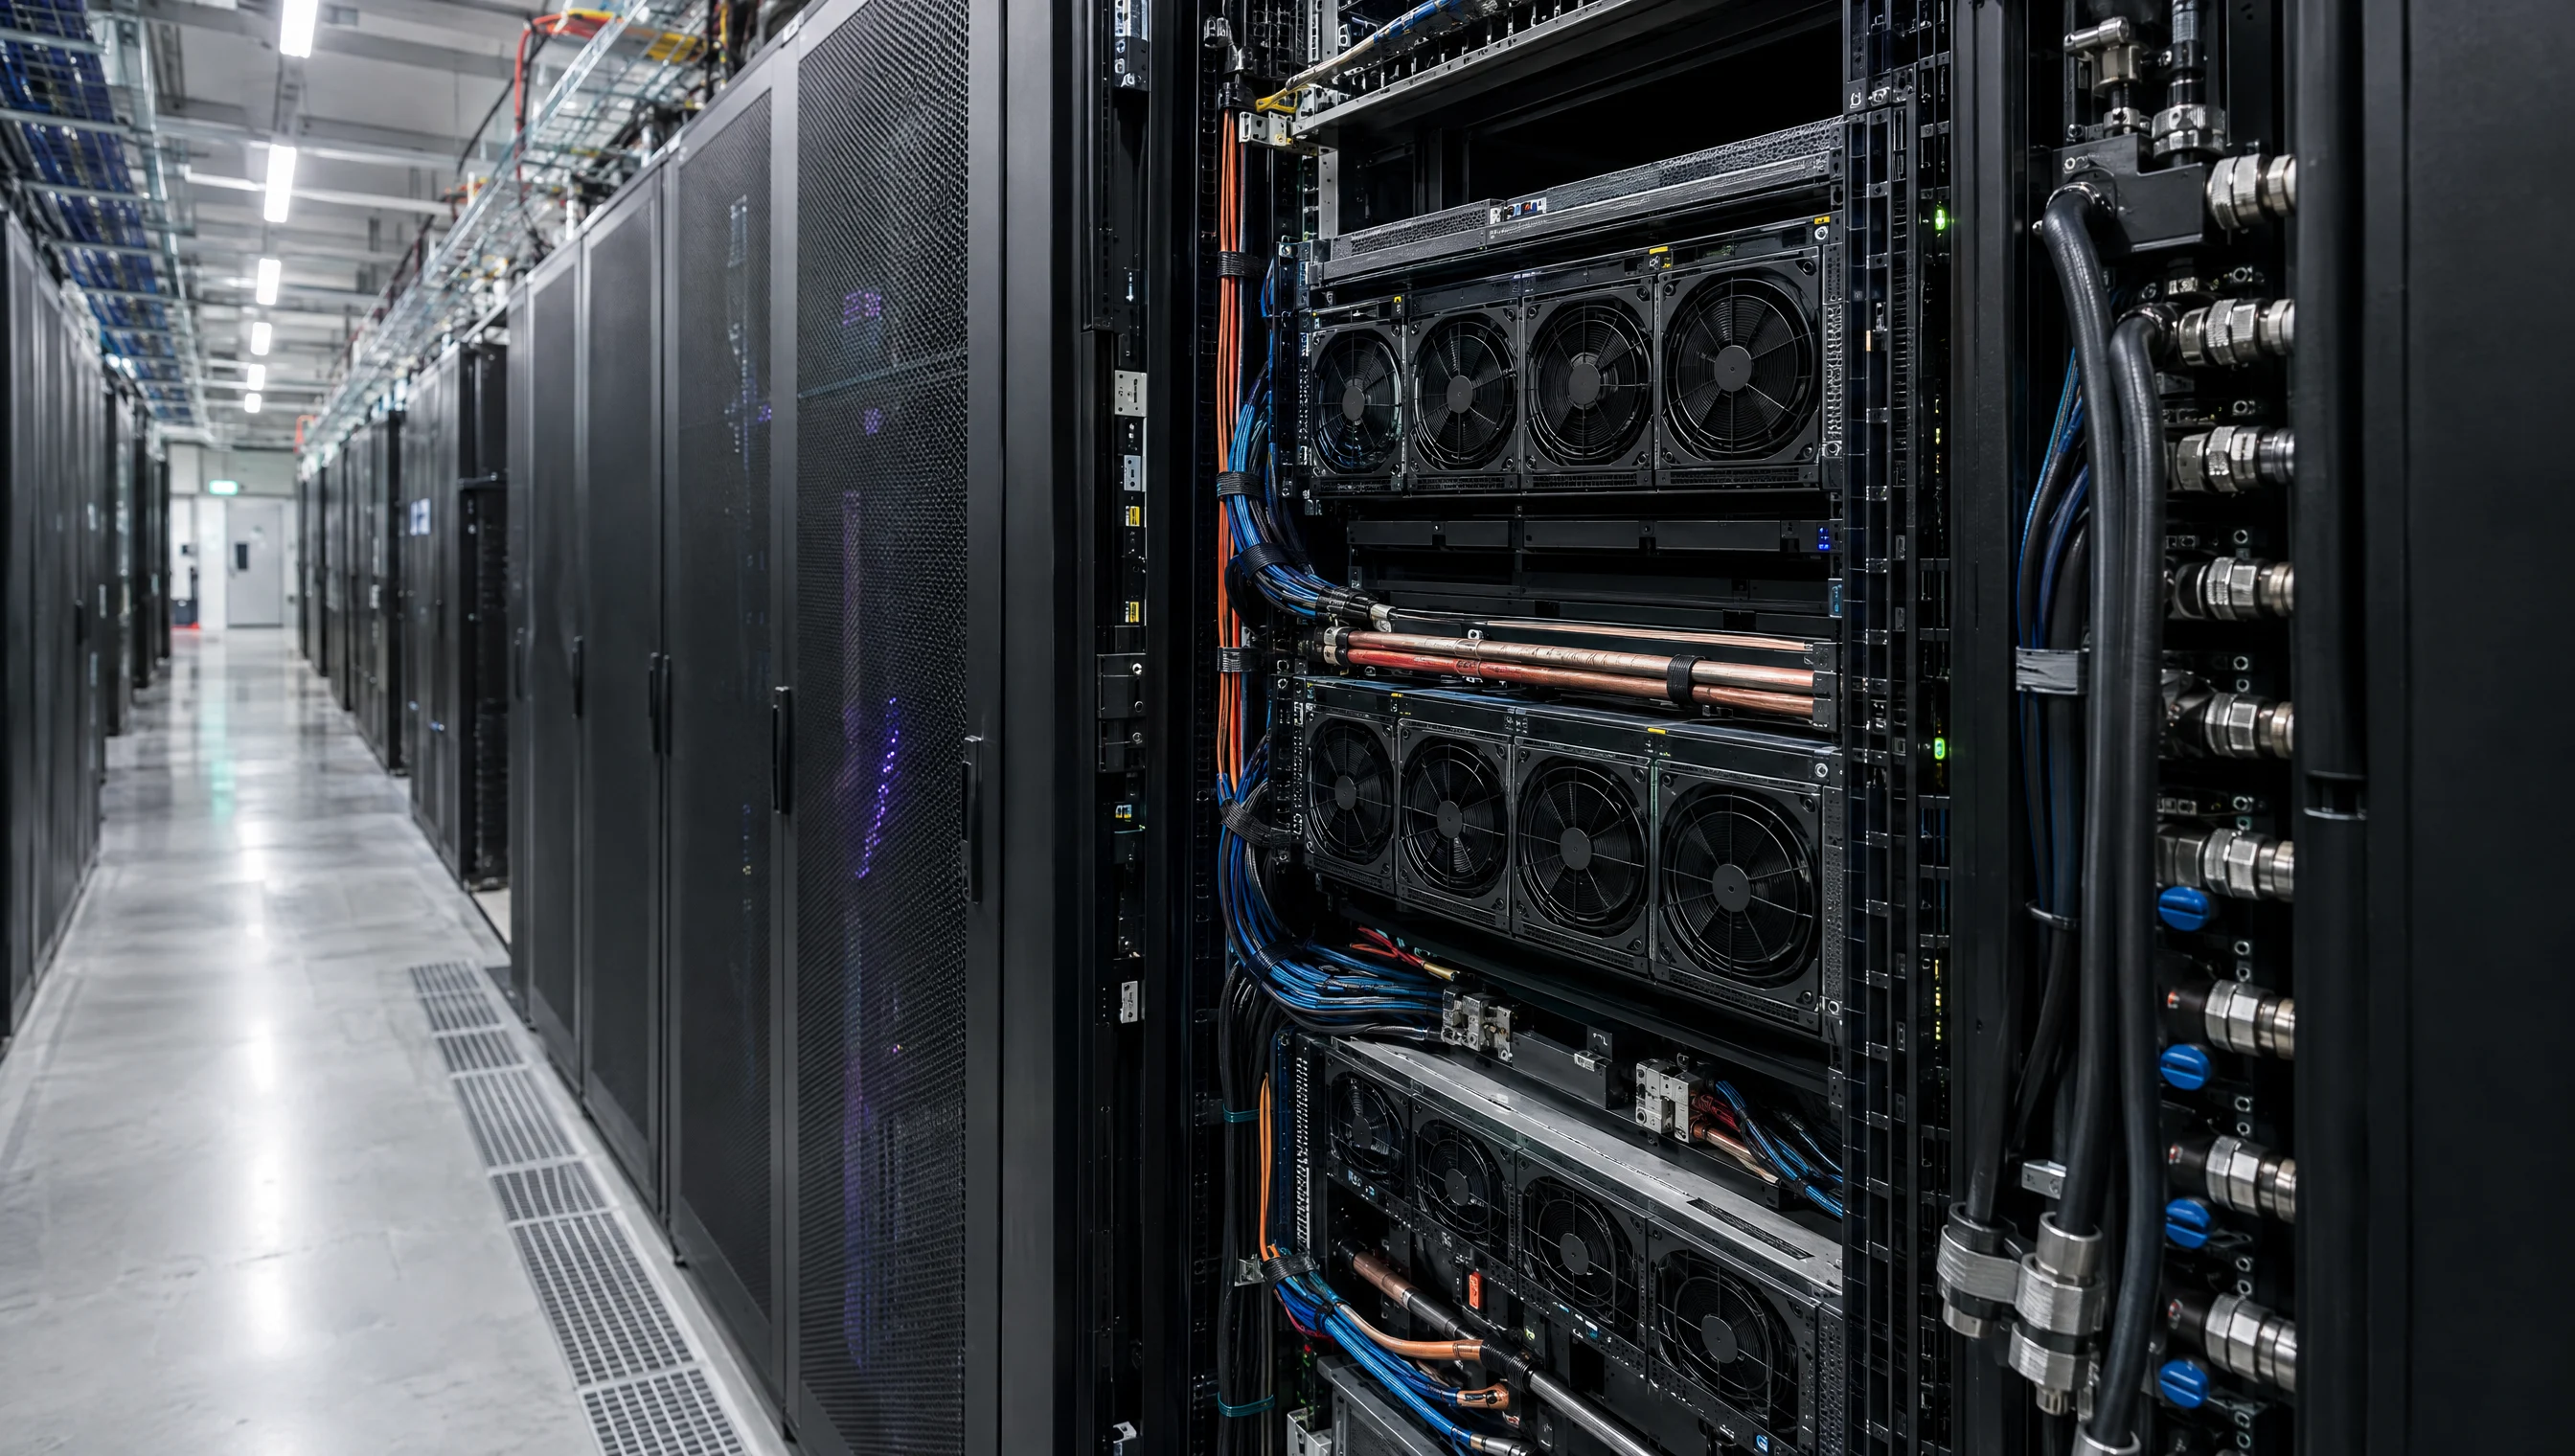
COMPUTAÇÃO GPU
Compare as configurações TensorBay, da geração mais nova às anteriores.
Encontre a GPU NVIDIA ideal
PREÇOS
Compare reservas mensais e anuais para nós GPU e sistemas em escala de rack.
Planeje com tarifas publicadas05Invista no próximo passo
Escolha o prazo da reserva, compare a capacidade e planeje seu investimento. Aqui, a conversa começa com os preços abertos.
| GPU e memória | Contrato mensalReserva por contrato mensal | Contrato anualMenor valor por hora |
|---|---|---|
NVIDIAHGX B300288 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 83,20/h | Anual a partir de Cotar anualUS$ 58,50/h |
NVIDIAHGX B200180 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 72,80/h | Anual a partir de Cotar anualUS$ 50,70/h |
NVIDIAHGX H200141 GB HBM3e por GPU | Mensal a partir de Cotar mensalUS$ 44,20/h | Anual a partir de Cotar anualUS$ 31,20/h |
NVIDIAHGX H10080 GB HBM3 por GPU | Mensal a partir de Cotar mensalUS$ 28,60/h | Anual a partir de Cotar anualUS$ 19,50/h |
O valor por hora é do nó completo com 8 GPUs. Escolha o contrato para solicitar sua cotação.
Cada detalhe na conta
Veja o que está incluído e consulte as tarifas de armazenamento, transferência de dados e rede.
Falar com um especialistaValores em USD por hora de nó HGX com 8 GPUs; sistemas rack-scale são cotados por rack. Impostos não incluídos. Gerenciamento de Slurm e Kubernetes sem custo adicional. Armazenamento e Direct Connect seguem as tarifas acima. Consulte condições para contratos de longo prazo.
Receber minha propostaOs preços publicados para HGX são em USD por hora de um nó completo com 8 GPUs, dentro de uma reserva mensal ou anual. Sistemas NVL72 têm cotação por rack. Os valores não incluem impostos.
Compare a memória da GPU, os requisitos de rede e a carga de treinamento ou inferência. A seção de hardware apresenta H100, H200, B200, B300 e sistemas de rack completo. Nossa equipe ajuda a dimensionar a configuração a partir do modelo, dos dados e da capacidade necessária.
Sim. A TensorBay oferece infraestrutura dedicada de GPUs NVIDIA para treinamento de modelos, fine-tuning e inferência. Você pode trabalhar com Slurm, Kubernetes ou SSH e configurar o ambiente de software para sua carga de trabalho.
Informe a GPU, a capacidade e o prazo da reserva, ou conte sobre seu projeto. A equipe avalia os requisitos e prepara uma proposta em até 48 horas, com configuração e prazo de entrega. A capacidade e as condições finais são confirmadas na proposta.
08Vamos dar escala à sua ideia
Traga seu desafio. Nossa equipe ajuda a definir as GPUs, a capacidade e o prazo. Em até 48 horas, você recebe uma proposta para tirar o projeto do papel ou levá-lo mais longe.