
部分 Blackwell 系统支持 InfiniBand XDR 链路。
统筹规划网络、存储与数据传输
专属 WEKA 每个 Pod 的聚合读取吞吐量。
每个节点每月包含的数据出口流量。
部分 HGX 节点配备本地 NVMe。
追踪数据路径
从工作负载到检查点,路径清晰可见。
将计算、集群网络与存储纳入统一配置。合适的数据路径取决于任务类型、并行方式与数据保存模式。
01 计算
专属 GPU 节点
根据模型、显存需求与训练或推理工作负载,选择节点或机架级算力。
02 互连
以 InfiniBand 连接集群
使用专属高速网络连接 GPU,并根据节点之间的通信需求进行规划。
03 数据
为每个阶段匹配存储
结合本地 NVMe、并行文件存储和兼容 S3 的对象存储,满足数据集与检查点需求。
TENSORBAY AIFACTORY01 / 03
计算
专属 GPU 节点专属网络
为你的 GPU 打造的网络。
专属 InfiniBand 将集群连接起来,为分布式训练和 GPU 间数据交换提供带宽。
800Gb/s
每条 InfiniBand XDR 链路,Blackwell 配备 Quantum-X800

网络规格
- Hopper 训练网络
- 每节点 8×400 Gb/s InfiniBand NDR(3.2 Tbps),采用轨道优化的无阻塞胖树拓扑,支持 SHARP 网内归约。
- Blackwell 训练网络
- Quantum-X800 InfiniBand XDR,每链路 800G;GB200 机架采用 72 GPU 一致性 NVLink 5 互连域,每 GPU 带宽 1.8 TB/s。
- 收敛比
- 各层均为 1:1,不与其他租户共享东西向网络或脊交换机。
- 前端网络
- 每节点双 100 GbE,提供 DDoS 防护,支持自带 IP 地址。
存储
让数据跟上计算节奏。
本地 NVMe、WEKA 和 S3 兼容存储,支持按项目规模加载数据集与保存检查点。
最高
720GB/s
采用专属 WEKA 时,每计算单元的聚合读取吞吐量
存储规格
- 本地临时存储
- 每节点 30 TB NVMe Gen5,读取速度约 55 GB/s,无需占用网络即可暂存检查点。
- 并行文件系统
- 托管 WEKA,每集群独享;每计算单元聚合读取吞吐量最高 720 GB/s,支持 POSIX 与 GPUDirect Storage。
- 对象存储
- 兼容 S3,采用 NVMe 缓存,与计算资源同站点部署;热存储每 GB 每月 $0.055。
数据传输
让数据流动更自由。
入站和节点间流量免费,并包含出站流量额度,便于提前规划运营成本。
20TB
每节点每月包含的出站流量
数据传输条款
- 数据传输
- 入站 $0,每节点每月包含 20 TB 出站流量,超额 $1.25/TB;节点间传输 $0。年度预留合约免费提供 100G Direct Connect。
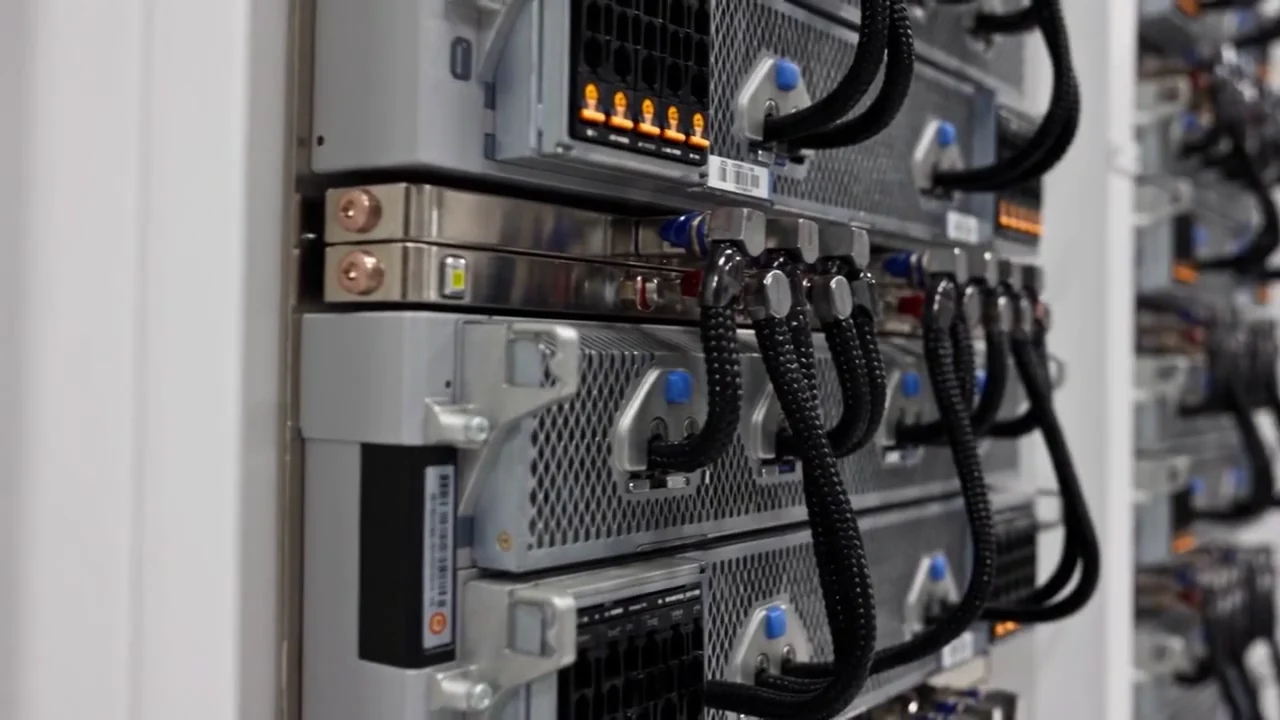
交付前完成测试
从一套值得信赖的集群开始。
每套集群都会经过 72 小时的负载、内存、网络和温度测试。团队可在确认交付前查看测试结果。
72h
交付验收测试
负载 · 内存 · 网络 · 温度检查
AI 工作负载
- TENSORBAY AIFACTORY模型训练专属 GPU 算力与高速网络,支持长时间训练任务。
- TENSORBAY AIFACTORY微调与研究8-GPU 节点支持模型适配与实验迭代。
- TENSORBAY AIFACTORY生产推理高显存系统为专属基础设施上的模型服务提供算力。
- 01围绕项目定制的配置
- 02包含交付时间的方案
- 03启用前的验收测试
05为下一步投入算力
算力助力增长,价格让决策更清晰。
选择预留期限,比较算力配置,规划投入。从公开透明的价格开始沟通。
| GPU 与显存 | 月度合约按月度合约预留算力 | 年度合约更低的小时费率 |
|---|---|---|
NVIDIAHGX B300288 GB HBM3e 每 GPU | 月度 起价 获取月度报价US$ 83.20/小时 | 年度 起价 获取年度报价US$ 58.50/小时 |
NVIDIAHGX B200180 GB HBM3e 每 GPU | 月度 起价 获取月度报价US$ 72.80/小时 | 年度 起价 获取年度报价US$ 50.70/小时 |
NVIDIAHGX H200141 GB HBM3e 每 GPU | 月度 起价 获取月度报价US$ 44.20/小时 | 年度 起价 获取年度报价US$ 31.20/小时 |
NVIDIAHGX H10080 GB HBM3 每 GPU | 月度 起价 获取月度报价US$ 28.60/小时 | 年度 起价 获取年度报价US$ 19.50/小时 |
小时费率涵盖完整的 8 GPU 节点。选择预留期限,获取专属报价。
- SLA
- 月度可用性 99.9%,15 分钟节点更换,并提供有效利用率补偿额度
- 规模
- 128–10,000+ GPU · 每租户专属网络
- 计费
- 预留合约内按分钟计量 · 入站流量 $0
存储
- 本地 NVMe 临时存储,每节点 30 TB已包含
- 并行文件系统,托管 WEKA每集群独享$0.09/GB·月
- 对象存储,S3 兼容热存储NVMe 缓存,同站点部署$0.055/GB·月
- 对象存储,归档$0.015/GB·月
- 快照$0.021/GB·月
数据传输
- 入站流量始终免费$0
- 包含的出站流量20 TB/节点·月
- 超额出站流量所有站点$1.25/TB
- 节点间与东西向流量InfiniBand 网络$0
网络
- 东西向 InfiniBand 网络每集群独享已包含
- 私有 VLAN / VPC已包含
- 额外公网 IPv4IPv6 免费$4/IP·月
- 自带 IP,IPv4 /24 或 IPv6 /48设置费 $200免费
- 托管防火墙$4/节点·月
- DDoS 防护已包含
- Direct Connect 10G / 100G年度合约免费提供 100G$450 / $1,800/月
价格以美元计,按完整的 8 GPU HGX 节点每小时收费;机架级系统按机架报价。价格不含税,包含托管 Slurm 与 Kubernetes 控制平面。存储和 Direct Connect 按上述价格计费,可咨询长期合约方案。
获取我的方案GPU 价格按单块 GPU 还是按节点收费?
公布的 HGX 价格以美元计,按月度或年度预留合约中的完整 8 GPU 节点每小时收费。NVL72 系统按机架报价,价格不含税。
AI 项目应该选择哪款 NVIDIA GPU?
请比较显存容量、网络需求,以及训练或推理工作负载。硬件页面提供 B300、B200、H200、H100 与整机架系统。团队可根据模型、数据集与算力需求协助规划配置。
专属集群能用于训练、微调和推理吗?
可以。TensorBay 提供用于模型训练、微调和推理的专属 NVIDIA GPU 基础设施。你可以使用 Slurm、Kubernetes 或 SSH,并根据工作负载配置软件环境。
申请报价之后会发生什么?
提供所需 GPU、容量与预留期限,或介绍项目需求。团队将在评估后于 48 小时内准备方案,包括配置与交付时间,最终容量和条款在方案中确认。
询价时需要确认哪些部署与交付信息?
请说明团队所在地区、数据存放地、目标部署地区和启动日期。具体数据中心、可交付 GPU 配置、网络访问方式和交付时间在项目方案中确认。部署前可按工作负载约定验收标准。
如何规划 Qwen、DeepSeek 或 Kimi 等模型的算力?
请提供具体模型版本、训练或推理目标与数据规模。结合显存、计算精度、上下文长度、并发和软件兼容性评估容量,再用实际工作负载验证延迟与吞吐。团队会根据项目需求核对可用配置。
GPU 租赁报价是否包含数据传输与存储?
GPU 预留费率与存储、数据传输和额外网络服务分项列出。请提供数据量、预计入站与出站流量,以及所需连接方式,并在方案中确认总费用、计费单位与税费。页面标价为美元,不是人民币。
08让创意拥有成长空间
规划合适的数据路径,让 AI 工作持续推进。
告诉我们 GPU 配置、数据规模以及训练或推理模式。我们将协助规划适合工作负载的网络与存储方案。
- 围绕项目定制的配置
- 包含交付时间的方案
- 启用前的验收测试