GPU 算力
8块 GPU
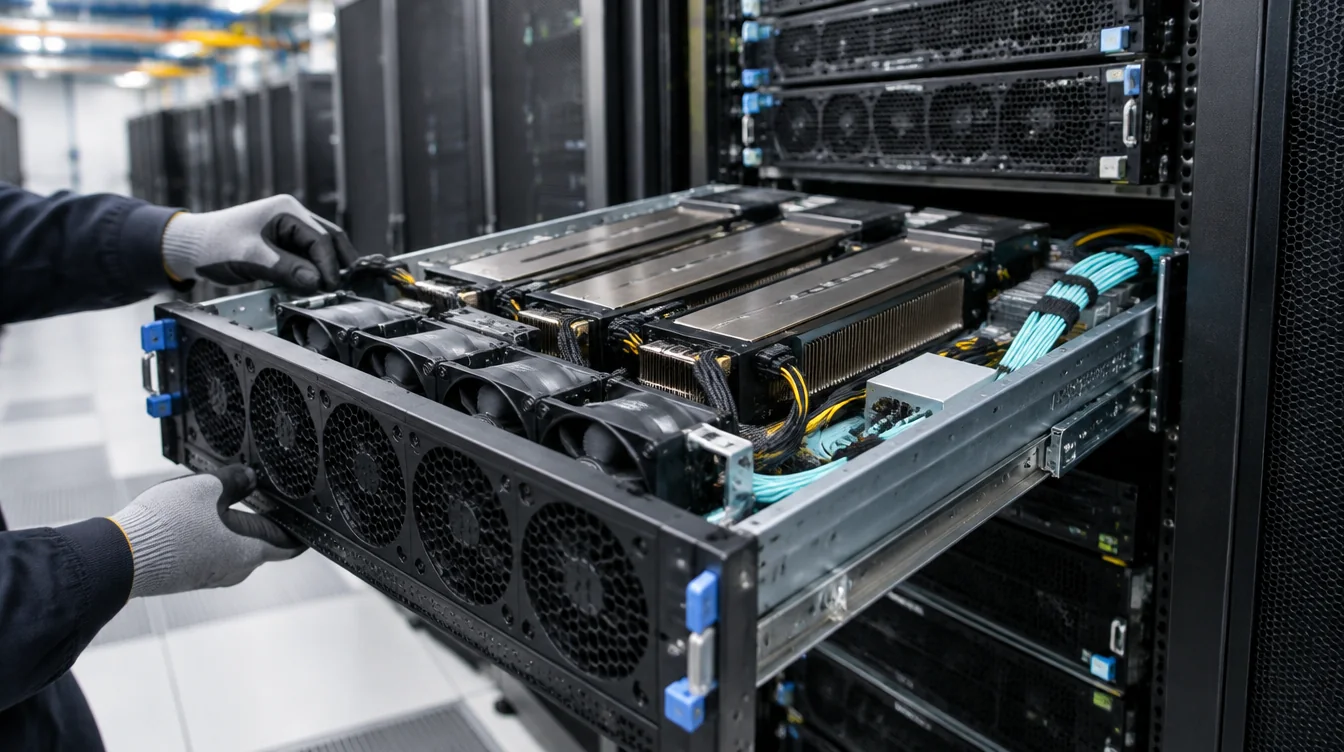
每个 HGX 节点专属算力
节点算力专用于你的工作负载。
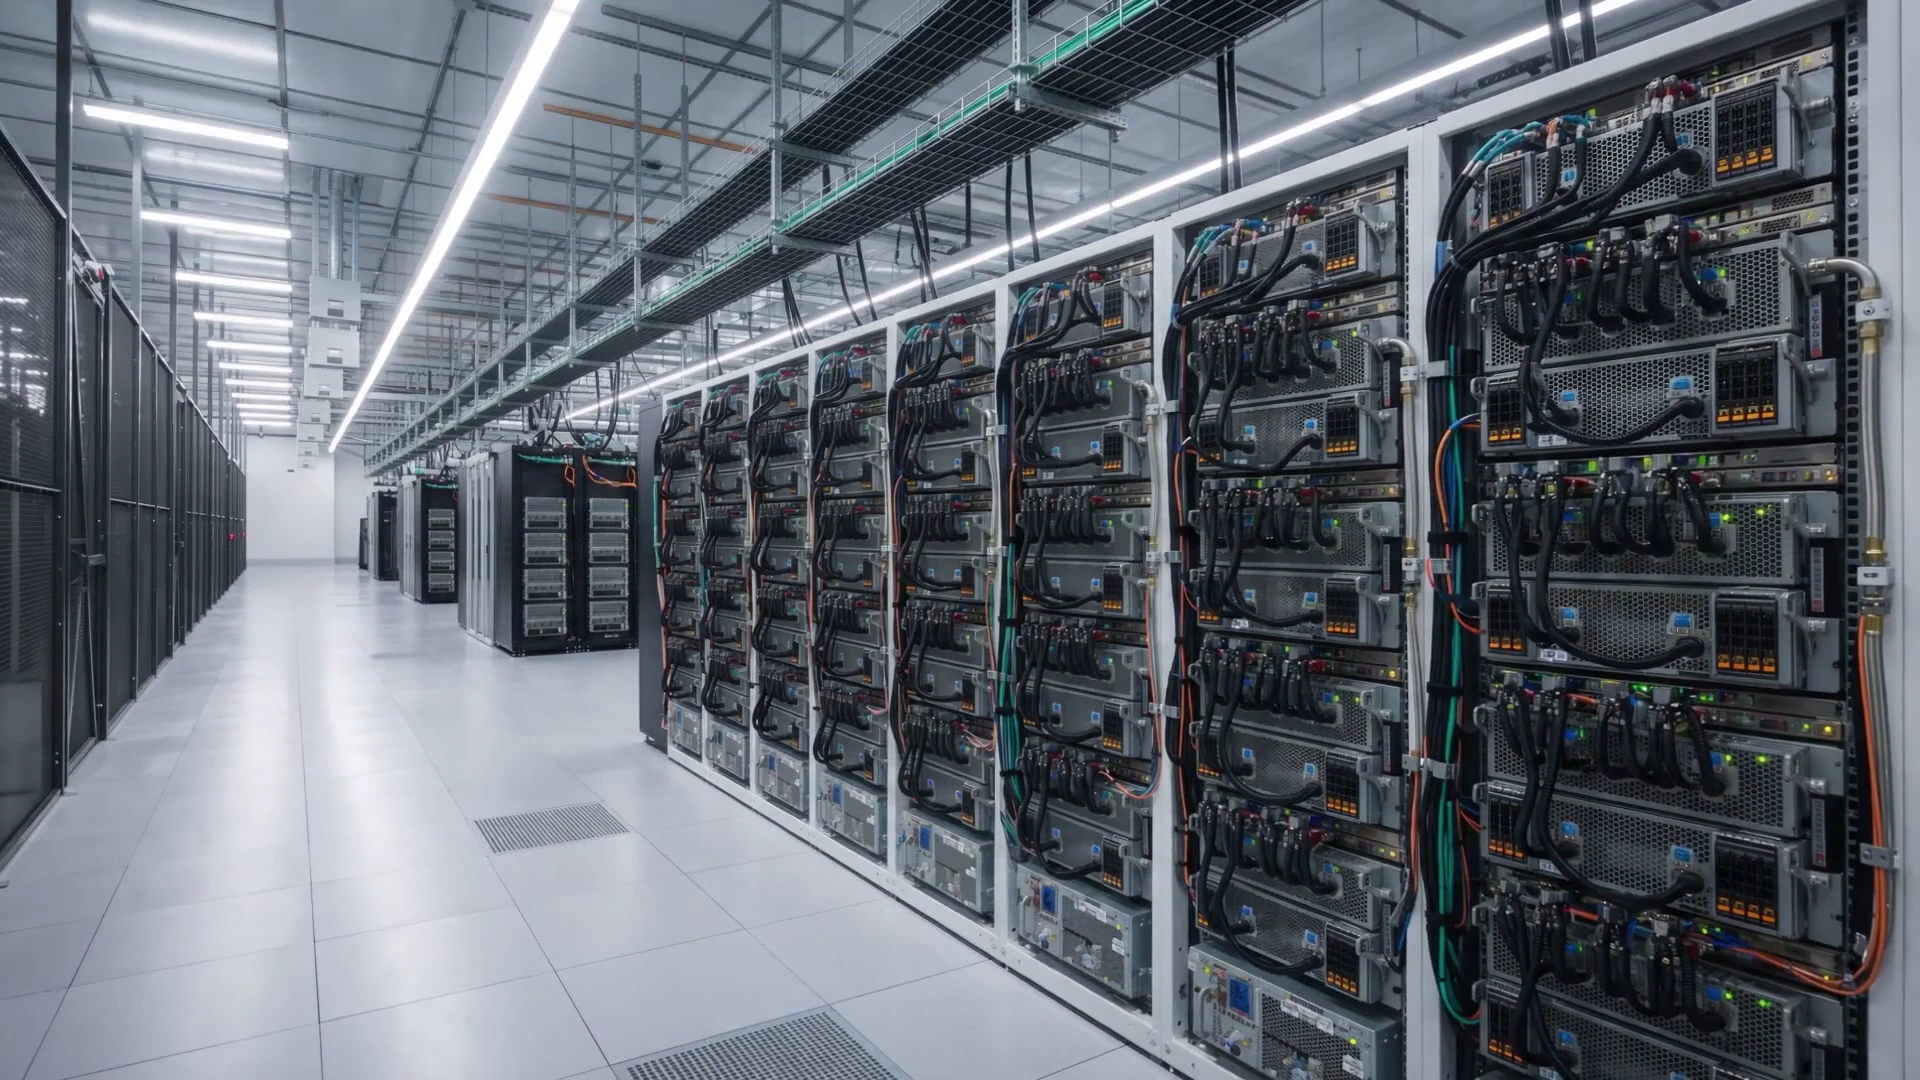
为你的下一次飞跃打造 AI 工厂
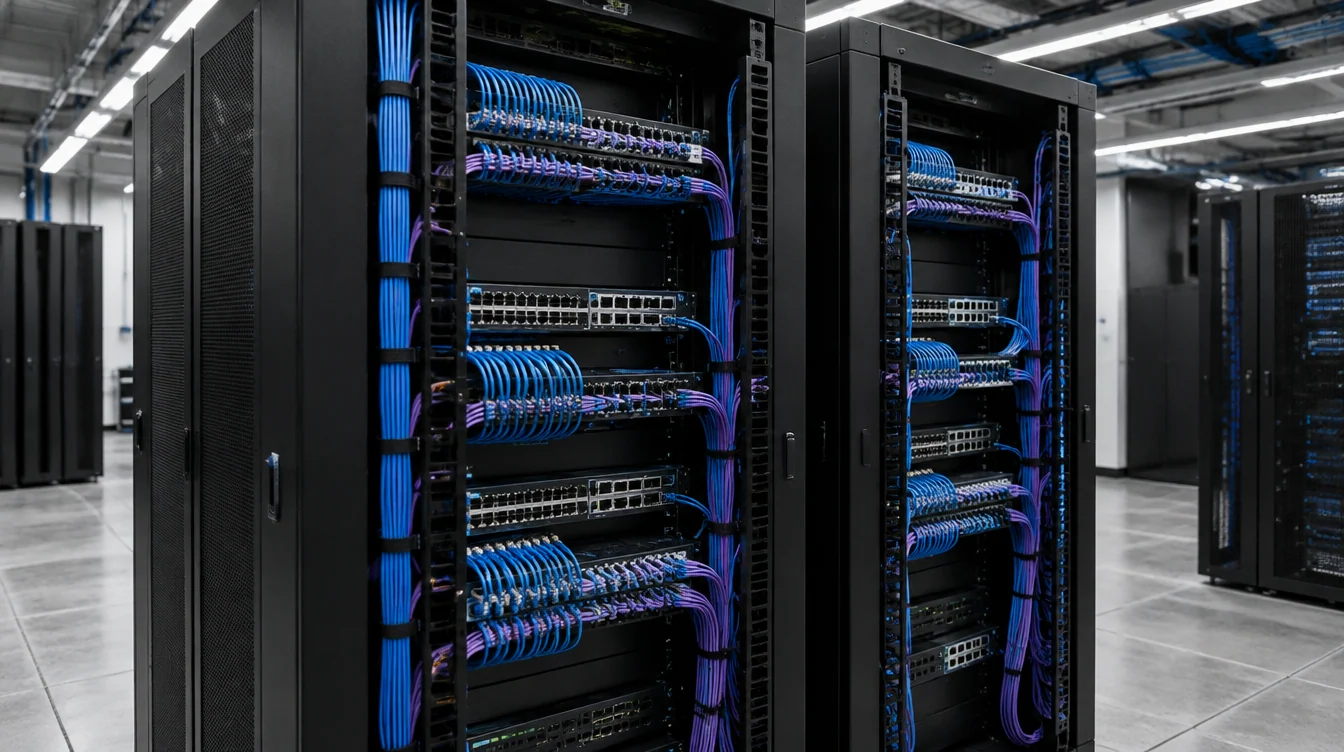
训练更具突破性的模型,让 AI 真正投入生产。专属 NVIDIA GPU、高速网络,以及围绕业务需求打造的集群,助力你的下一步。
8 GPU 节点每小时 $19.50 起 · 年度预留合约
 DeepSeek
 Llama
 Qwen
 Kimi
使用 TensorBay 的团队
02TensorBay 的优势
集群的每一层都为你的团队而设计,让算力更可控、运行更可预测,创新拥有更大空间。
直接运行在专属硬件上,将机器算力集中用于你的工作负载。在项目的每个阶段,掌握性能主动权。
专属节点、网络和存储,为团队提供独享的基础设施,支持训练、实验和 AI 生产部署。
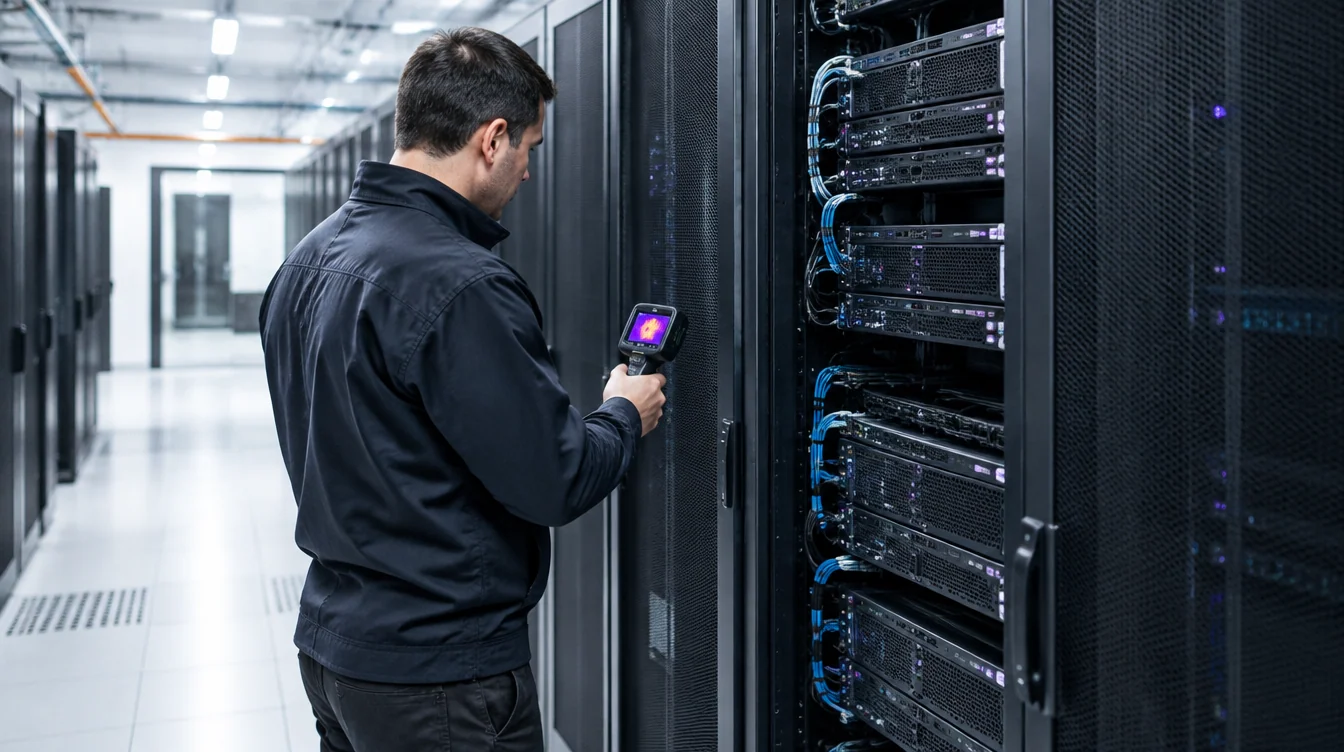
交付前,集群会接受负载、显存、网络和温度测试。你可以先查看结果,再根据验证证据确认交付。
使用自己的驱动、内核与工具。通过 Slurm、Kubernetes 或 SSH,构建适合模型需求的软件环境。
同机架备用节点有助于降低硬件需要维护时对项目连续性的影响。
公开价格,预留合约内按分钟计量,每节点每月包含 20 TB 出站流量。提前看清成本,规划业务。
为工作而建
TensorBay 将专属算力、网络、存储和熟悉整个技术栈的团队整合进同一个运行体系,并围绕你的工作负载构建。
 TENSORBAY AIFACTORY
专属 GPU 集群围绕模型、数据路径与交付时间设计。没有嘈杂邻居,也没有隔在团队与硬件之间的层级。
网络、存储与验收测试一同规划,让团队从第一次运行到生产容量始终有清晰路径。
03支撑雄心的基础设施
电力、冷却、GPU 与网络,由我们统一设计和运营,为 AI 提供可持续扩展的基础设施。
PUE 1.12
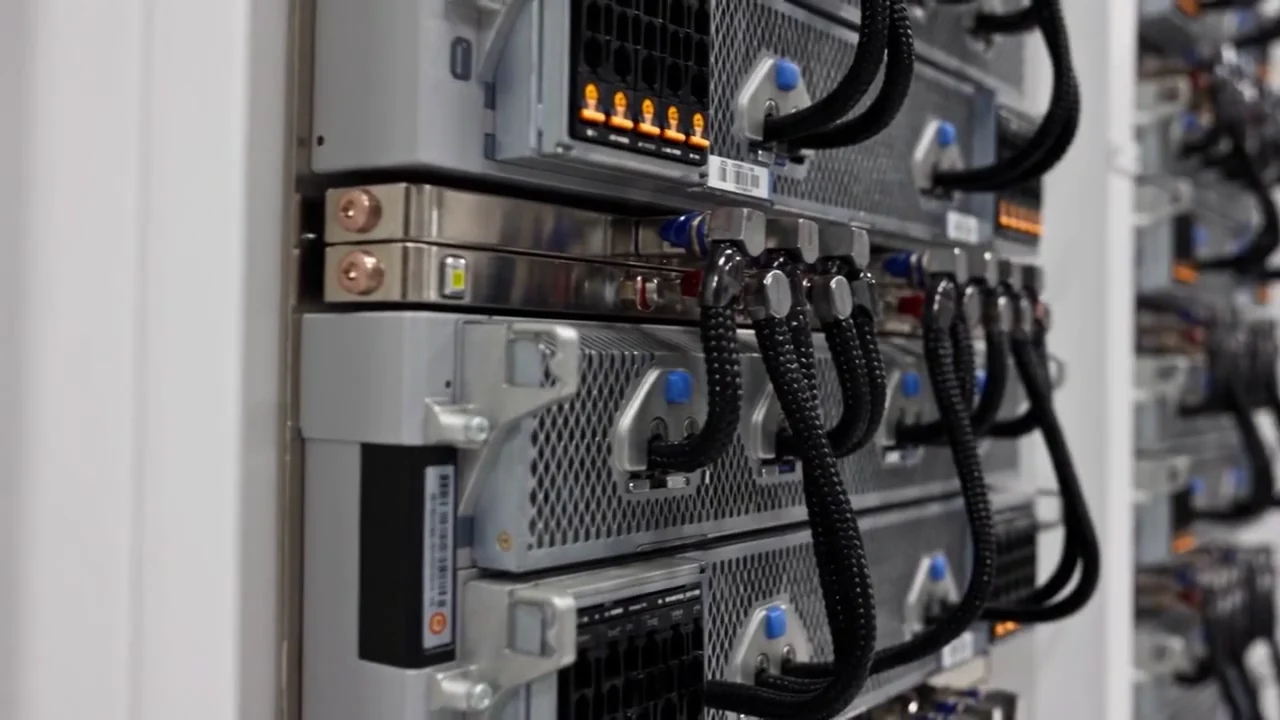
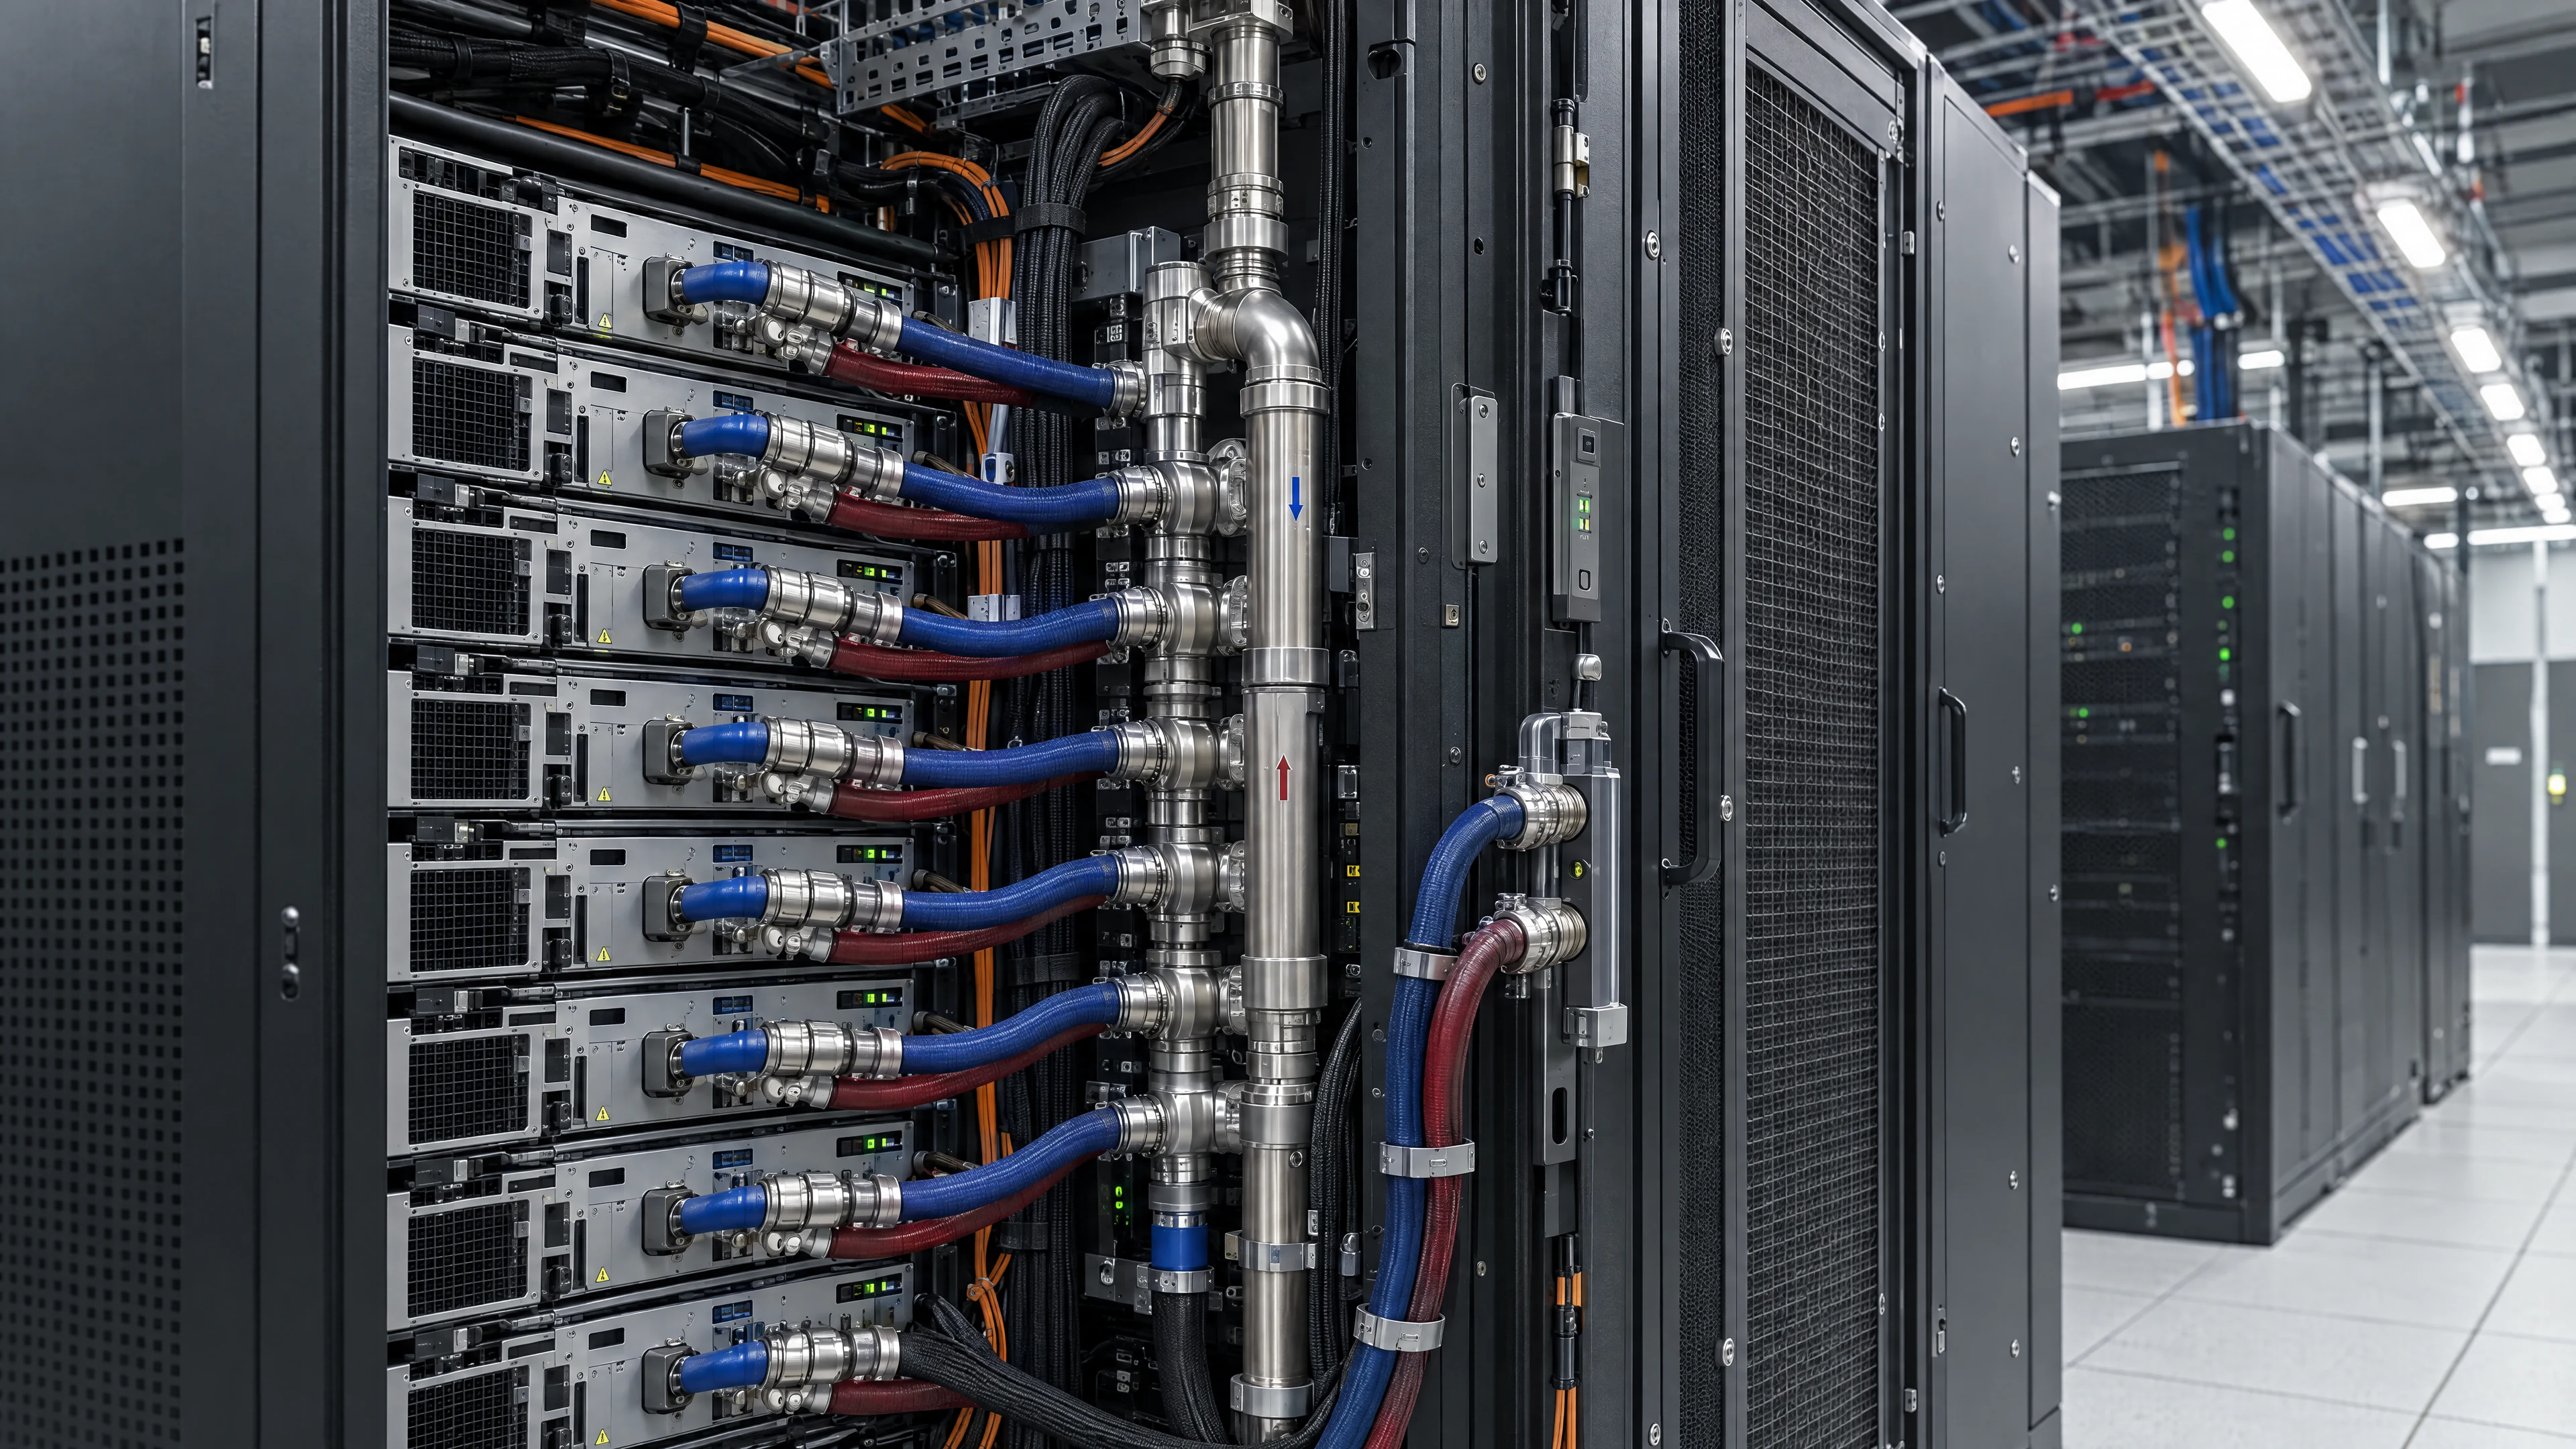
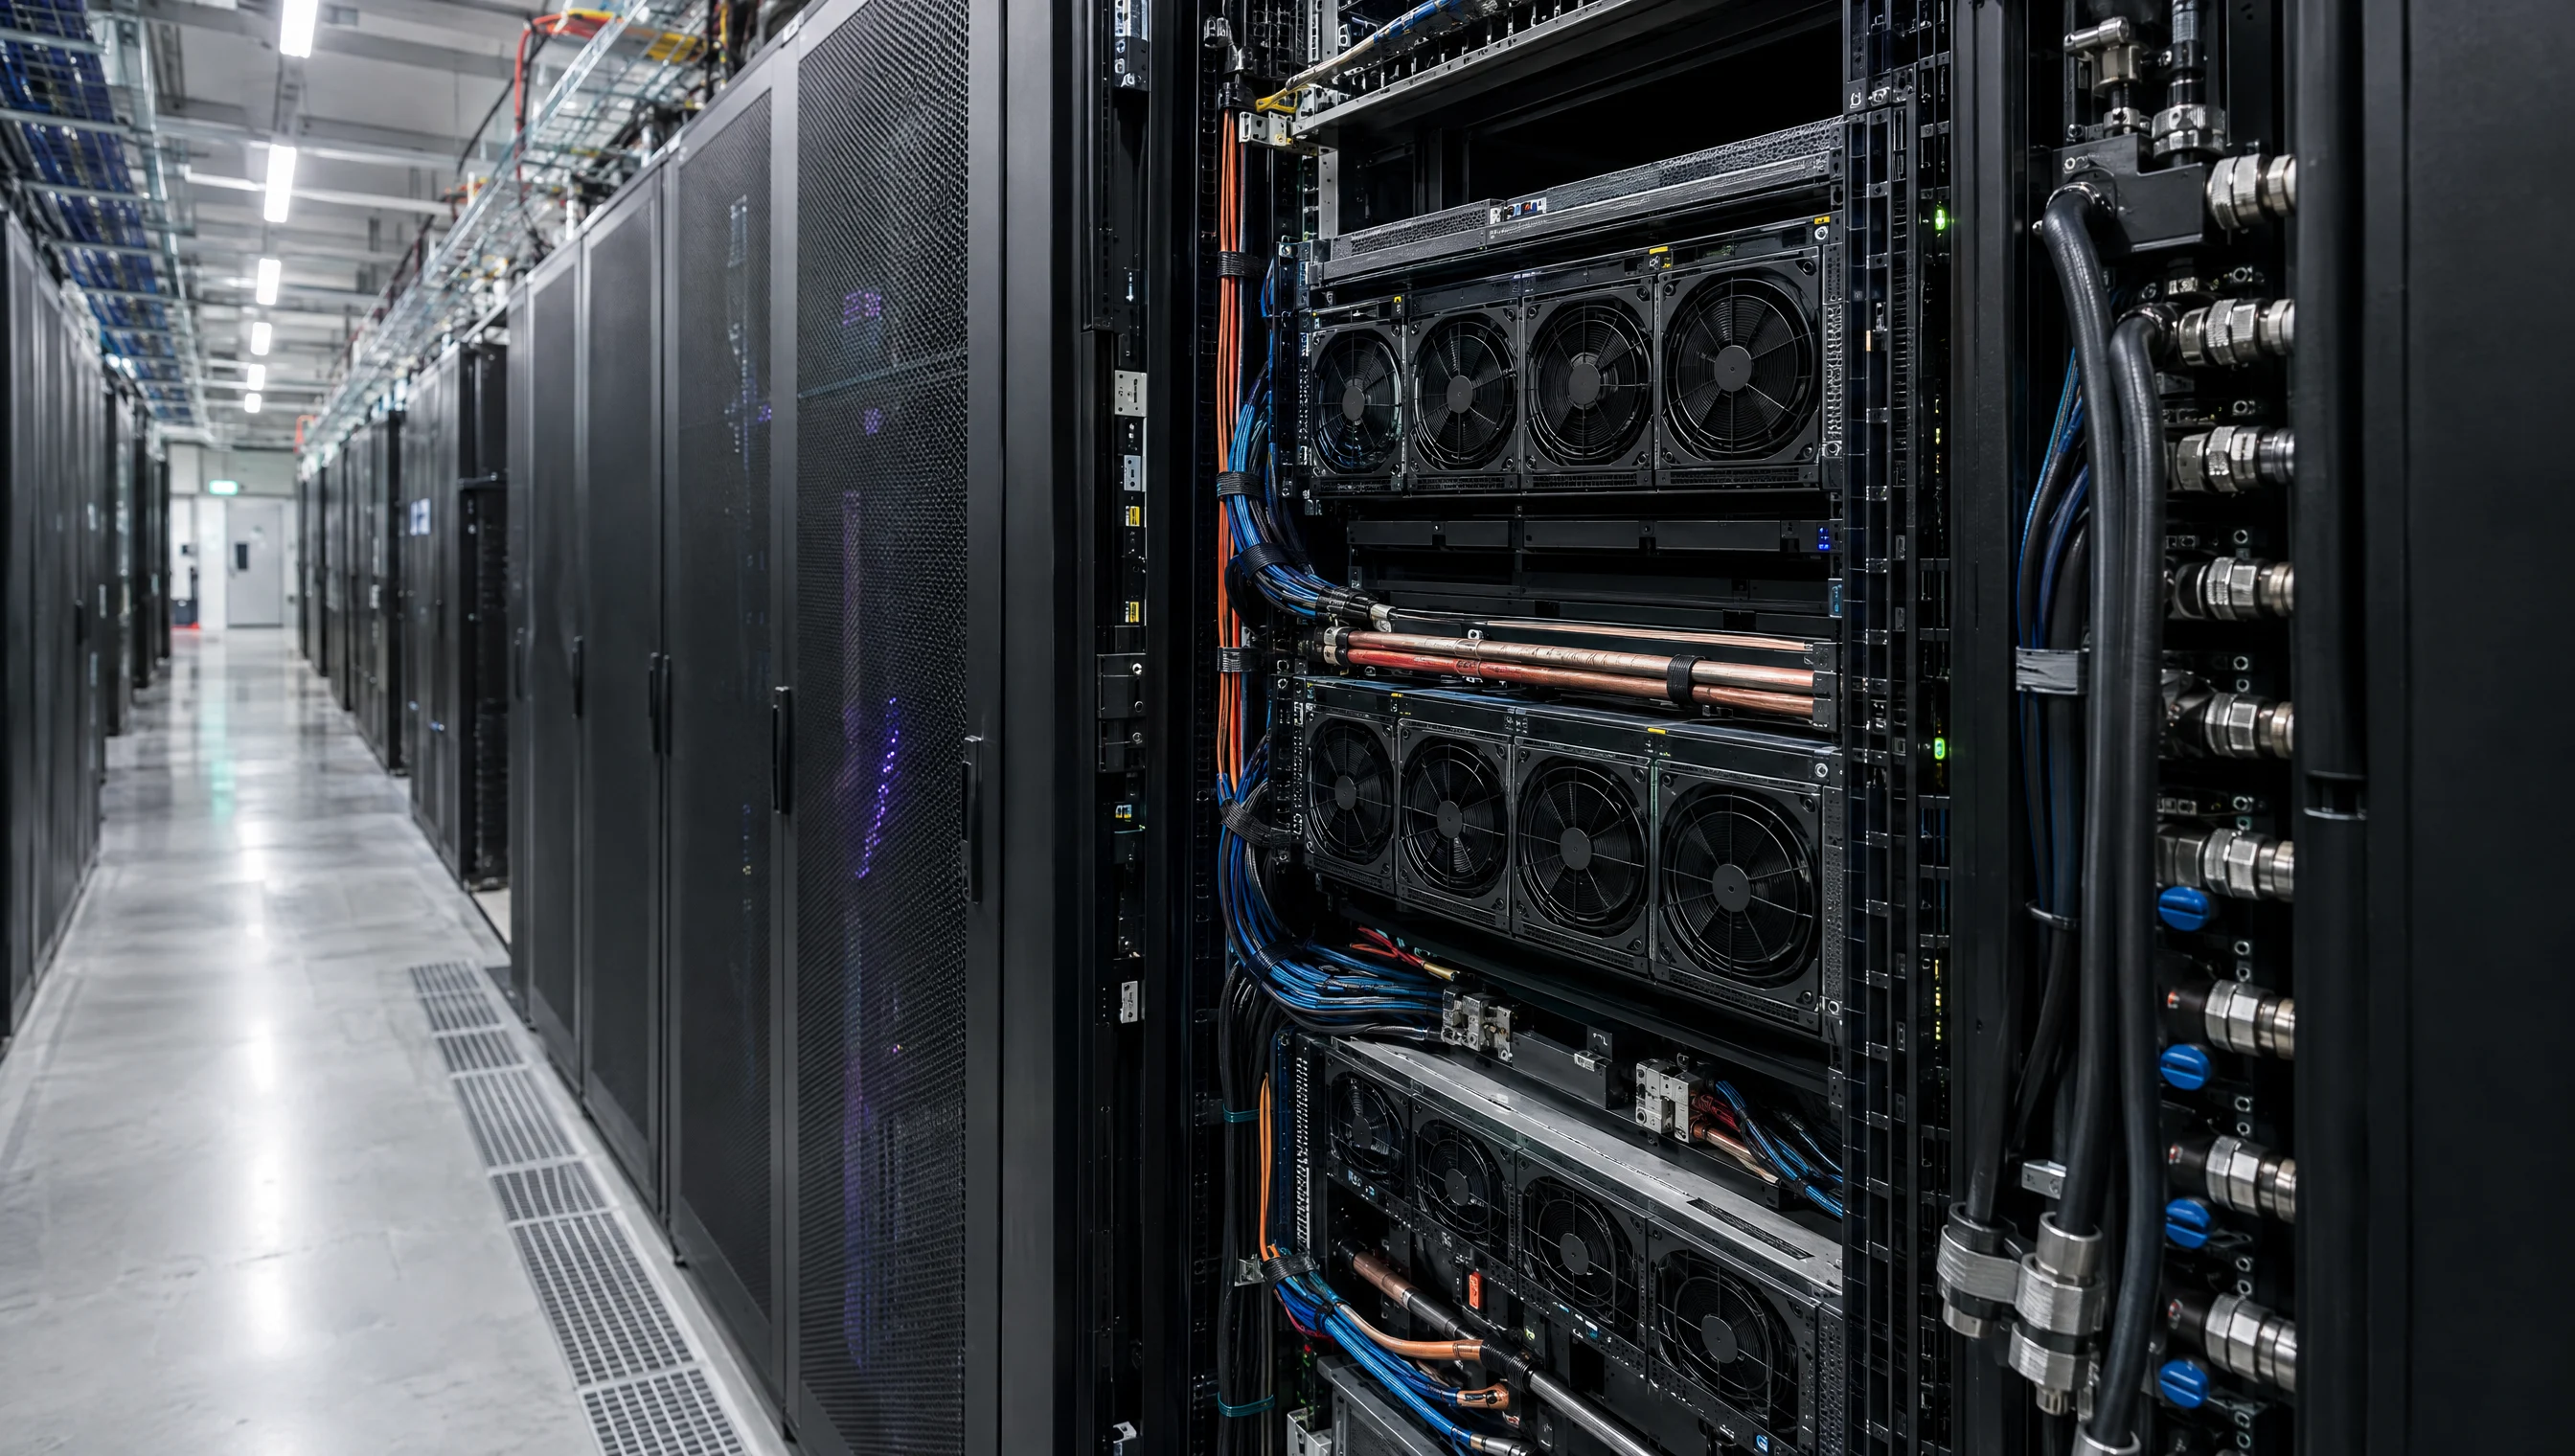
130 kW 机架采用芯片直冷液冷技术,面向高强度 AI 工作负载设计。
24,000+ GPUs
容量按六周周期扩展,每次交付前都会进行准备情况检查。
97.4%
过去 90 天的集群有效利用率,即实际转化为有效计算工作的容量占比。
交付前完成测试
每套集群都会经过 72 小时的负载、内存、网络和温度测试。团队可在确认交付前查看测试结果。
负载 · 内存 · 网络 · 温度检查
AI 工作负载
探索 TensorBay
了解可用 GPU、基础设施与价格,为 AI 项目规划下一步。
08让创意拥有成长空间
告诉我们你的挑战。团队将协助确定 GPU、容量和时间安排,并在 48 小时内提供方案,支持项目启动或进一步扩展。