
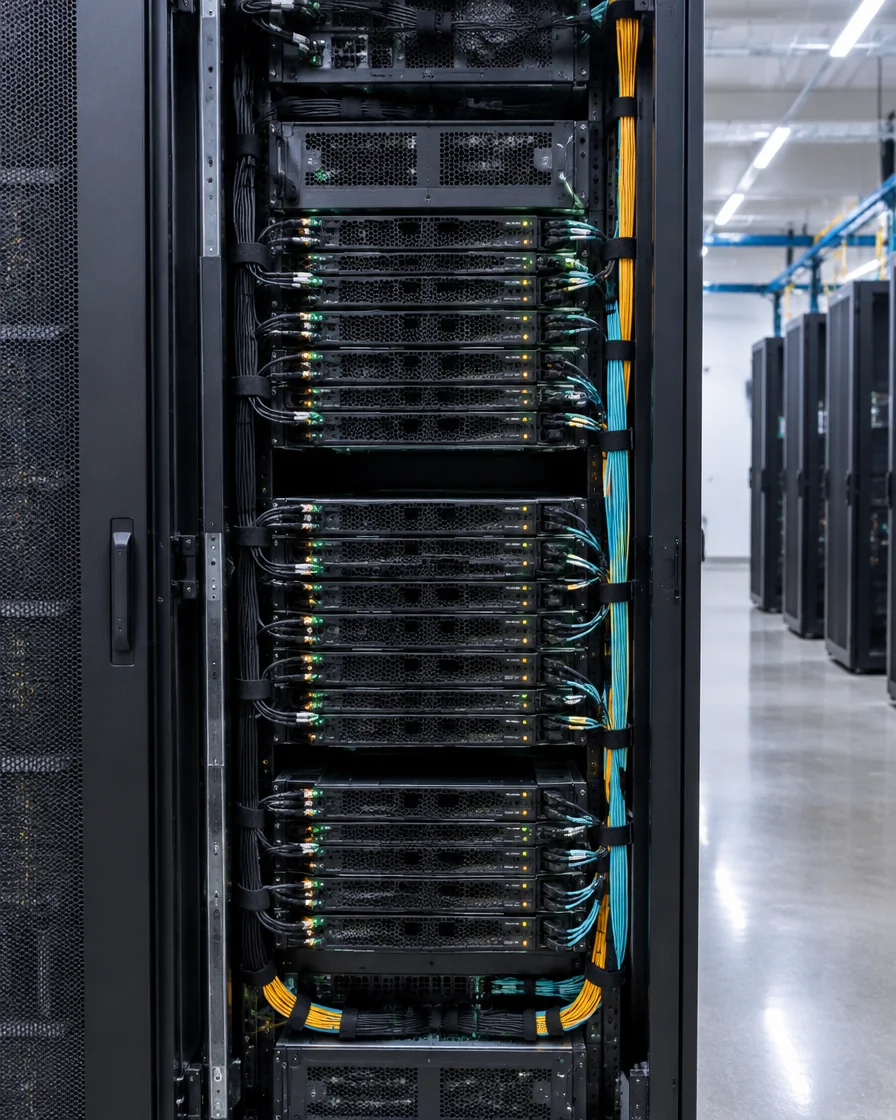
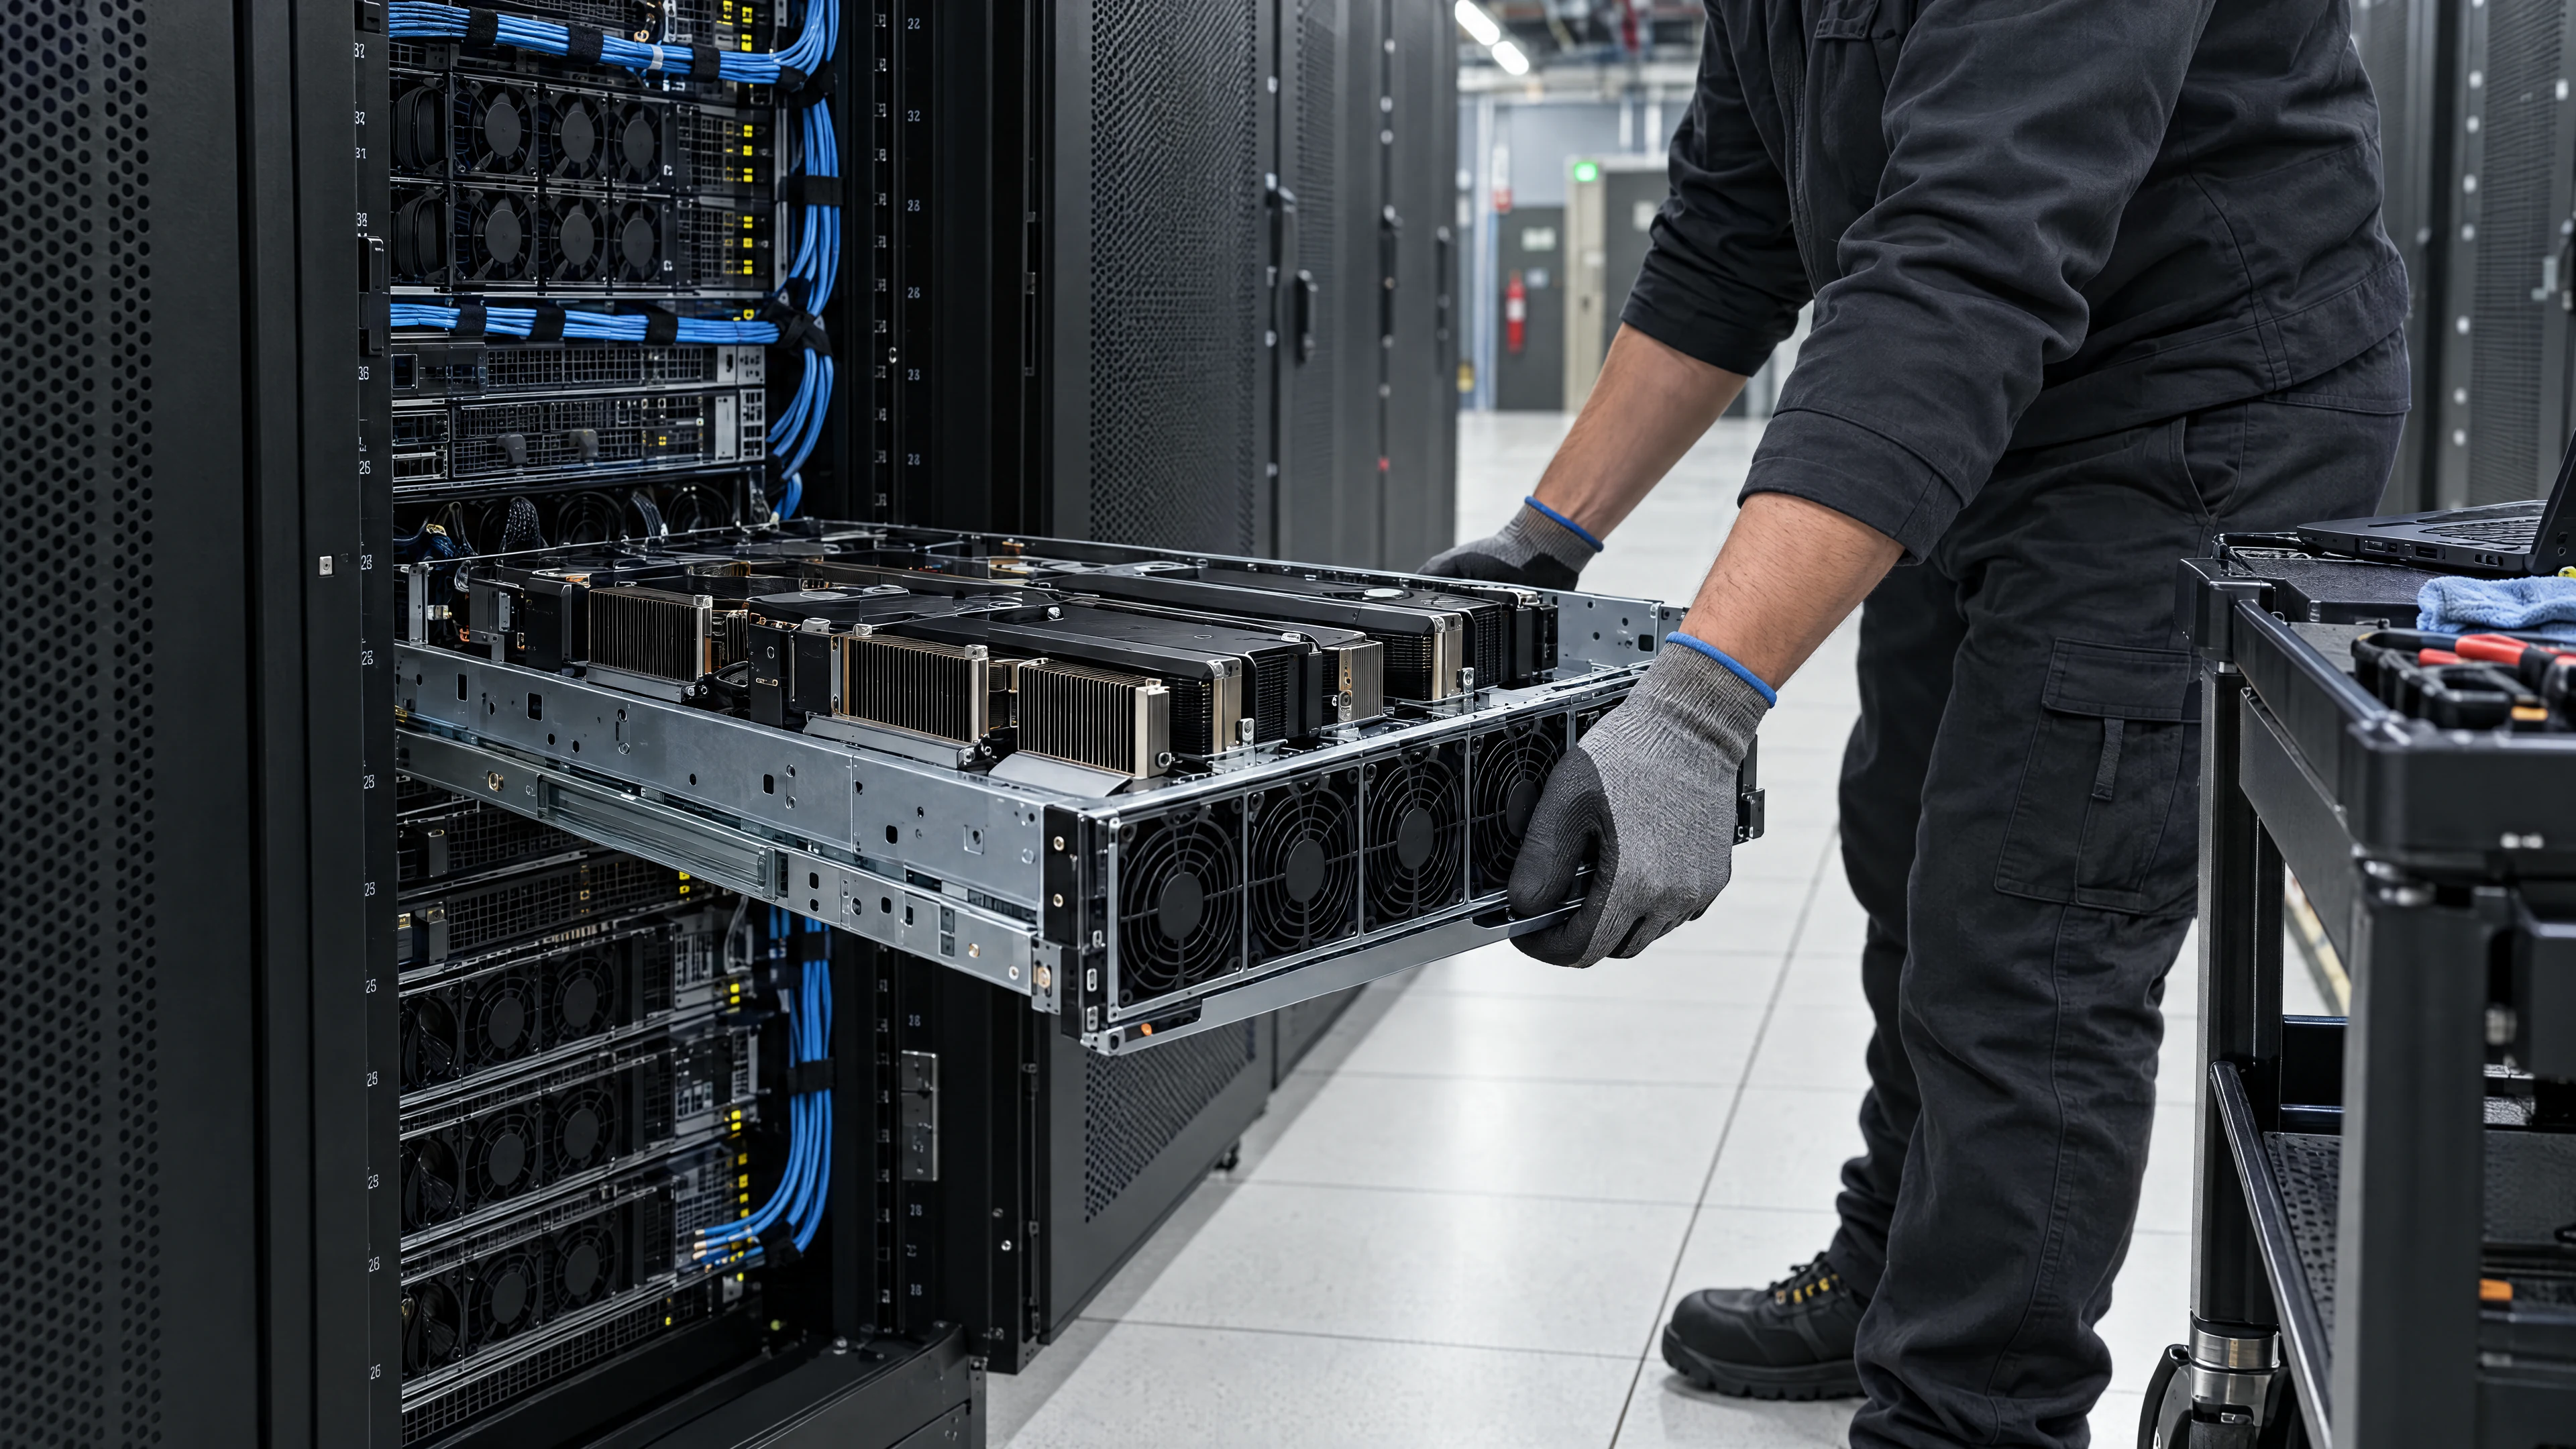
每台 HGX 节点提供专属计算资源。
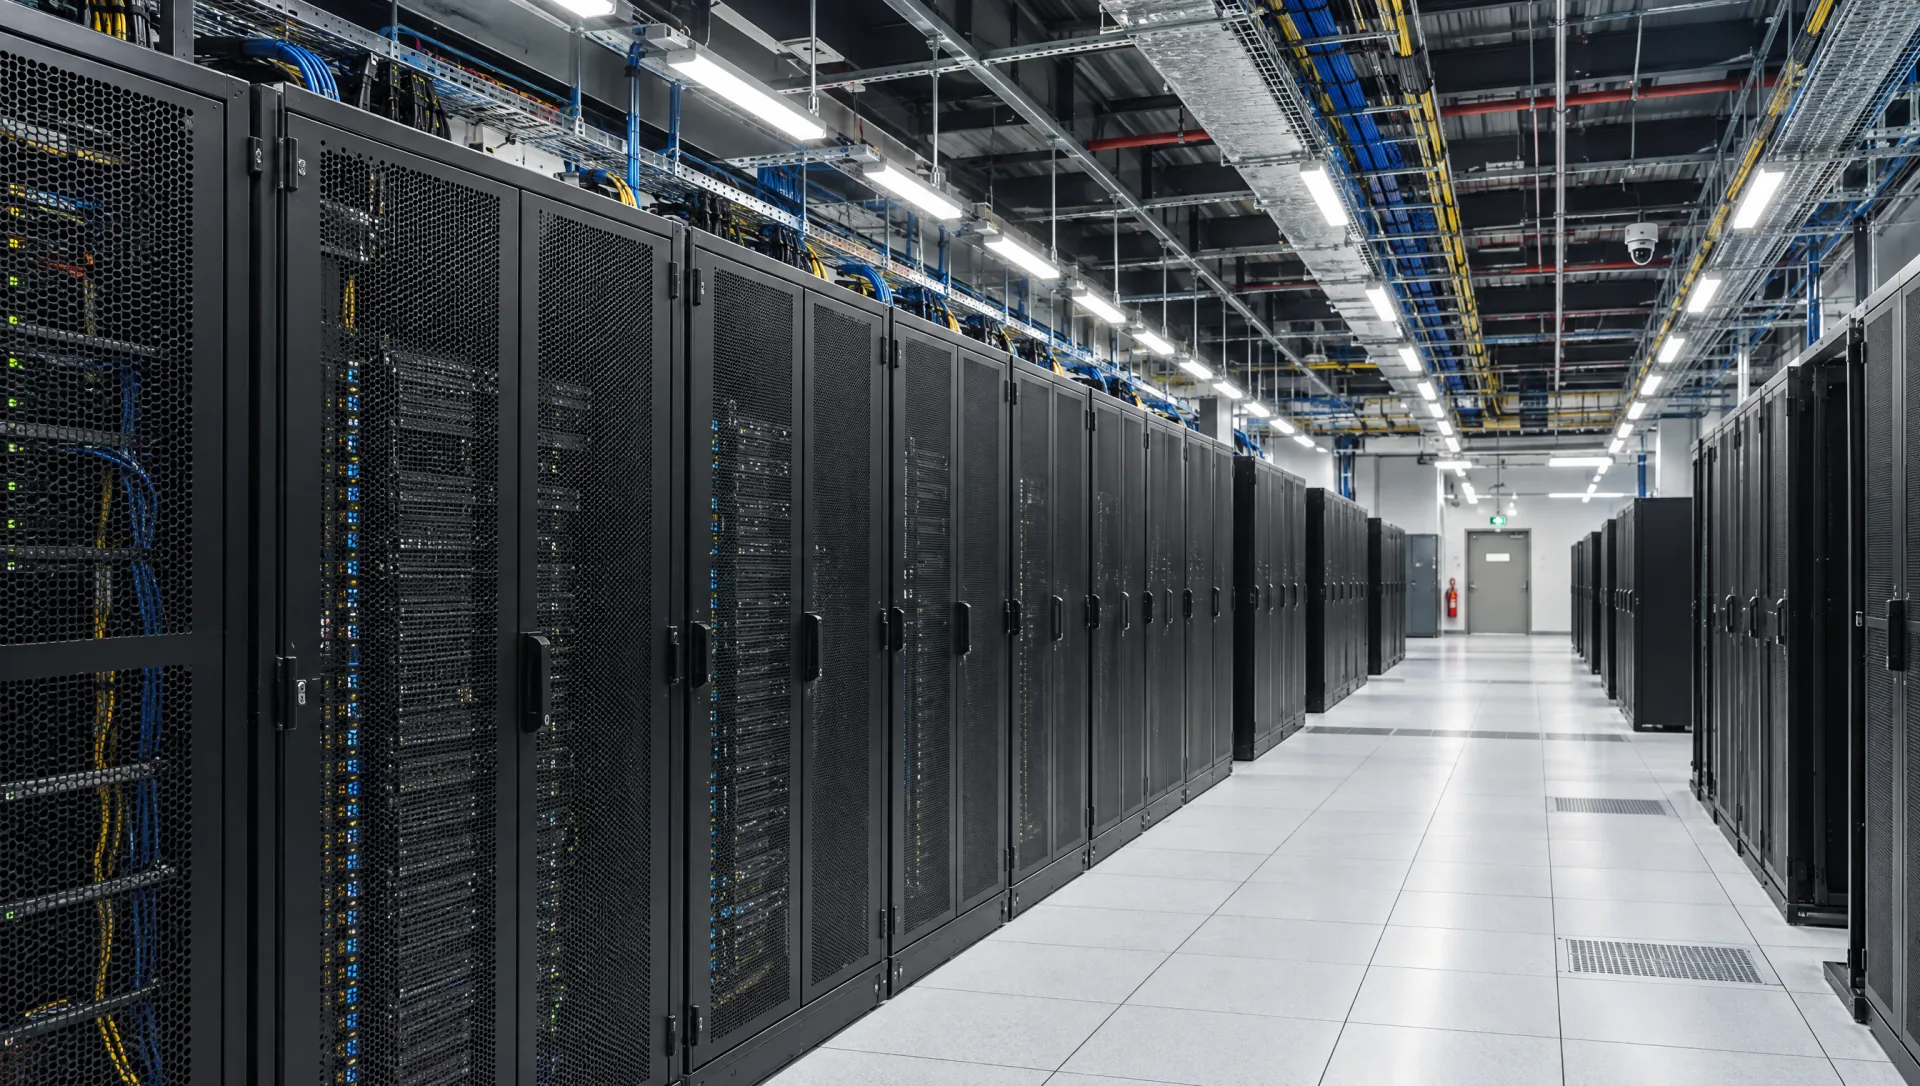
专为 AI 工作负载而建
GPU 集群始于数据中心设施。
算力表现取决于每块 GPU 周边的系统,包括机架设计、电力与制冷、网络和存储。
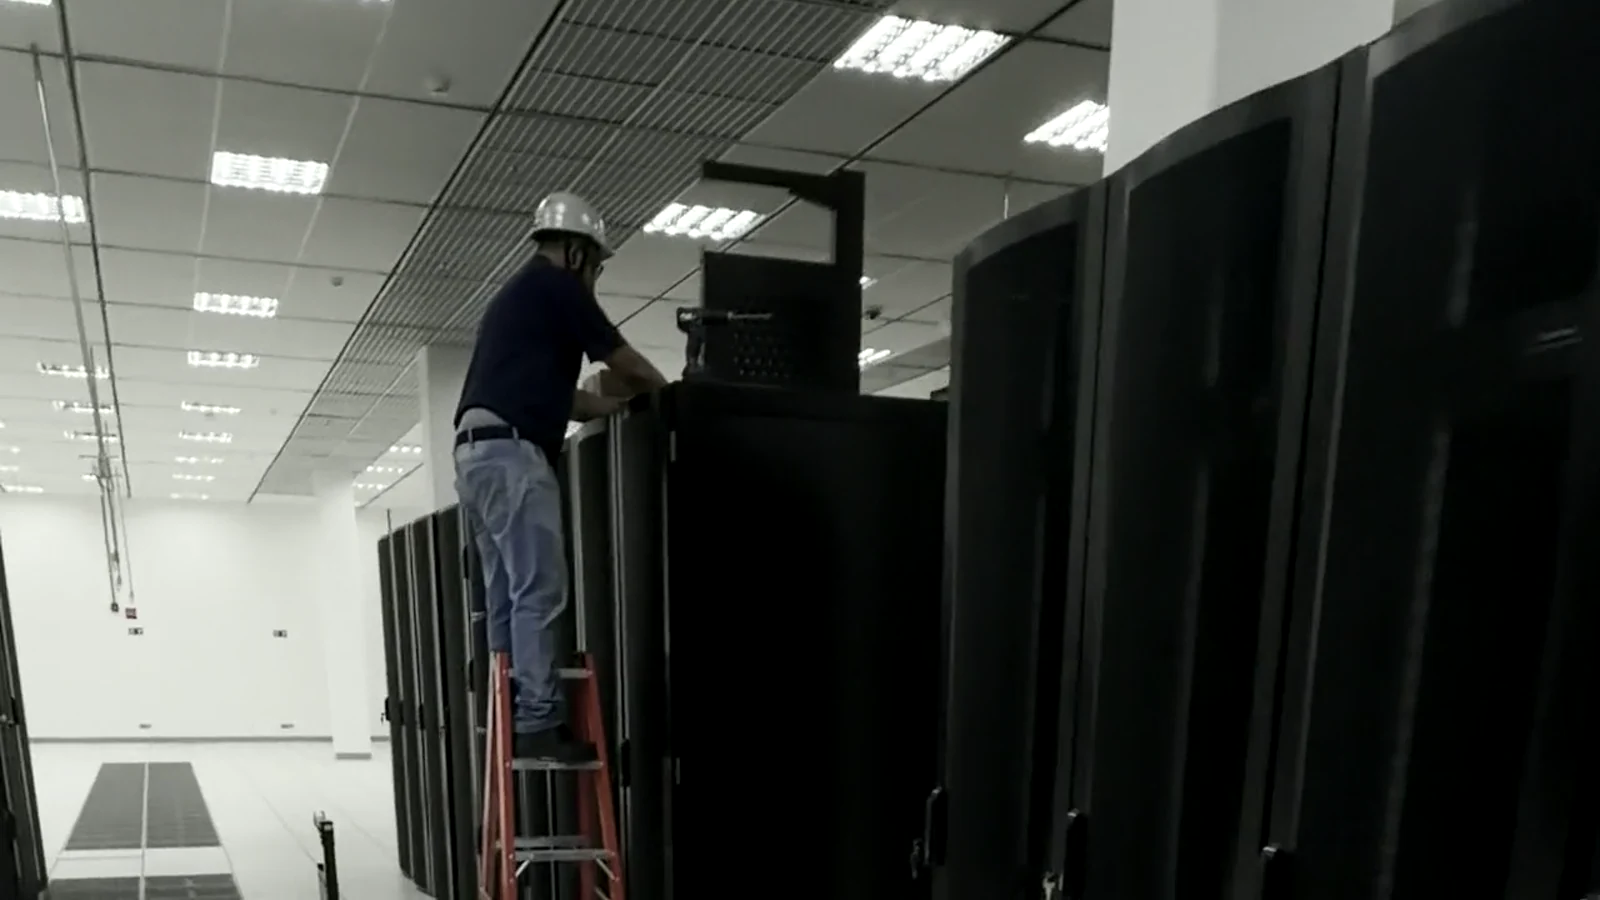
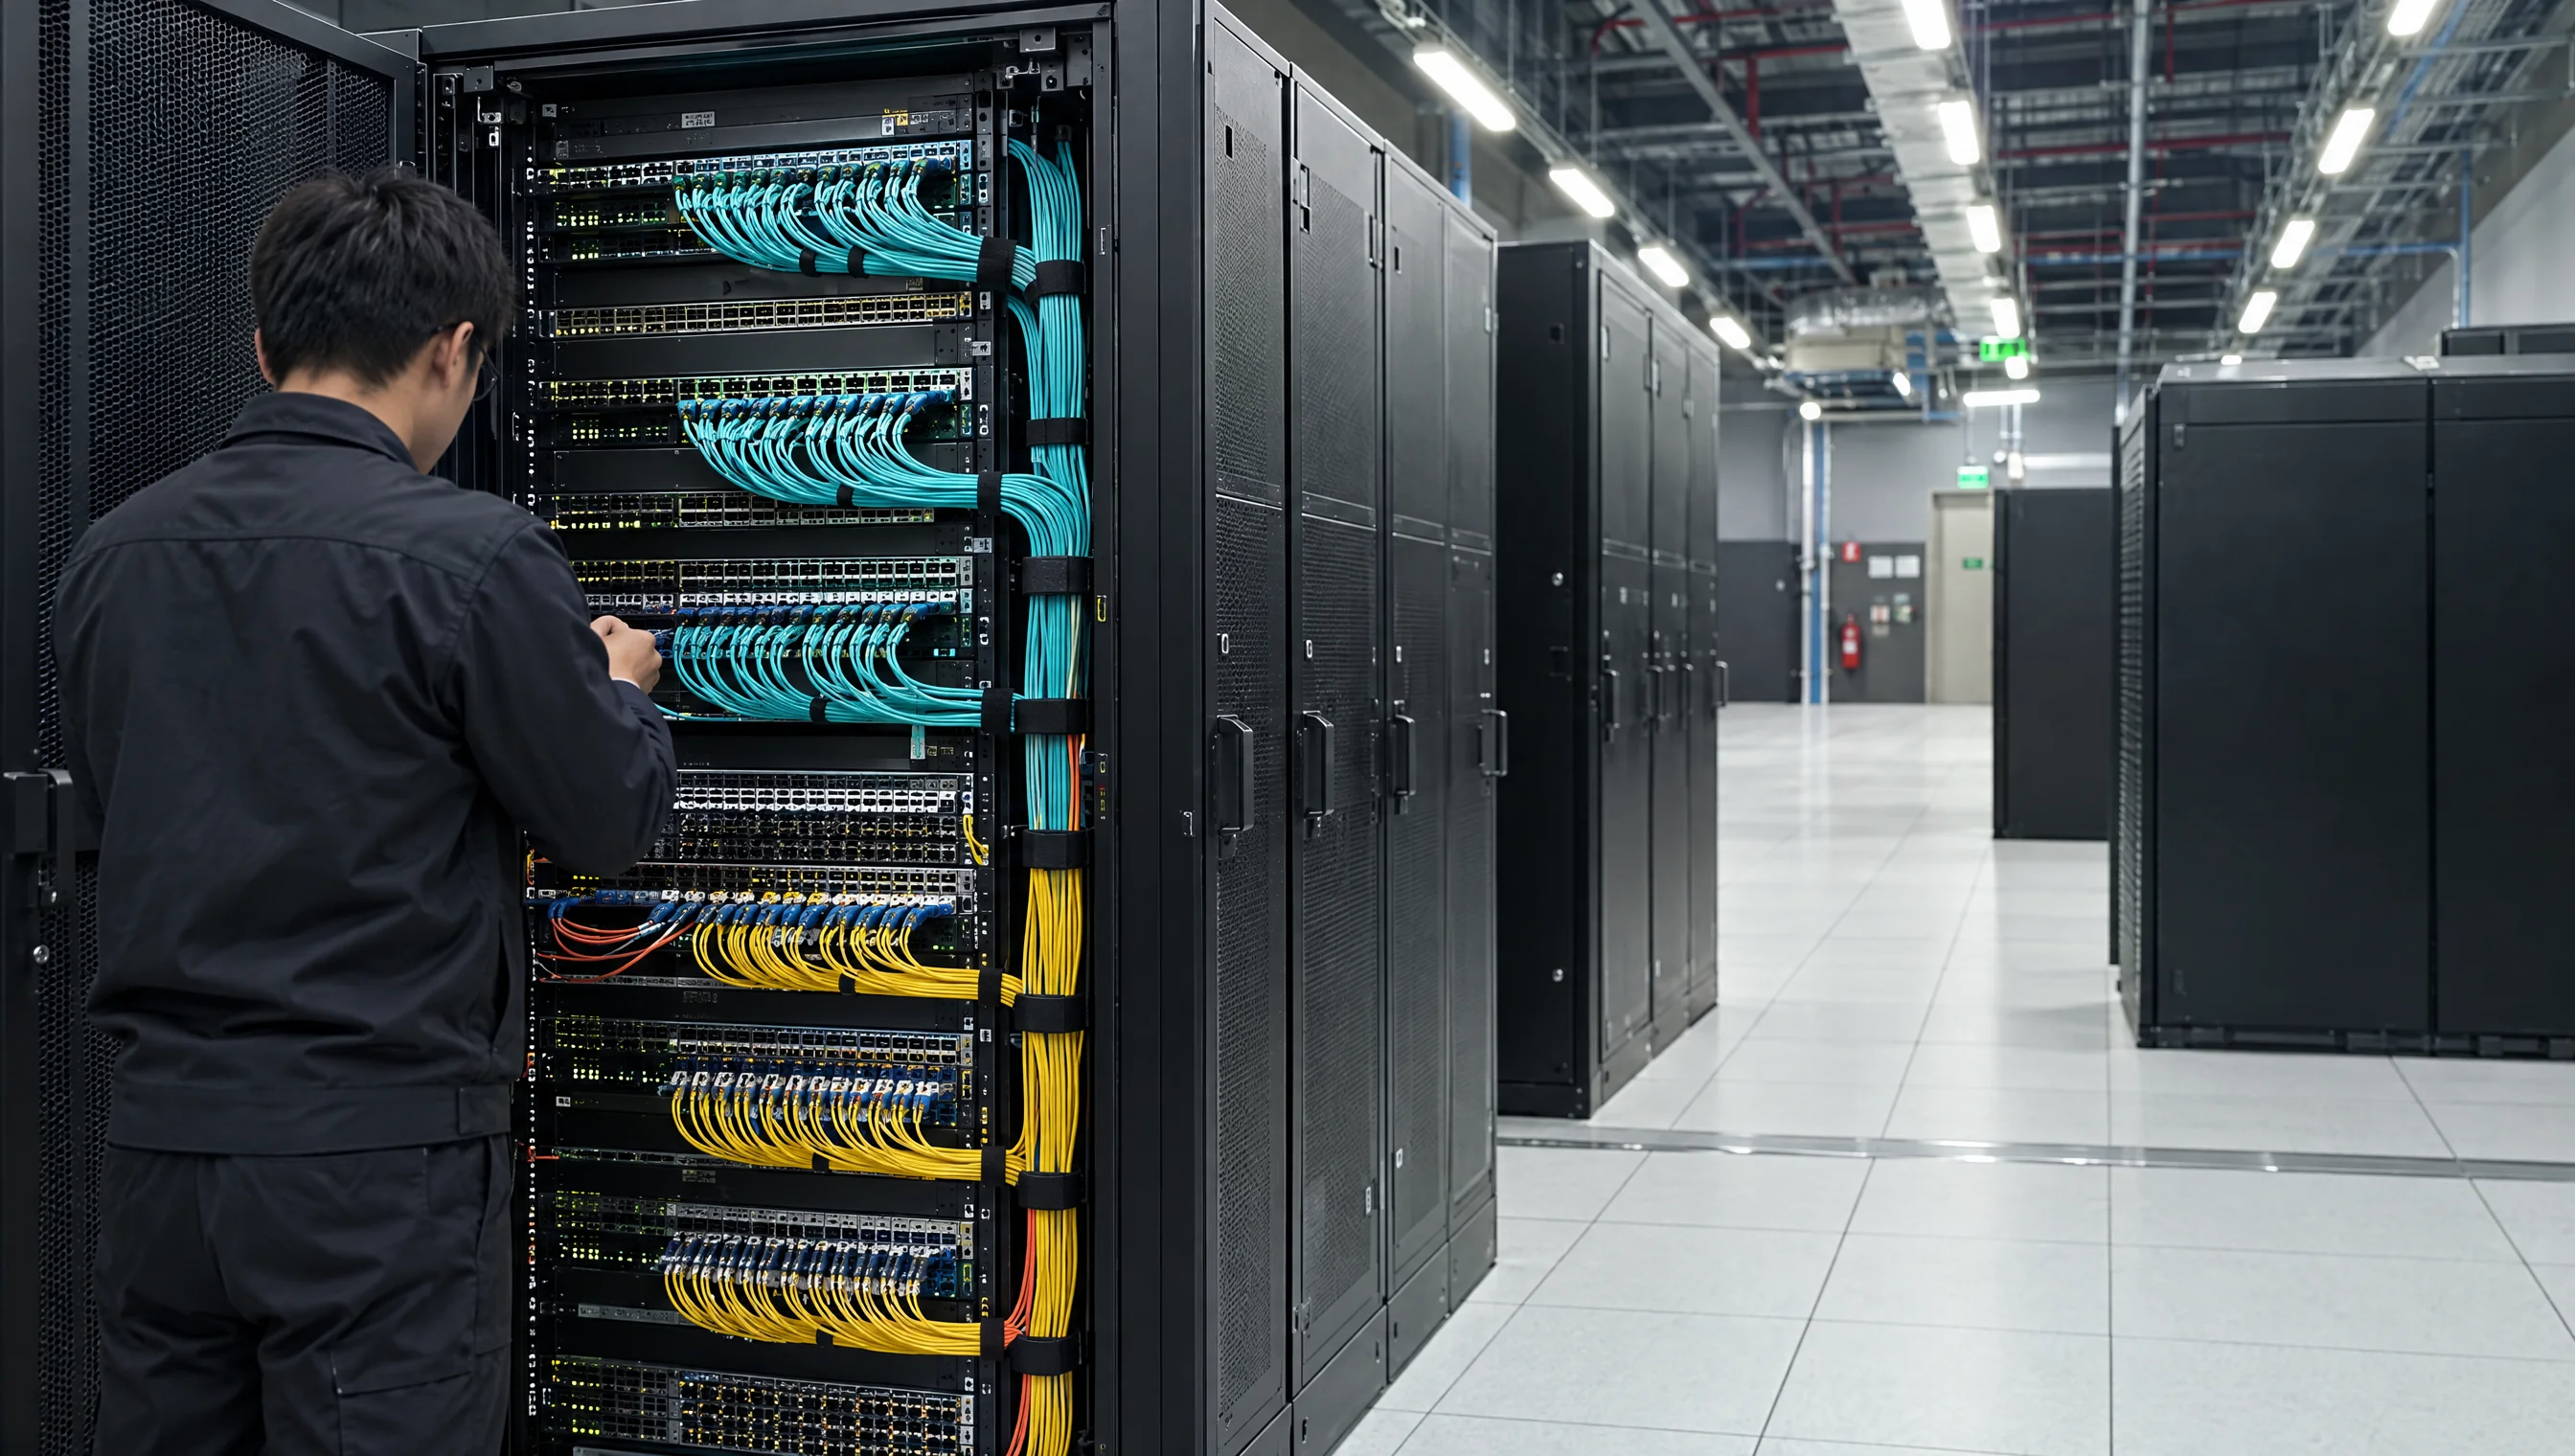
集群交付前进行系统检查。
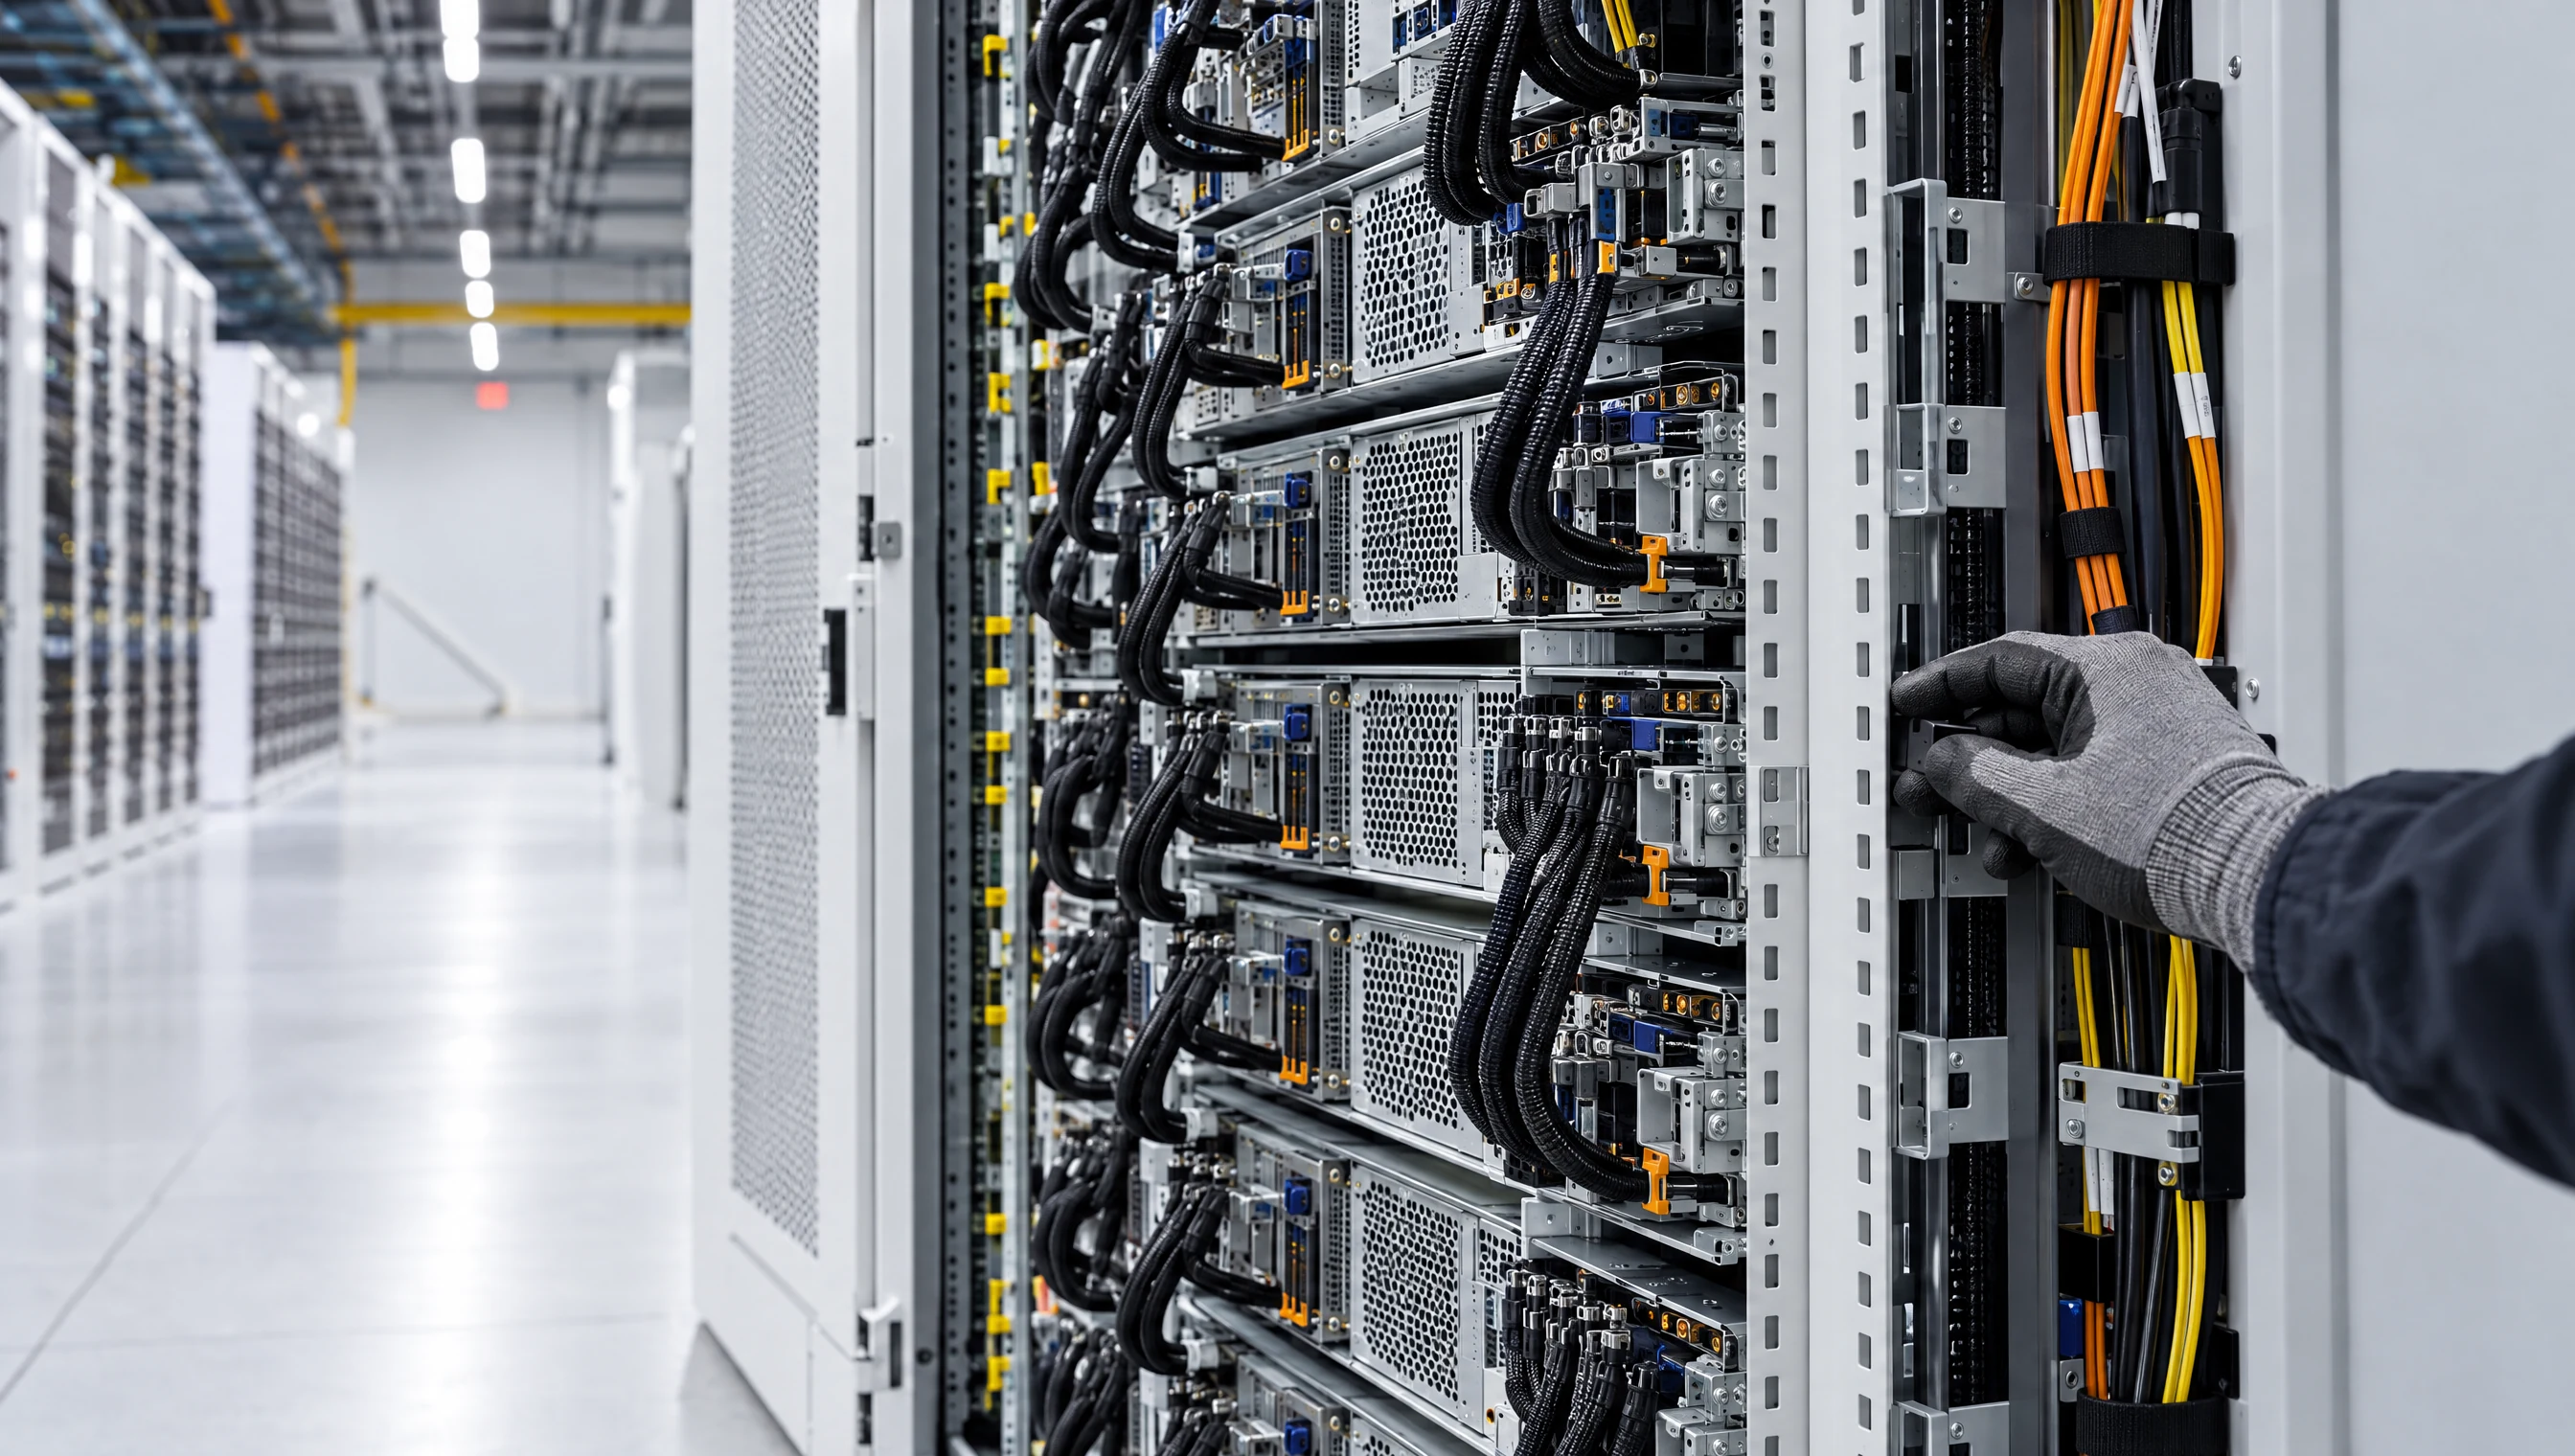
为高密度 GPU 系统规划机架供电与芯片直冷。
让 AI 工作持续推进的工程能力
把更多时间留给 AI 工作。
集群不只是服务器。TensorBay 会根据工作负载规划设施、网络和存储,并在交付前检查系统。
- 01
根据工作负载规划
GPU 系统、网络和存储配置围绕预期的训练或推理任务确定。
- 02
验证集群
每个集群都要经过 72 小时的负载、内存、网络与温度检查。
- 03
交付前共同审阅
开始工作前,您的团队可以审阅测试结果和部署配置。
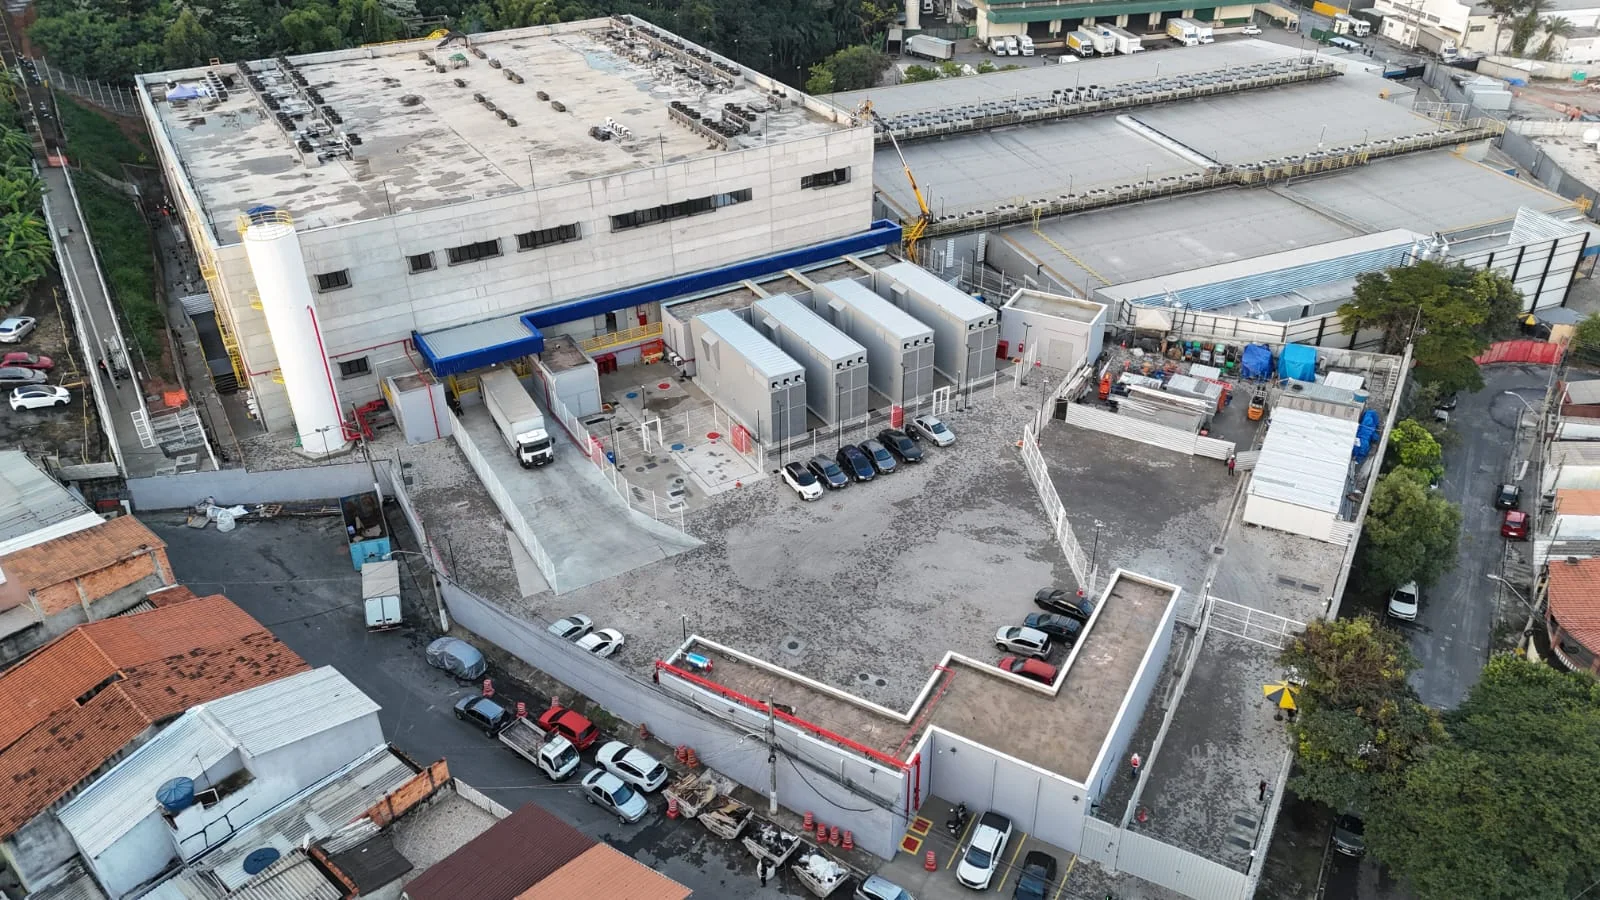
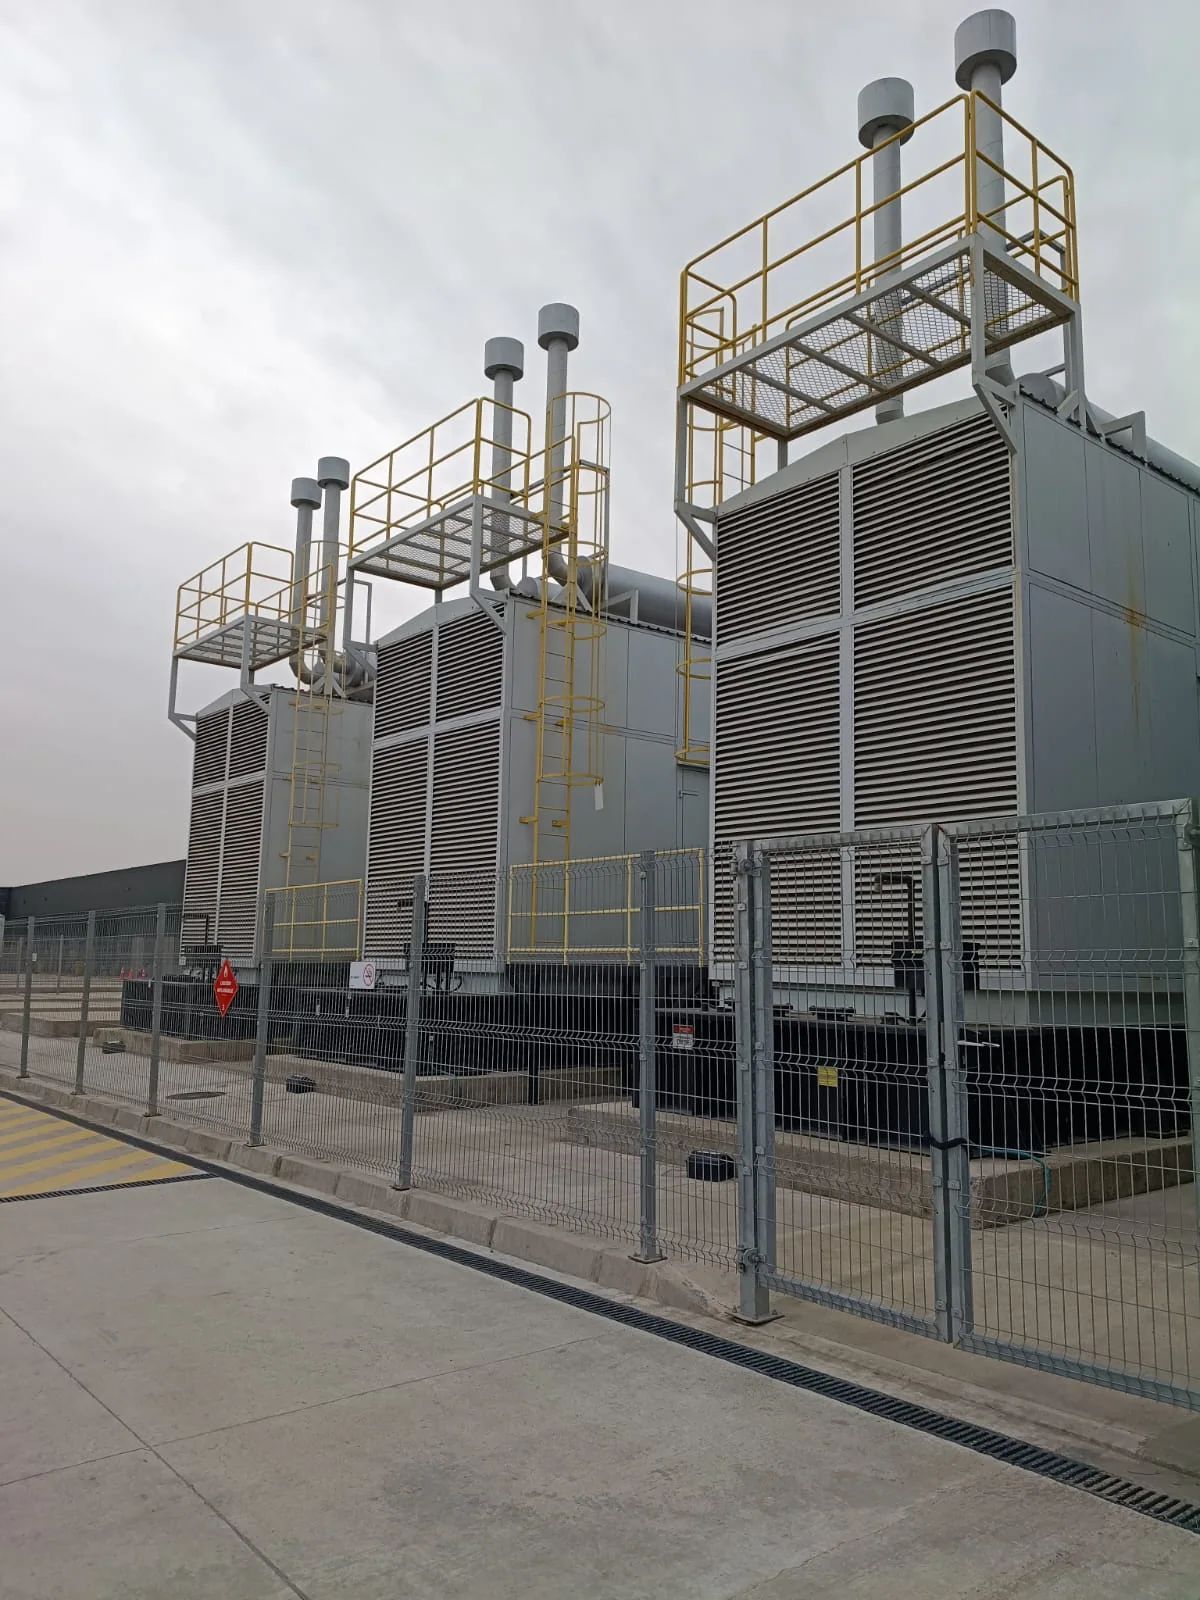
AI 数据中心站点
让基础设施助力 AI 更进一步。
TensorBay 的站点遍布五个国家。每个站点都围绕 AI 工作负载规划计算、制冷、网络与运维。
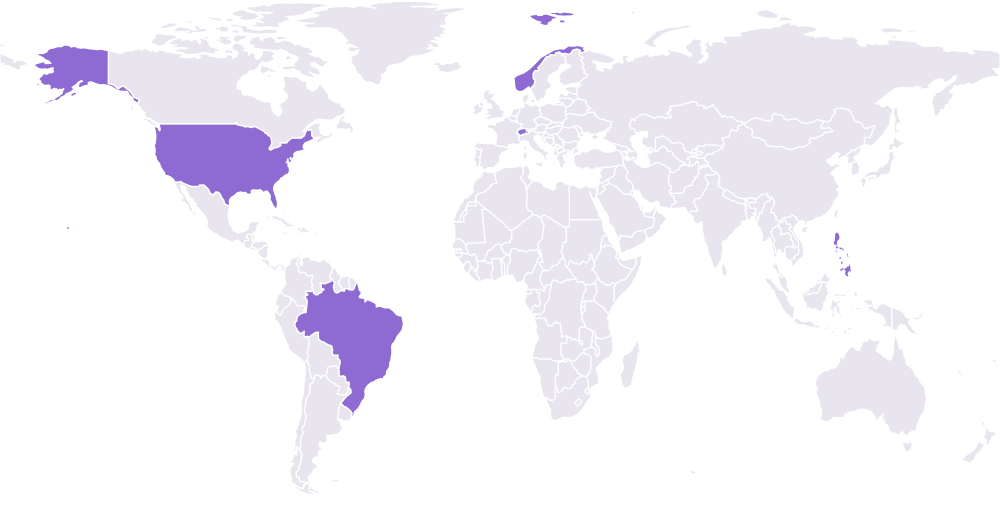
围绕您的工作负载构建的基础设施
- 01
- 02
- 03
- 04
- 05
- 06
探索基础设施
深入了解 GPU 周边的系统。
从机房设施规划到集群准备,进一步了解计算、数据路径与交付检查。
面向 AI 工作负载的数据中心需要具备什么?
AI 集群需要统筹规划计算、电力、制冷、网络与存储。TensorBay 会根据所选 GPU 配置和工作负载规划这些层级。
TensorBay 如何在交付前验证集群?
每个集群都会进行 72 小时的负载、内存、网络与温度检查。交付前,您的团队可以审阅检查结果。
GPU 系统的制冷如何规划?
制冷方案根据 GPU 配置与机架设计确定。TensorBay 基础设施采用 130 kW 机架与芯片直冷液冷系统。
网络与存储如何规划?
网络拓扑与存储会根据集群规模、数据传输和检查点需求进行规划,并在交付前结合工作负载审阅配置。
可以审阅哪些安全控制措施?
TensorBay 团队可以与您审阅部署范围内的物理访问、身份管理、数据保护及介质处理控制。
询价时需要确认哪些部署与交付信息?
请说明团队所在地区、数据存放地、目标部署地区和启动日期。具体数据中心、可交付 GPU 配置、网络访问方式和交付时间在项目方案中确认。部署前可按工作负载约定验收标准。
如何规划 Qwen、DeepSeek 或 Kimi 等模型的算力?
请提供具体模型版本、训练或推理目标与数据规模。结合显存、计算精度、上下文长度、并发和软件兼容性评估容量,再用实际工作负载验证延迟与吞吐。团队会根据项目需求核对可用配置。
GPU 租赁报价是否包含数据传输与存储?
GPU 预留费率与存储、数据传输和额外网络服务分项列出。请提供数据量、预计入站与出站流量,以及所需连接方式,并在方案中确认总费用、计费单位与税费。页面标价为美元,不是人民币。
08让创意拥有成长空间
为下一次 AI 任务规划基础设施。
告诉我们您的模型、算力需求和时间安排。我们将协助规划 GPU 系统及其配套基础设施。
- 围绕项目定制的配置
- 包含交付时间的方案
- 启用前的验收测试