
每台 HGX 节点配备专属算力。
让团队安心推进的关键细节
集群交付前进行系统测试。
节点更换服务时限。
部分 Blackwell 系统支持 InfiniBand XDR 链路。
使用 TensorBay 的团队
助力团队将 AI 转化为业务价值。
- Bank of America
- Halliburton
- BRF
- PicPay
- BMG Bank
- City of Rio de Janeiro
- CNSesi
- AICUBE
- AirCloud
围绕实际工作打造
减少搭建基础设施的时间,让模型更快向前发展。
专属集群将工作负载依赖的资源纳入统一规划,涵盖 GPU 算力、验收测试与预留条款。
- 01
专属算力
算力专注于你的项目
使用专属 GPU 硬件,节点算力为项目预留,满足模型训练、微调或推理需求。 - 02
交付前可查看测试
从完整测试结果开始
集群交付前完成负载、内存、网络和温度测试,团队可查看相关结果。 - 03
清晰的预留方案
决策前了解成本与条款
比较已公布的 GPU 价格与预留条款,再根据模型和项目周期确定配置。
为数据流动而设计
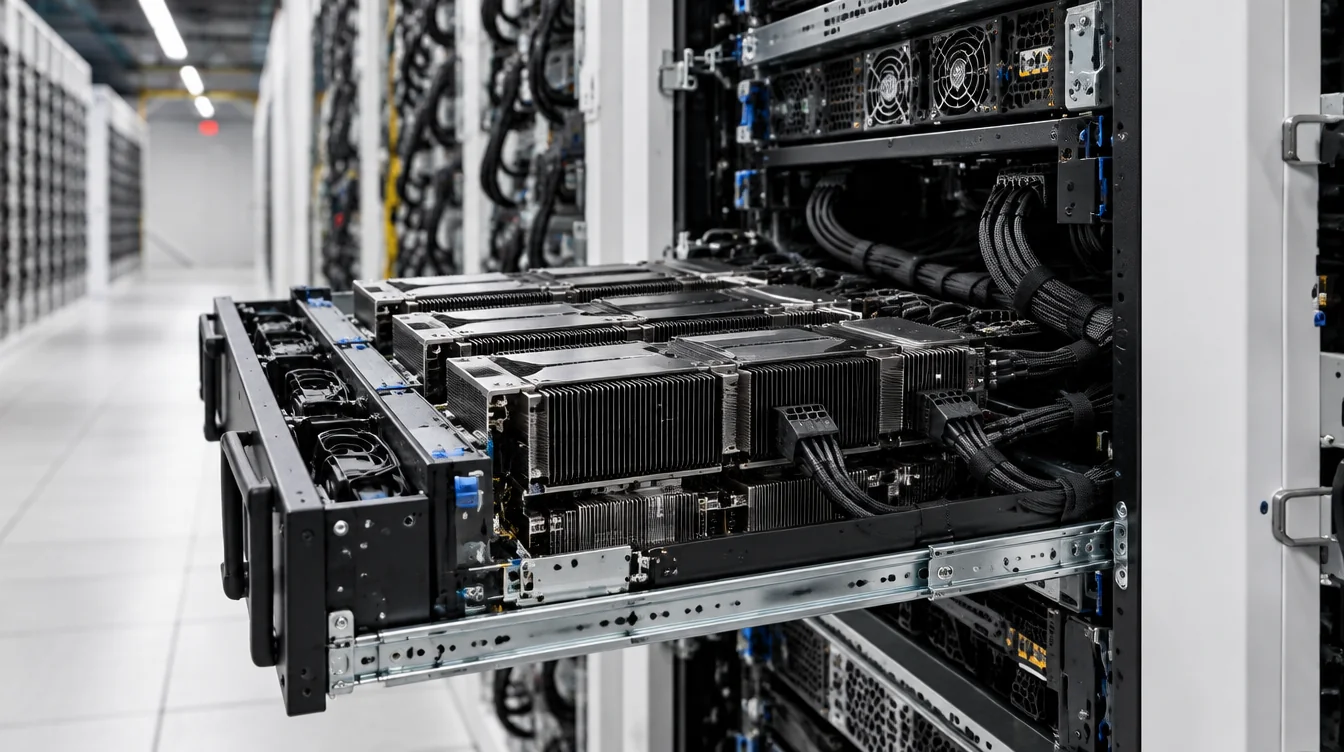
让 GPU 作为一个系统协同工作。
整体性能取决于网络、存储和设施能否跟上计算需求。根据工作负载规划完整的数据路径,再选择合适的配置。
- BLACKWELL 互连最高 800 Gb/s
部分 Blackwell 配置支持 Quantum-X800 XDR InfiniBand 链路。
- 本地存储最高 30 TB
部分 HGX 节点配备 NVMe,具体以配置为准。
- 交付前测试72 小时
测试负载、内存、网络和温度,并提供结果供团队查看。
从首次沟通到首次运行
从构想到基础设施,路径清晰可见。
- 01
梳理工作负载
明确模型、GPU 显存、节点数量、数据、互连和启动时间。
- 02
规划基础设施架构
确定节点或机架规模、网络、存储、预留条款和交付时间。
- 03
交付前完成验证
集群交付前,团队可查看负载、内存、网络和温度测试结果。
- 04
明确扩展路径
与熟悉基础设施的团队讨论集群进展和下一步算力规划。
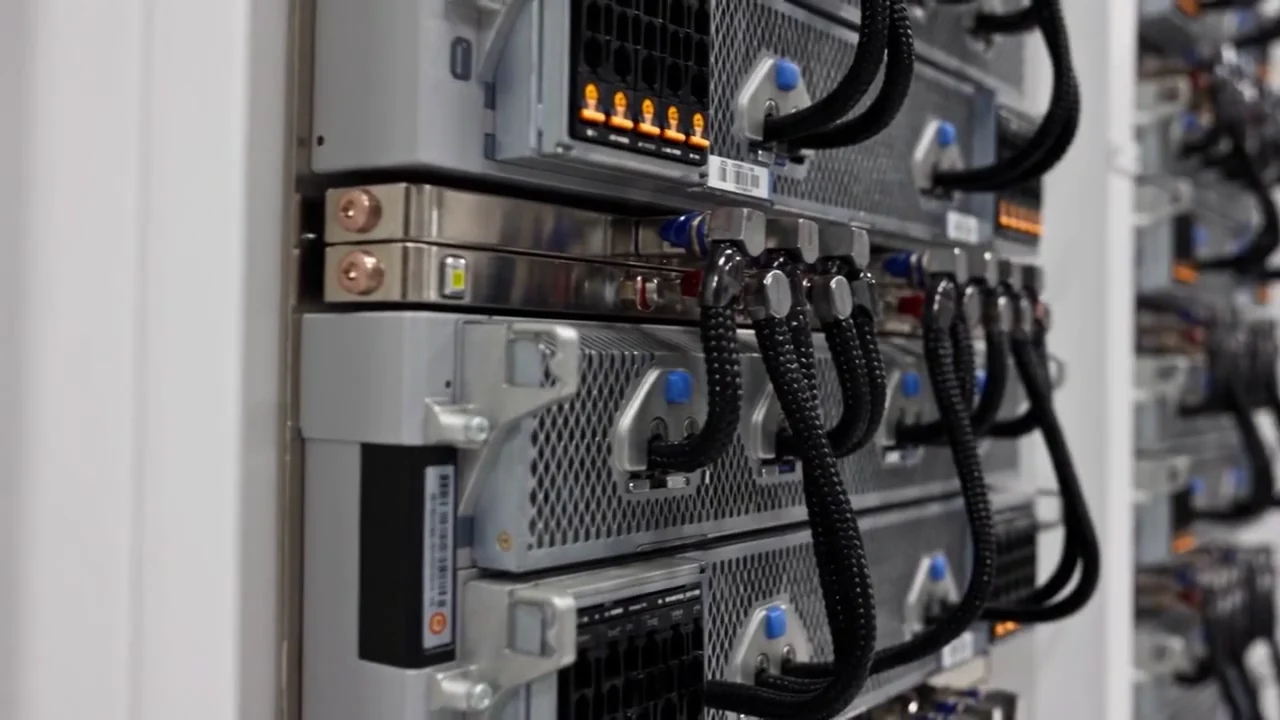
交付前完成测试
从一套值得信赖的集群开始。
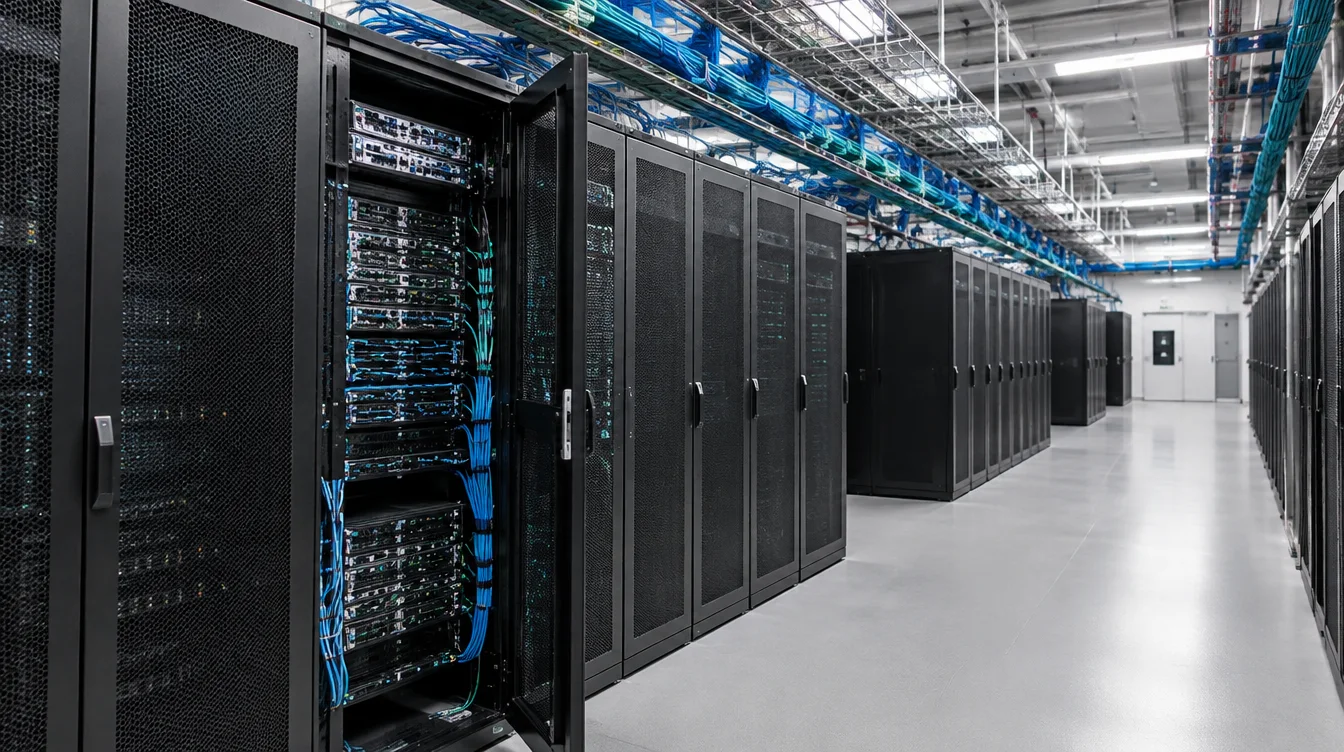
每套集群都会经过 72 小时的负载、内存、网络和温度测试。团队可在确认交付前查看测试结果。
72h
交付验收测试
负载 · 内存 · 网络 · 温度检查
AI 工作负载
- TENSORBAY AIFACTORY模型训练专属 GPU 算力与高速网络,支持长时间训练任务。
- TENSORBAY AIFACTORY微调与研究8-GPU 节点支持模型适配与实验迭代。
- TENSORBAY AIFACTORY生产推理高显存系统为专属基础设施上的模型服务提供算力。
07安心向前
你的创新,值得可靠的安全保障。
专属硬件、物理隔离与访问控制,支持项目走向生产。从第一个节点开始,安全就是基础设施的一部分。
SOC 2 Type II
范围:裸金属计算、网络与托管存储
ISO 27001:2022
所有数据中心站点均已认证
HIPAA
专属集群可提供业务伙伴协议(BAA)
GDPR
欧盟区域提供所在国数据驻留
- 硬件、网络与存储在物理层面专属于你的业务
- 静态数据加密,硬件释放时安全擦除数据
- 退役存储介质按认证流程销毁
- 企业身份登录、硬件密钥认证与不可变审计日志
- 通过 trust.tensorbay.com 查看认证范围与报告
GPU 价格按单块 GPU 还是按节点收费?
公布的 HGX 价格以美元计,按月度或年度预留合约中的完整 8 GPU 节点每小时收费。NVL72 系统按机架报价,价格不含税。
AI 项目应该选择哪款 NVIDIA GPU?
请比较显存容量、网络需求,以及训练或推理工作负载。硬件页面提供 B300、B200、H200、H100 与整机架系统。团队可根据模型、数据集与算力需求协助规划配置。
专属集群能用于训练、微调和推理吗?
可以。TensorBay 提供用于模型训练、微调和推理的专属 NVIDIA GPU 基础设施。你可以使用 Slurm、Kubernetes 或 SSH,并根据工作负载配置软件环境。
申请报价之后会发生什么?
提供所需 GPU、容量与预留期限,或介绍项目需求。团队将在评估后于 48 小时内准备方案,包括配置与交付时间,最终容量和条款在方案中确认。
询价时需要确认哪些部署与交付信息?
请说明团队所在地区、数据存放地、目标部署地区和启动日期。具体数据中心、可交付 GPU 配置、网络访问方式和交付时间在项目方案中确认。部署前可按工作负载约定验收标准。
如何规划 Qwen、DeepSeek 或 Kimi 等模型的算力?
请提供具体模型版本、训练或推理目标与数据规模。结合显存、计算精度、上下文长度、并发和软件兼容性评估容量,再用实际工作负载验证延迟与吞吐。团队会根据项目需求核对可用配置。
GPU 租赁报价是否包含数据传输与存储?
GPU 预留费率与存储、数据传输和额外网络服务分项列出。请提供数据量、预计入站与出站流量,以及所需连接方式,并在方案中确认总费用、计费单位与税费。页面标价为美元,不是人民币。
08让创意拥有成长空间
为 AI 项目的下一步制定清晰计划。
告诉我们你的模型、算力目标和项目周期。我们将协助规划 GPU 配置和交付准备步骤。
- 围绕项目定制的配置
- 包含交付时间的方案
- 启用前的验收测试