Modelo e dados
Escolha o modelo, prepare os dados e defina o contexto e a resposta necessários para a aplicação.
A TOKEN FACTORY DA TENSORBAY
Do treinamento de modelos à inferência em produção, a TensorBay AIFactory reúne sistemas GPU, rede, armazenamento, energia, refrigeração e operação para planejar a geração e o uso de tokens de IA.
DO MODELO À PRODUÇÃO
Tokens de IA são gerados quando um modelo processa uma entrada e produz uma resposta. Cada carga depende de um sistema conectado, não de um componente isolado.
Escolha o modelo, prepare os dados e defina o contexto e a resposta necessários para a aplicação.
A memória, a arquitetura e a escala do cluster influenciam a capacidade disponível para treinamento e inferência.
Mova pesos do modelo, prompts e dados entre os sistemas que precisam deles.
As aplicações enviam entradas e recebem respostas do modelo. O contexto, o tamanho da resposta e a demanda mudam a carga.
SERVIDORES GPU NO CENTRO
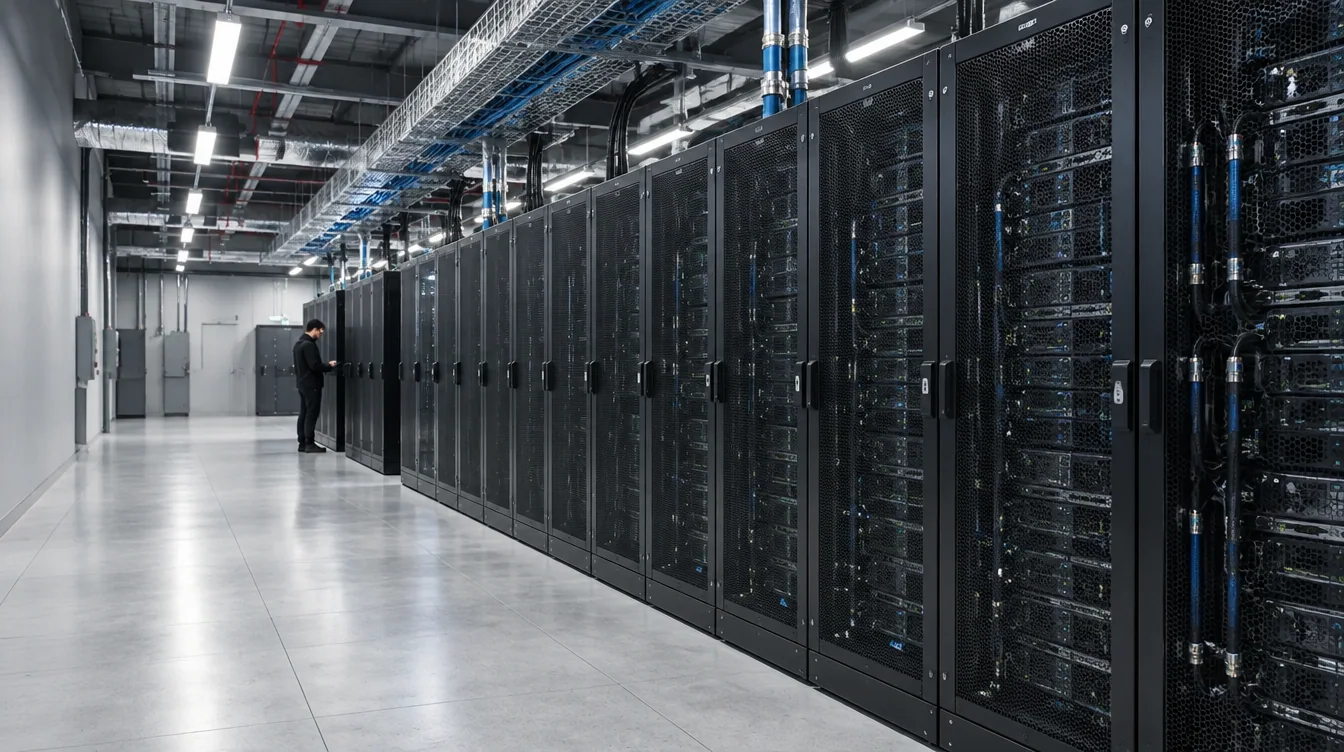
As GPUs executam cargas de treinamento e inferência. Energia e refrigeração sustentam os racks, enquanto rede e armazenamento mantêm modelos e dados ao alcance. Sua equipe opera modelos e aplicações na pilha de software que escolher.
COMPUTAÇÃO GPUTOKENOMICS
A quantidade de tokens e o custo da carga dependem do comportamento do modelo, da infraestrutura, da utilização e da demanda da aplicação. Planejar esses fatores em conjunto ajuda a entender a economia da operação.
Não existe um único custo por token que sirva para todos os modelos, prompts e ambientes. Avalie a carga inteira e relacione a capacidade e o prazo da reserva ao uso esperado.
A arquitetura do modelo, o tamanho da entrada, o contexto e a resposta influenciam a necessidade de computação.
Memória e capacidade de processamento ajudam a definir quais modelos e tamanhos de carga o sistema comporta.
A frequência de uso orienta o planejamento da capacidade reservada e das janelas de operação.
Padrões de tráfego, metas de resposta e picos de uso ajudam a dimensionar a capacidade necessária.
PLANEJE O PRÓXIMO PASSO
Tokenomics é a economia da geração e do uso de tokens de IA. O conceito reúne comportamento do modelo, capacidade de computação, utilização e demanda da aplicação, em vez de tratar tokens como uma métrica isolada de infraestrutura.
A TensorBay oferece infraestrutura GPU para cargas de IA. Sua equipe executa modelos e aplicações na pilha de software que escolher.
A escolha do modelo, o tamanho do contexto, a arquitetura e a memória da GPU, a utilização, os caminhos de rede e armazenamento e a demanda da aplicação afetam a carga.
Sistemas GPU dedicados podem ser planejados para treinamento de modelos, fine-tuning, pesquisa e inferência em produção. A configuração adequada depende da carga e do plano de entrega.
08Vamos dar escala à sua ideia
Conte sobre seus modelos, cargas de tokens, capacidade necessária e prazo. Podemos ajudar a definir um próximo passo viável.