Modelo y datos
Elige el modelo, prepara los datos y define el contexto y la respuesta que necesita tu aplicación.
LA TOKEN FACTORY DE TENSORBAY
Desde el entrenamiento de modelos hasta la inferencia en producción, TensorBay AIFactory reúne sistemas GPU, redes, almacenamiento, energía, refrigeración y operaciones para planificar la generación y el uso de tokens de IA.
DEL MODELO A PRODUCCIÓN
Los tokens de IA se generan cuando un modelo procesa una entrada y produce una respuesta. Cada carga depende de un sistema conectado, no de un componente aislado.
Elige el modelo, prepara los datos y define el contexto y la respuesta que necesita tu aplicación.
La memoria, la arquitectura y la escala del clúster influyen en la capacidad para entrenamiento e inferencia.
Mueve los pesos del modelo, las instrucciones y los datos entre los sistemas que los necesitan.
Las aplicaciones envían entradas y reciben resultados del modelo. El contexto, el tamaño de respuesta y la demanda cambian la carga.
SERVIDORES GPU EN EL CENTRO
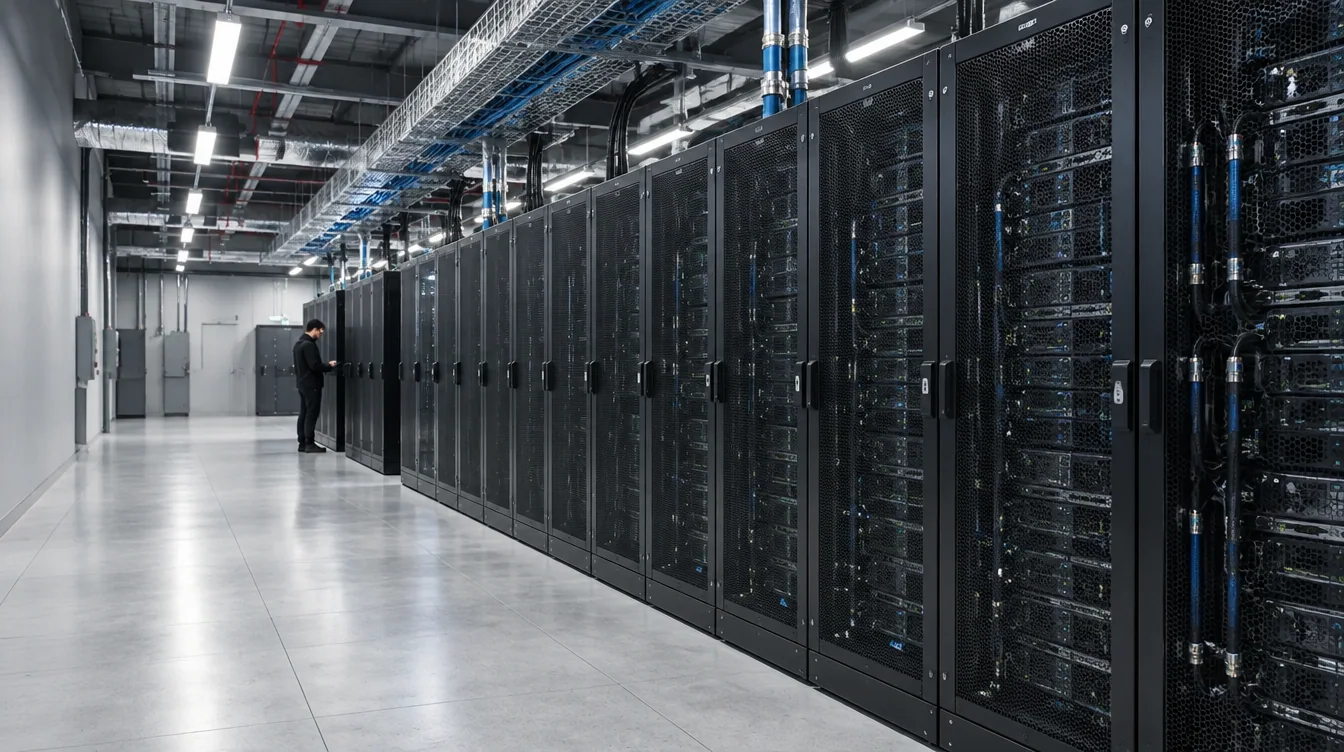
Las GPU ejecutan cargas de entrenamiento e inferencia. La energía y la refrigeración sostienen los racks, mientras que las redes y el almacenamiento mantienen modelos y datos disponibles. Tu equipo opera sus modelos y aplicaciones en la pila de software que elija.
CÓMPUTO GPUTOKENOMICS
La cantidad de tokens y el costo de una carga dependen del modelo, la infraestructura, la utilización y la demanda de la aplicación. Planificar estos factores en conjunto ayuda a entender la economía de producción.
No existe un costo por token único para todos los modelos, instrucciones o entornos. Evalúa la carga completa y relaciona la capacidad y el plazo de reserva con el uso previsto.
La arquitectura del modelo, el tamaño de entrada, el contexto y la respuesta influyen en los requisitos de cómputo.
La memoria y la capacidad de cómputo ayudan a definir qué modelos y tamaños de carga admite un sistema.
La frecuencia de uso orienta la planificación de capacidad reservada y de las ventanas operativas.
Los patrones de tráfico, los objetivos de respuesta y los picos de uso ayudan a dimensionar la capacidad.
PLANIFICA EL SIGUIENTE PASO
Tokenomics describe la economía de generar y usar tokens de IA. Reúne el comportamiento del modelo, la capacidad de cómputo, la utilización y la demanda de la aplicación, en lugar de tratar los tokens como una métrica de infraestructura aislada.
TensorBay ofrece infraestructura GPU para cargas de IA. Tu equipo ejecuta sus modelos y aplicaciones en la pila de software que elija.
La selección del modelo, el contexto, la arquitectura y memoria GPU, la utilización, las rutas de red y almacenamiento, y la demanda de la aplicación influyen en la carga.
Los sistemas GPU dedicados se pueden planificar para entrenamiento, ajuste fino, investigación e inferencia en producción. La configuración adecuada depende de la carga y del plan de entrega.
08Demos escala a tu idea
Cuéntanos sobre tus modelos, cargas de tokens, necesidades de capacidad y plazos. Podemos ayudarte a definir el siguiente paso.